规格参数与使用规范
5月15日凌晨,一年一度的“科技界春晚”Google I/O开发者大会正式开幕,长达110分钟的主Keynote提及了121次人工智能,谷歌展示了诸多令人惊叹的AI技术。
谷歌DeepMind首席执行官哈萨比斯亲自登场,介绍了名为Project Astra的AI助手。Project Astra不仅可以通过摄像头流畅地与人类交流,还能直接帮助读代码。
谷歌还推出了新的视频生成模型Veo,能够生成超过60秒的长视频,直接对标OpenAI的Sora。
此外,谷歌还宣布了Gemini 1.5 Pro的升级,增加了上下文窗口长度至200万token,可读取1500页的PDF。
谷歌CEO桑达尔・皮查伊表示,这些突破性的功能将应用于搜索、图片、生产力工具、安卓系统等多个领域,全面提升用户体验。
谷歌还展示了如何将Gemini技术融入到搜索功能中。新的AI Overview将通过多步骤推理为用户代办一切,彻底改变搜索的形态。
在Google I/O大会上,Google DeepMind首席执行官哈萨比斯揭开了Project Astra的神秘面纱。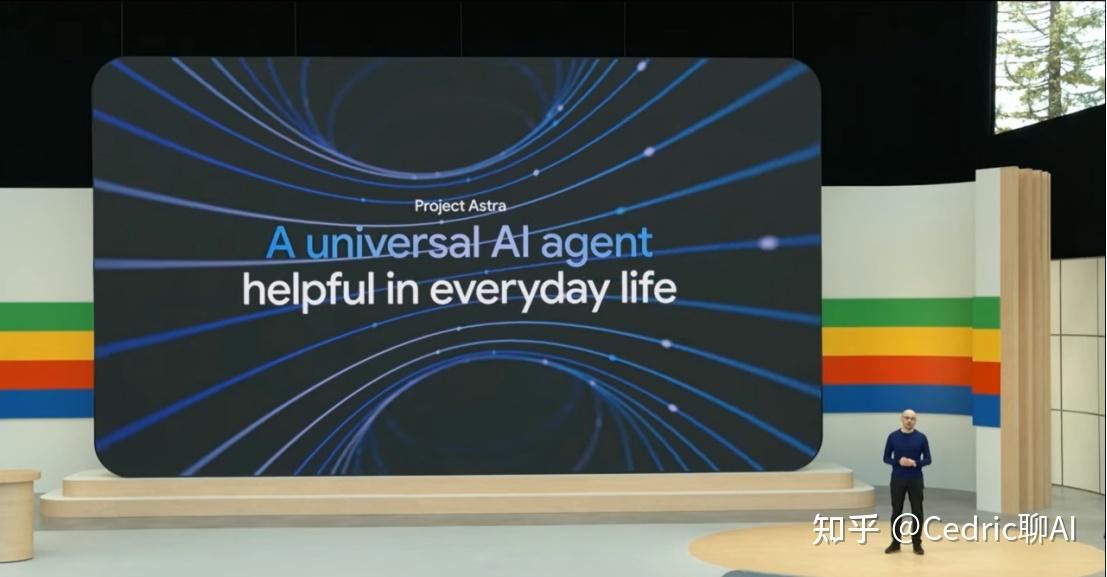
这个基于Gemini系列模型打造的AI助手,旨在成为日常生活中的得力帮手,不仅能够完成找眼镜等简单任务,还能进行文艺创作和解答专业书籍中的疑难问题。
谷歌展示了一段与Astra互动的实时视频,展示了其强大的视觉和语音识别能力。
例如,Astra能够识别出扬声器并描述其高音单元的功能,还能对彩色蜡笔进行生动的创意描述。
Astra甚至可以通过摄像头直接阅读和理解代码,并准确描述代码的功能和用途。
测试者让Astra识别街区位置,Astra迅速回应道:“这似乎是伦敦国王十字区,这里以火车站和交通枢纽而闻名。”
此外,当测试者询问其眼镜的位置时,Astra通过回忆视觉记忆,准确地指出眼镜在桌子上,并且旁边有一个红苹果。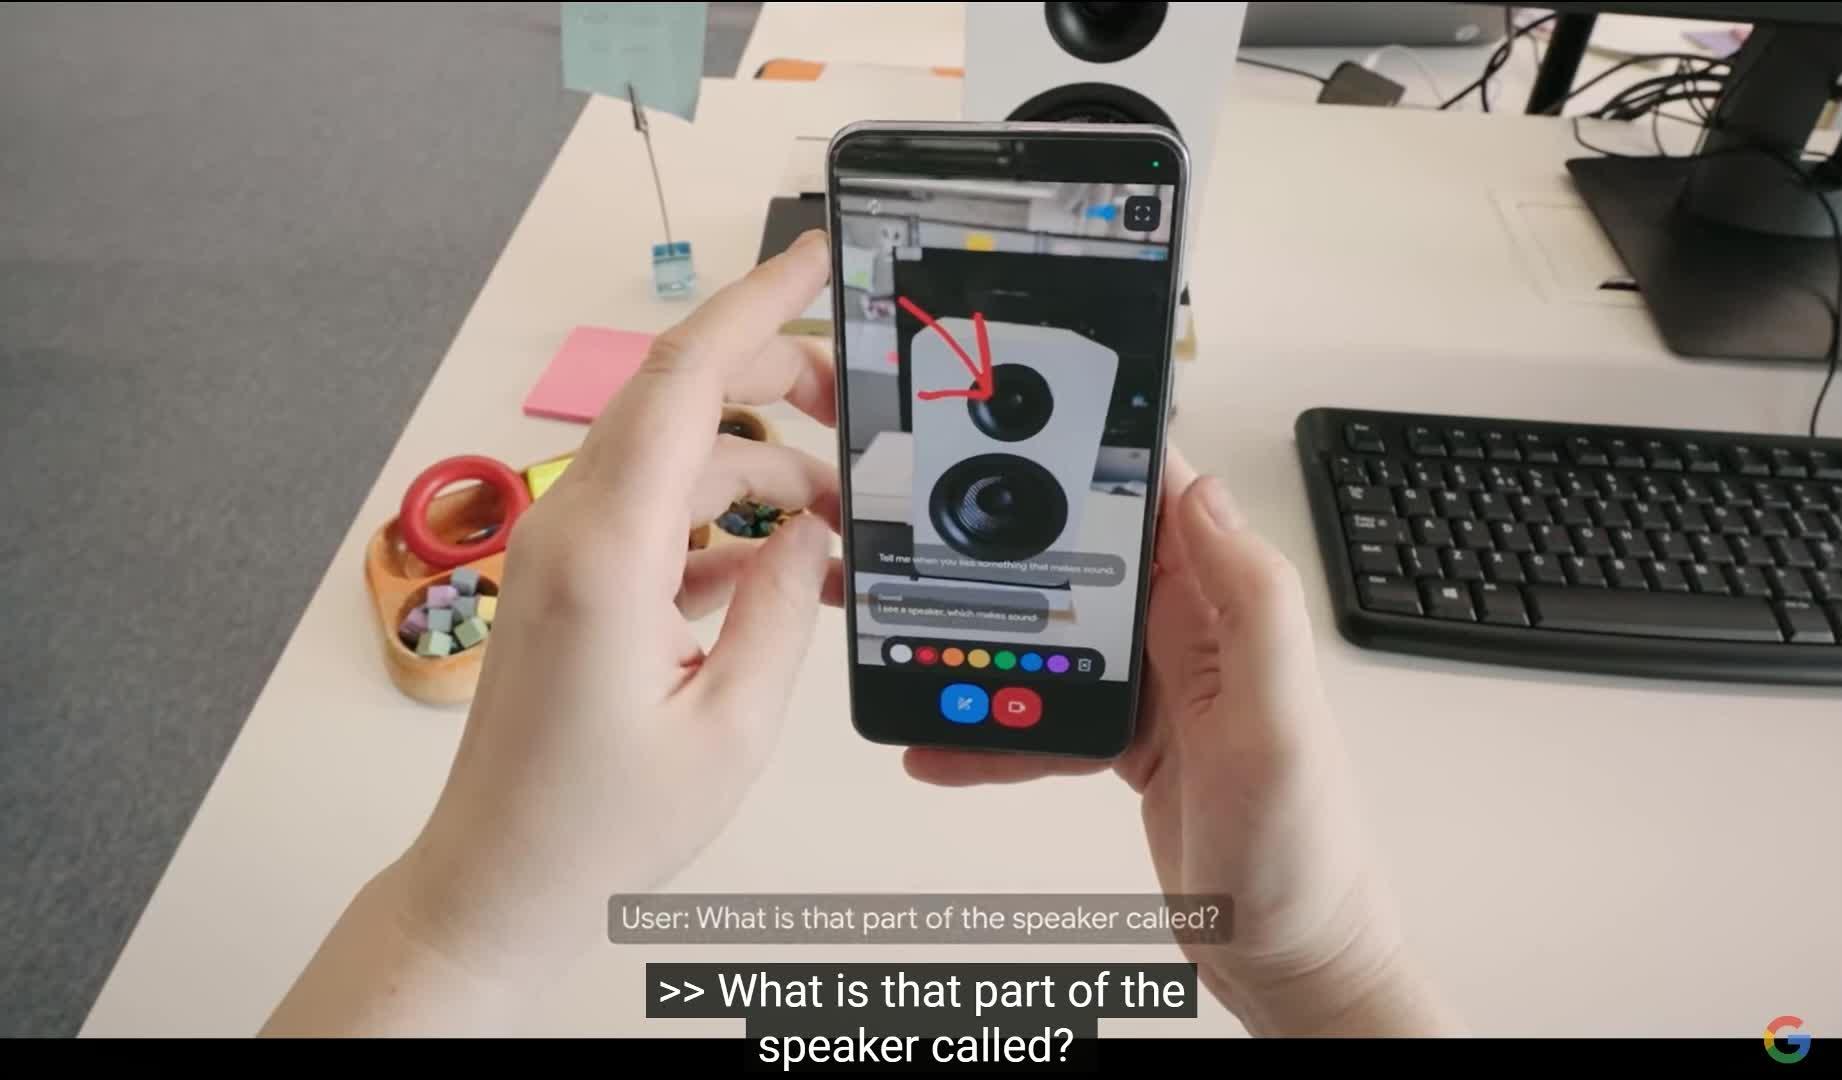 https://www.zhihu.com/video/1776218768358100992
谷歌表示,Project Astra是对未来AI助手的一个展望。为了实现这一目标,智能体需要像人类一样理解和响应复杂、动态的真实世界,并且能够记住和调用所见所闻的信息。Astra还具有主动性、可教育和个性化的特点,用户可以自然地与之对话,而无需担心延迟。
在技术层面,Astra通过连续编码视频帧、将视频和语音输入组合到事件时间线中,并缓存此信息以进行有效调用,从而加快了信息处理速度。谷歌还强化了Astra的语音模型,使其发音更加自然,语调更加多样。这些改进使Astra能够更好地理解上下文,并在对话中快速做出响应。
尽管如此,Astra在响应时长和语音情感丰富度方面,仍需与OpenAI的GPT-4o竞争。尤其是在演示过程中,Astra的延迟似乎比GPT-4o略长,且未能展示打断智能助手说话的能力。
在这次Google I/O大会上,谷歌发布了多款创新的生成式AI工具,包括视频生成模型Veo、图片生成模型Imagen 3和音乐AI工具Music AI Sandbox与Lyria模型。
Veo:60秒长视频生成
Veo是对OpenAI Sora的正面回应。
这款视频生成模型能够生成高达1080p分辨率、时长超过60秒的高质量视频。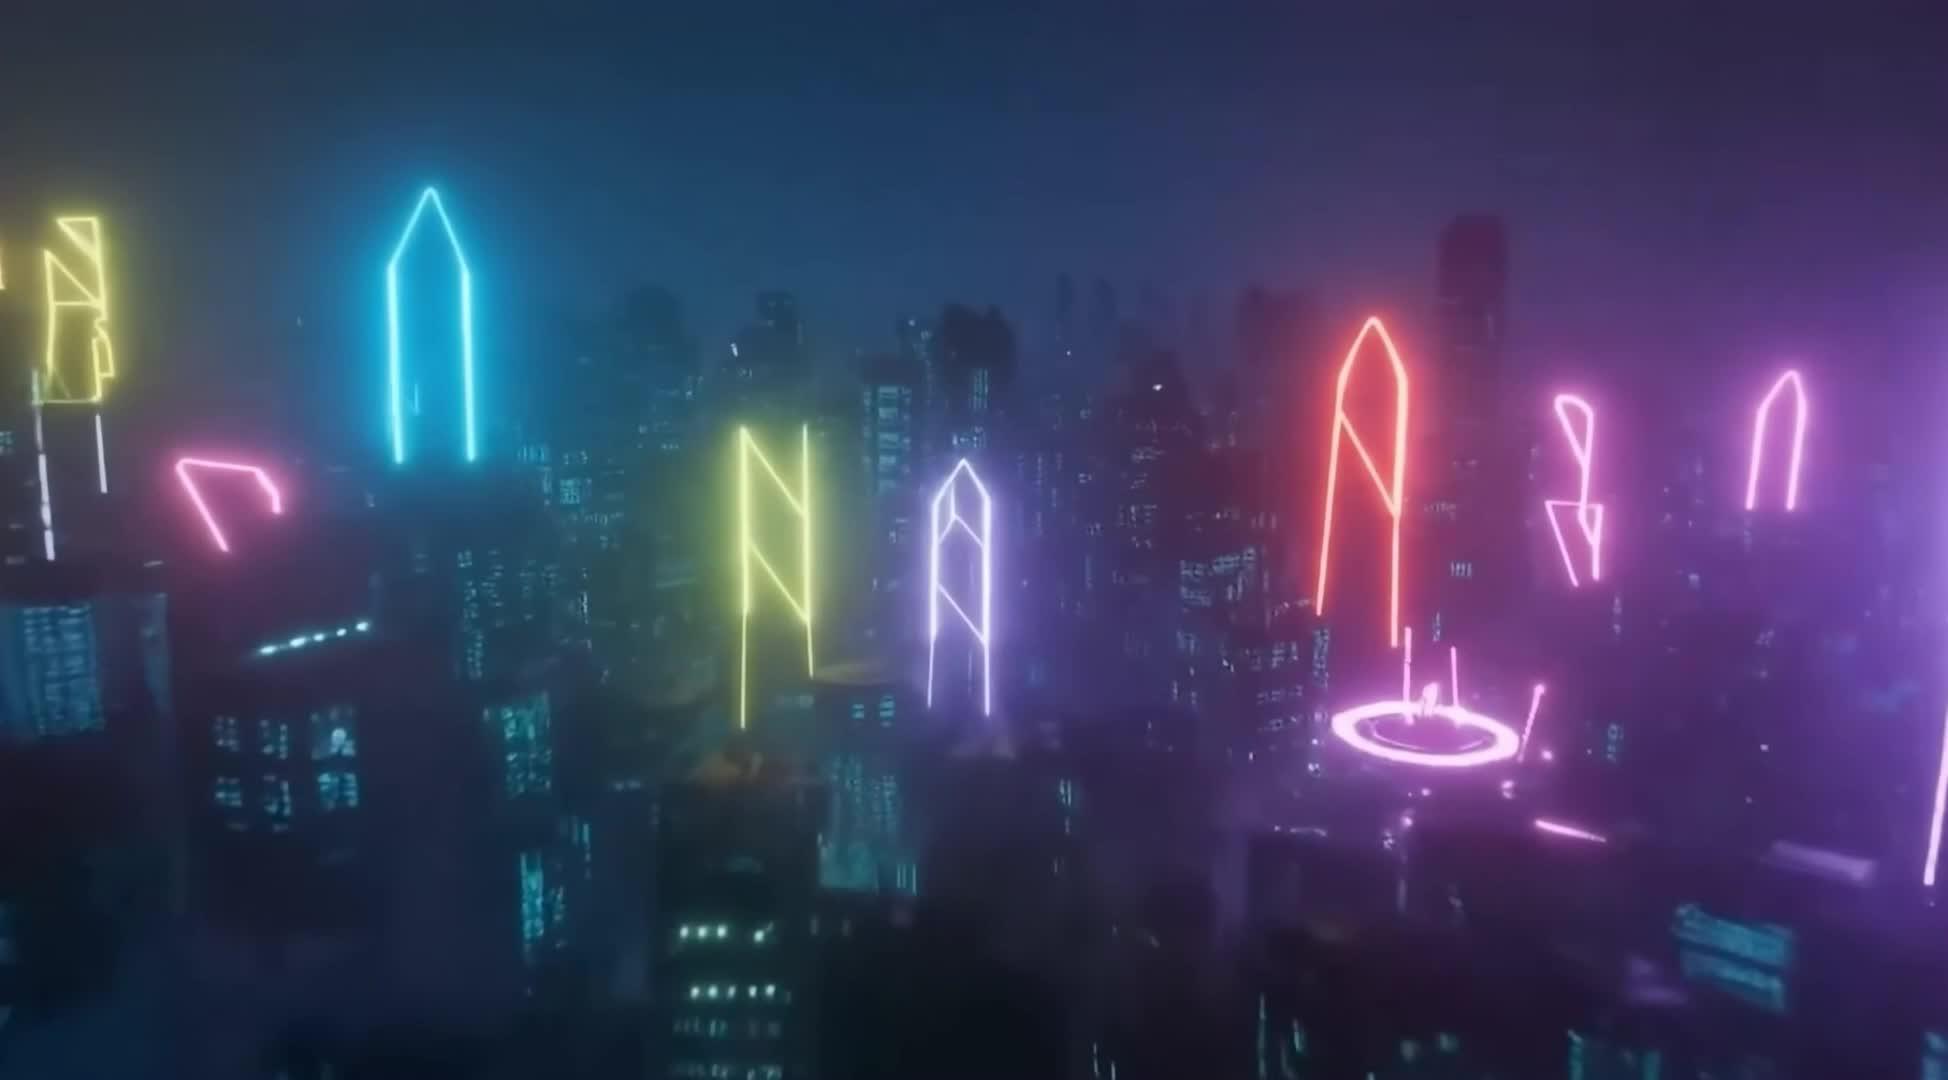 https://www.zhihu.com/video/1776222964025077760
Veo结合了谷歌DeepMind的多项开创性技术,包括GQN、Phenaki和Lumiere等,显著提高了视频生成的一致性、质量和分辨率。
Veo具备极高的创意控制水平,可以理解并生成各种风格的高质量视频。用户可以通过文本、图像和视频提示来生成内容。例如,输入“许多斑点水母在水下搏动,它们的身体透明,在深海中闪闪发光”,Veo会生成一段逼真的水母视频。
Veo不仅能够生成连续的长视频,还能通过一系列提示词来讲述完整的故事。例如,无人机拍摄的夏威夷丛林海岸线,可以通过Veo生成出令人惊艳的航拍镜头。
Veo已经开始在官网开放试用,并为一些创作者提供了预览版。
Imagen 3:增强的图片生成
与此同时,谷歌还发布了更新版的图片生成模型Imagen 3。与前代模型相比,Imagen 3减少了视觉伪影,增强了图像细节表现力,并在生成文字方面也取得了显著提升。
Music AI Sandbox:音乐创作的AI助手
在音乐创作方面,谷歌和YouTube合作推出了Music AI Sandbox。用户可以输入一段旋律,AI便能进行风格迁移,帮助艺术家实现创意。谷歌邀请了许多音乐家和制作人来测试这款工具,他们惊喜地发现,Music AI Sandbox能够生成他们从未想到的音乐风格,大大扩展了创作的可能性。
200万Token上下文窗口
Gemini 1.5 Pro最大的亮点之一是其超长的上下文窗口,达到200万tokens。这一突破使得用户可以输入长达2小时的视频、22小时的音频、超过6万行代码或140多万单词的文本,远超其他现有大语言模型,如GPT-4 Turbo和Claude 3。皮查伊表示,未来谷歌的目标是实现无限长的上下文窗口,为用户带来更强大的信息处理能力。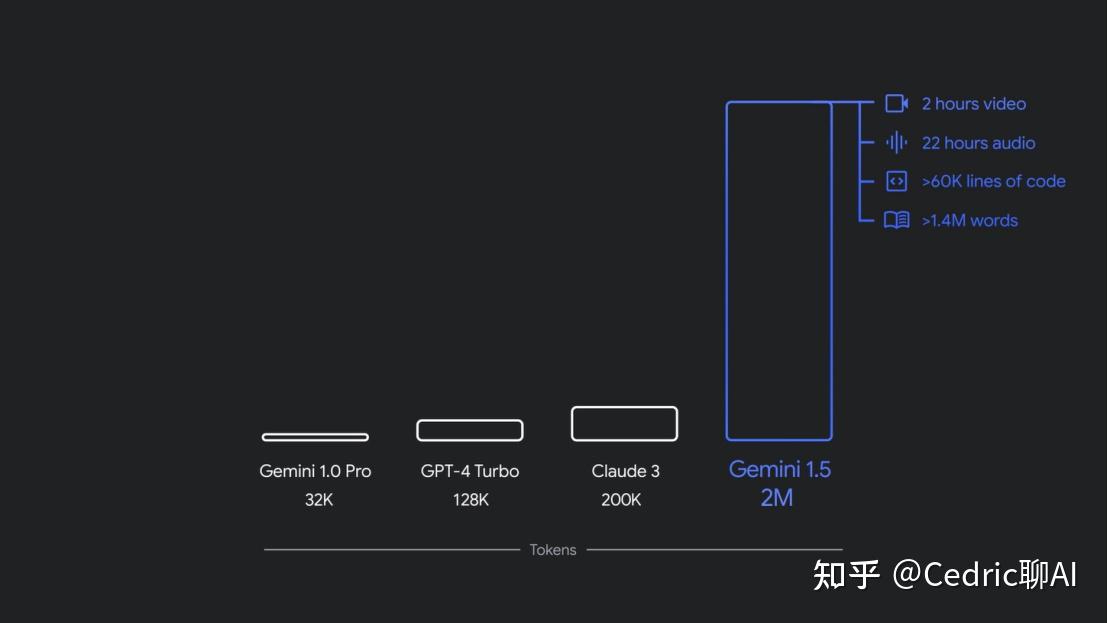
更强大的处理能力
除了上下文窗口的扩展,Gemini 1.5 Pro在代码生成、逻辑推理、多轮对话以及音频和图像理解能力方面也进行了全面升级。用户可以通过系统指令引导模型行为,满足复杂的产品级指令需求。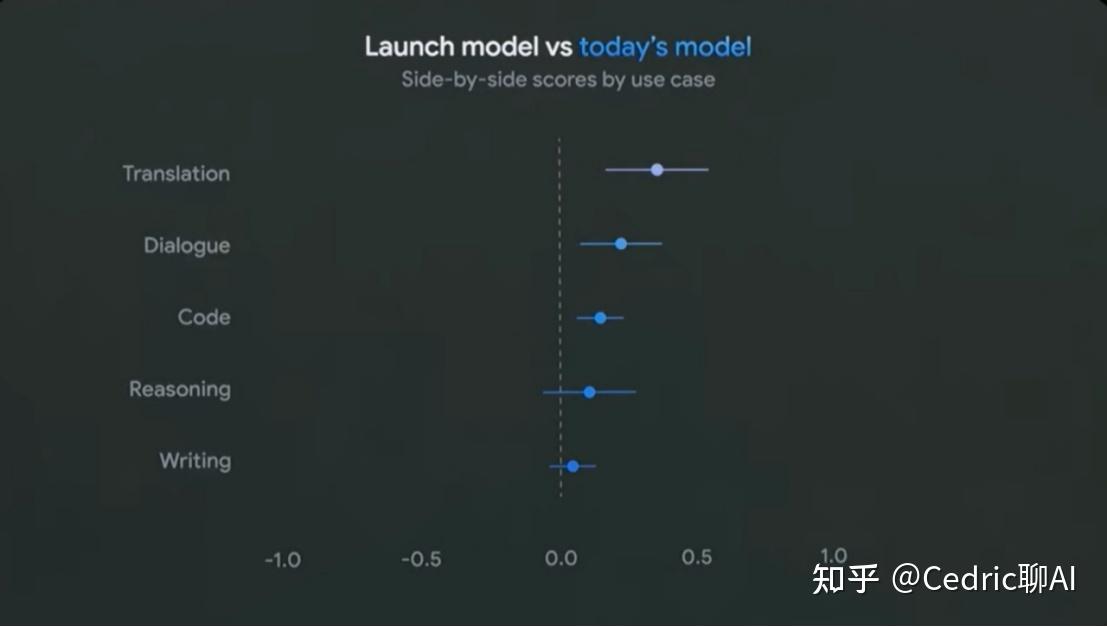
例如,父母可以使用Gemini在Gmail中整理关于孩子学校的邮件,或帮助用户总结公司会议的要点。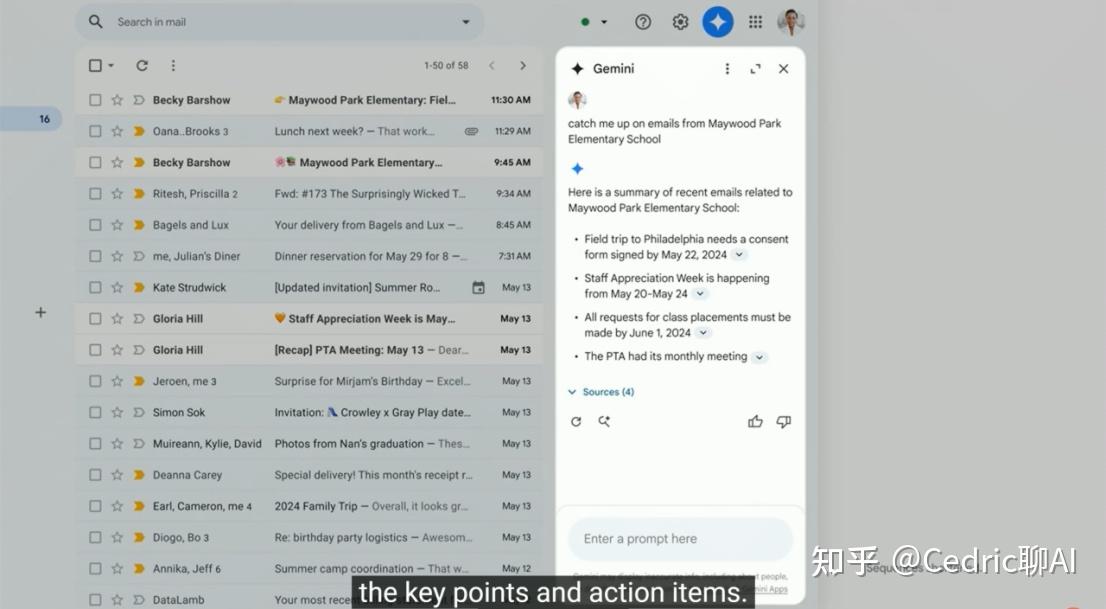
音频理解和多模态支持
Gemini 1.5 Pro集成了音频理解能力,能够在Google AI Studio中对上传的视频、图像和音频进行推理。支持多模态的Gemini可以处理各种格式的信息,理解内容后将其改造成适合用户的形式。
比如,用户可以通过篮球讲解牛顿运动定律,使学习变得更加生动有趣。
又比如,用户只需拍一张照片给Gemini,它就能自动识别并从邮箱中搜出订单,帮助填写退货单。
Gemini 1.5 Flash:轻量级选择
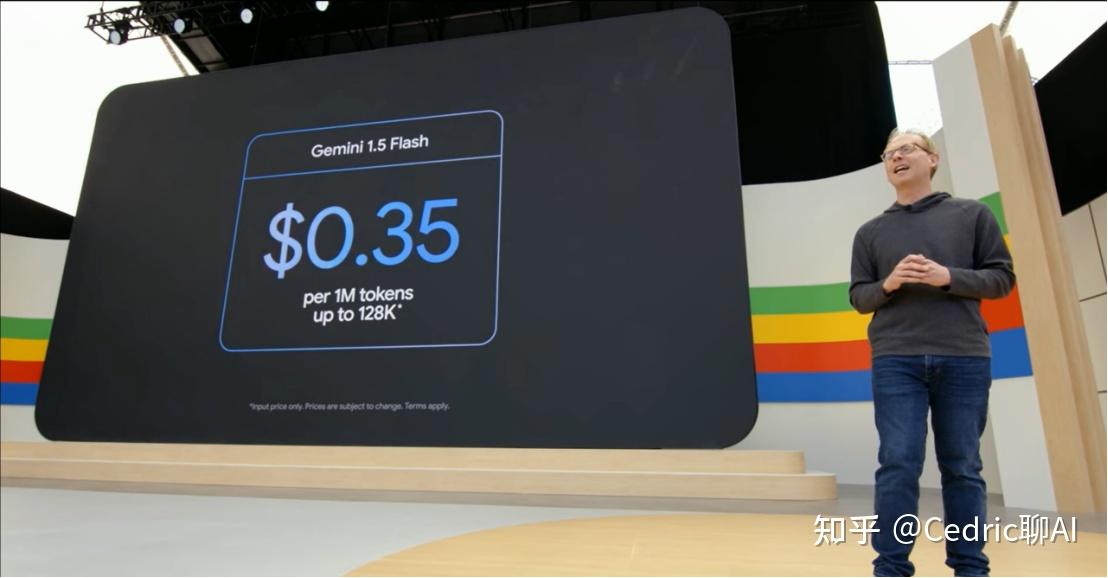
为了满足一些程序对低延迟和低成本服务的需求,谷歌还推出了Gemini 1.5 Flash。这一轻量级模型专为响应速度要求极高的任务优化,具备多模态和100万tokens长的上下文窗口,同时实现了轻量化、低延迟和高效推理,每百万个tokens的价格仅为Pro版的二十分之一。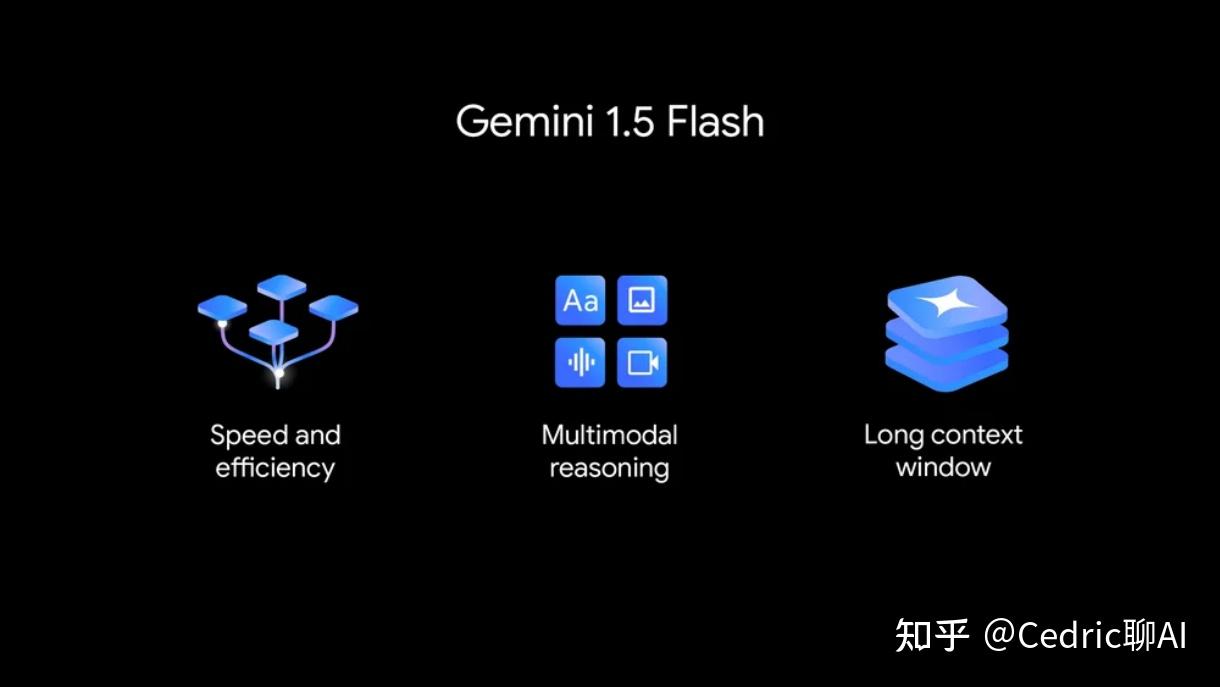
开发者福利
从今天起,开发者可以在Google AI Studio和Vertex AI中申请使用Gemini 1.5 Flash。谷歌还对Gemini的API功能进行了优化,包括视频帧提取、并行函数调用和上下文缓存,为开发者提供了更多便利。
谷歌宣布将Gemini大模型全面集成到其各大产品线中。无论是谷歌搜索、Android系统,还是Gmail、Google Photos等应用,Gemini的引入无疑将彻底改变用户体验。
谷歌搜索
谷歌搜索推出了基于Gemini的新功能——AI概述(AI Overview)。
这一功能可以处理复杂的问题,例如查找波士顿最好的瑜伽或普拉提工作室并提供详细信息。AI概述不仅能给出答案,还会附带相关链接、地图位置等,极大地提升了搜索效率。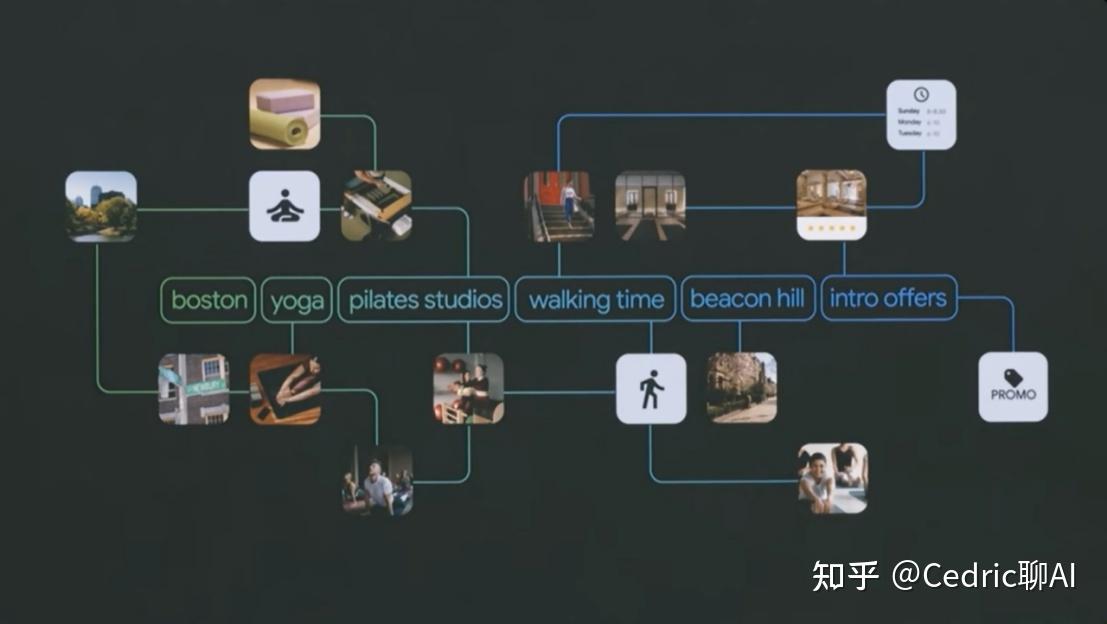
多步推理技术的引入,使得AI可以将复杂问题分解成多个小问题并按顺序回答,从而实现全面的规划和总结。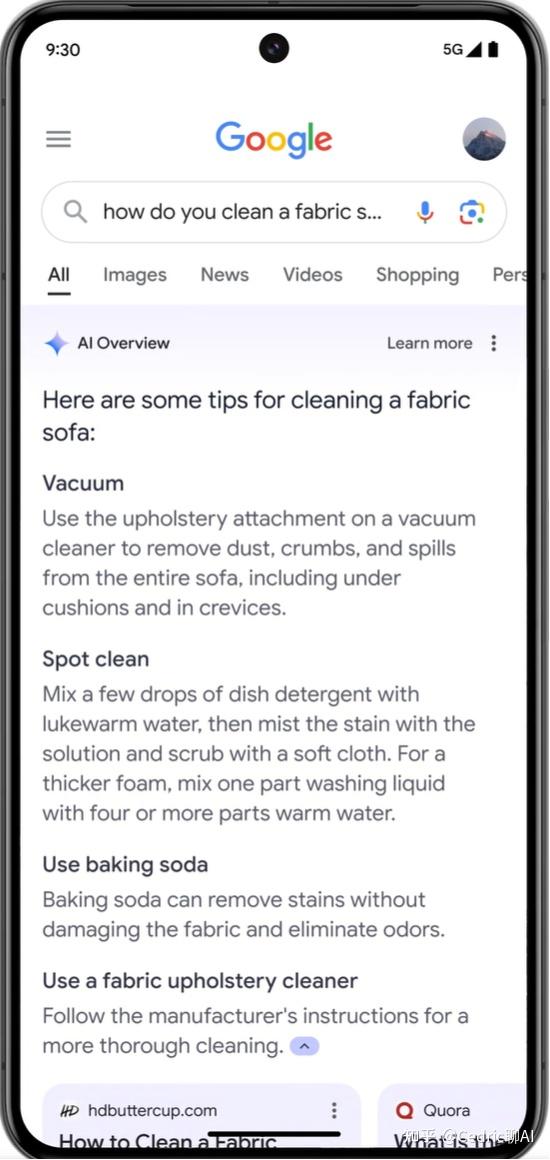
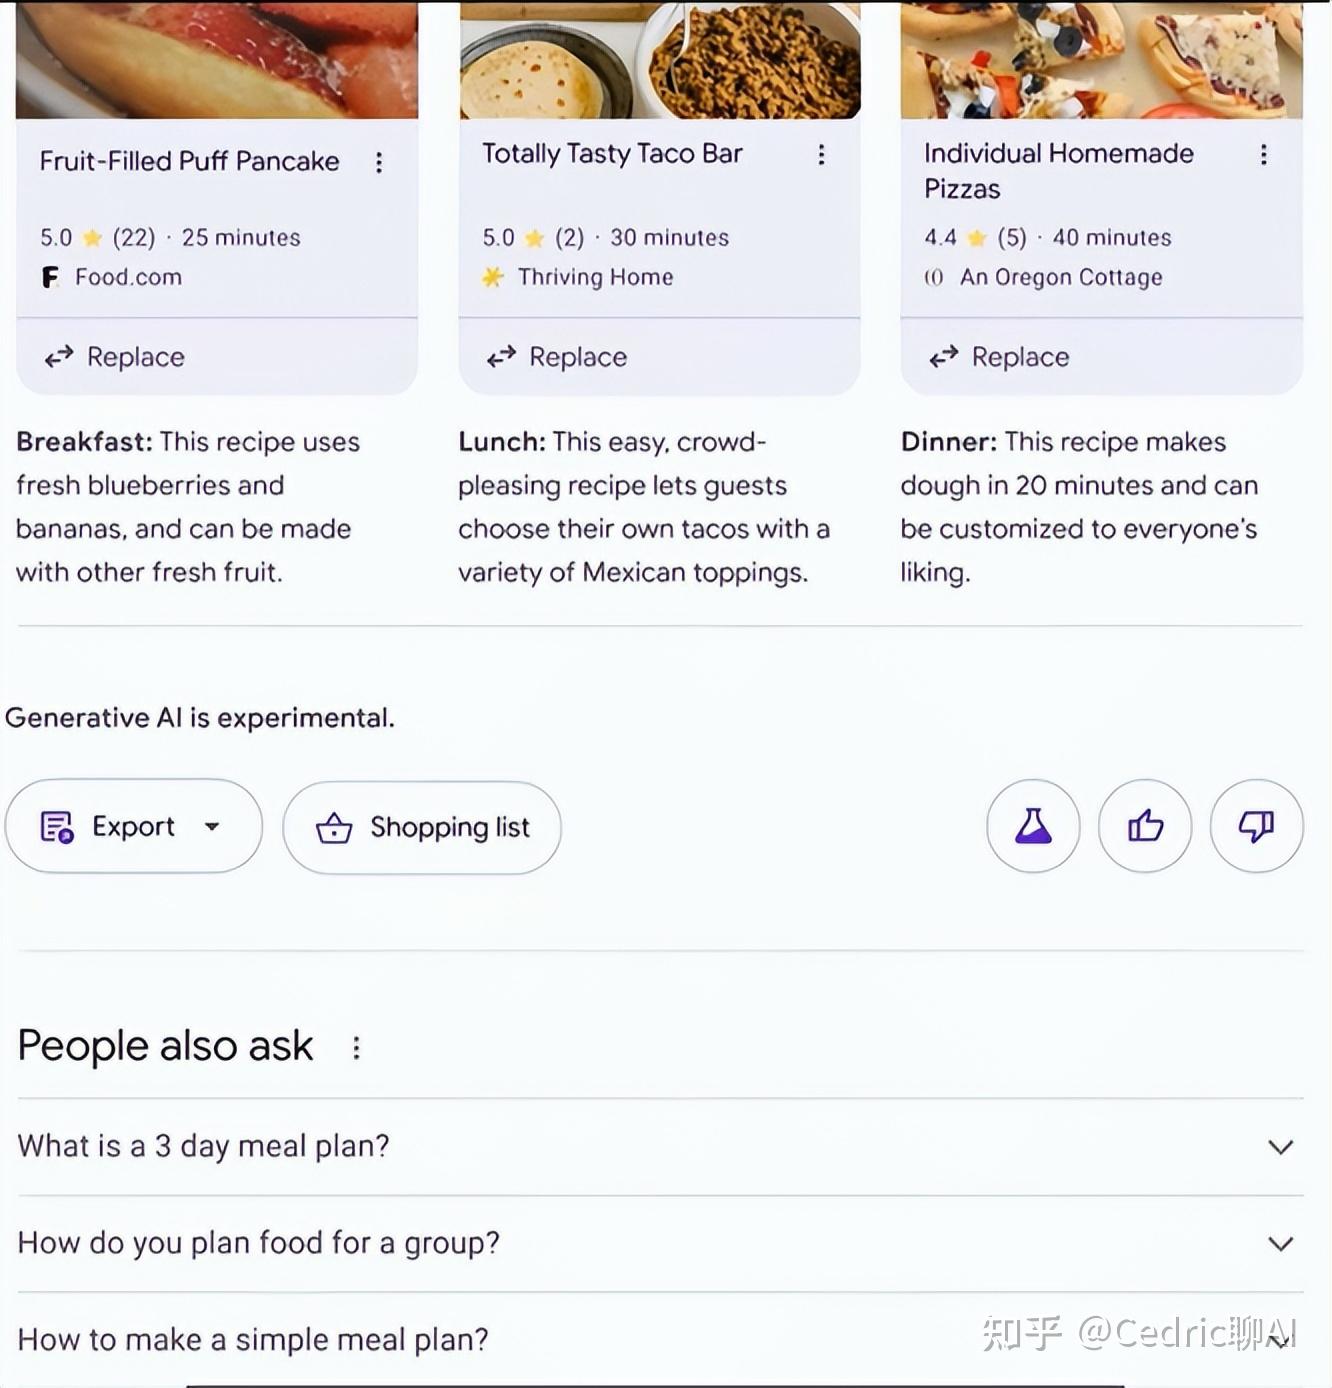
例如,用户可以要求AI概述制定一个三天的膳食计划,AI会从网络整合出详细的食谱,并将所需食材一键加入购物车。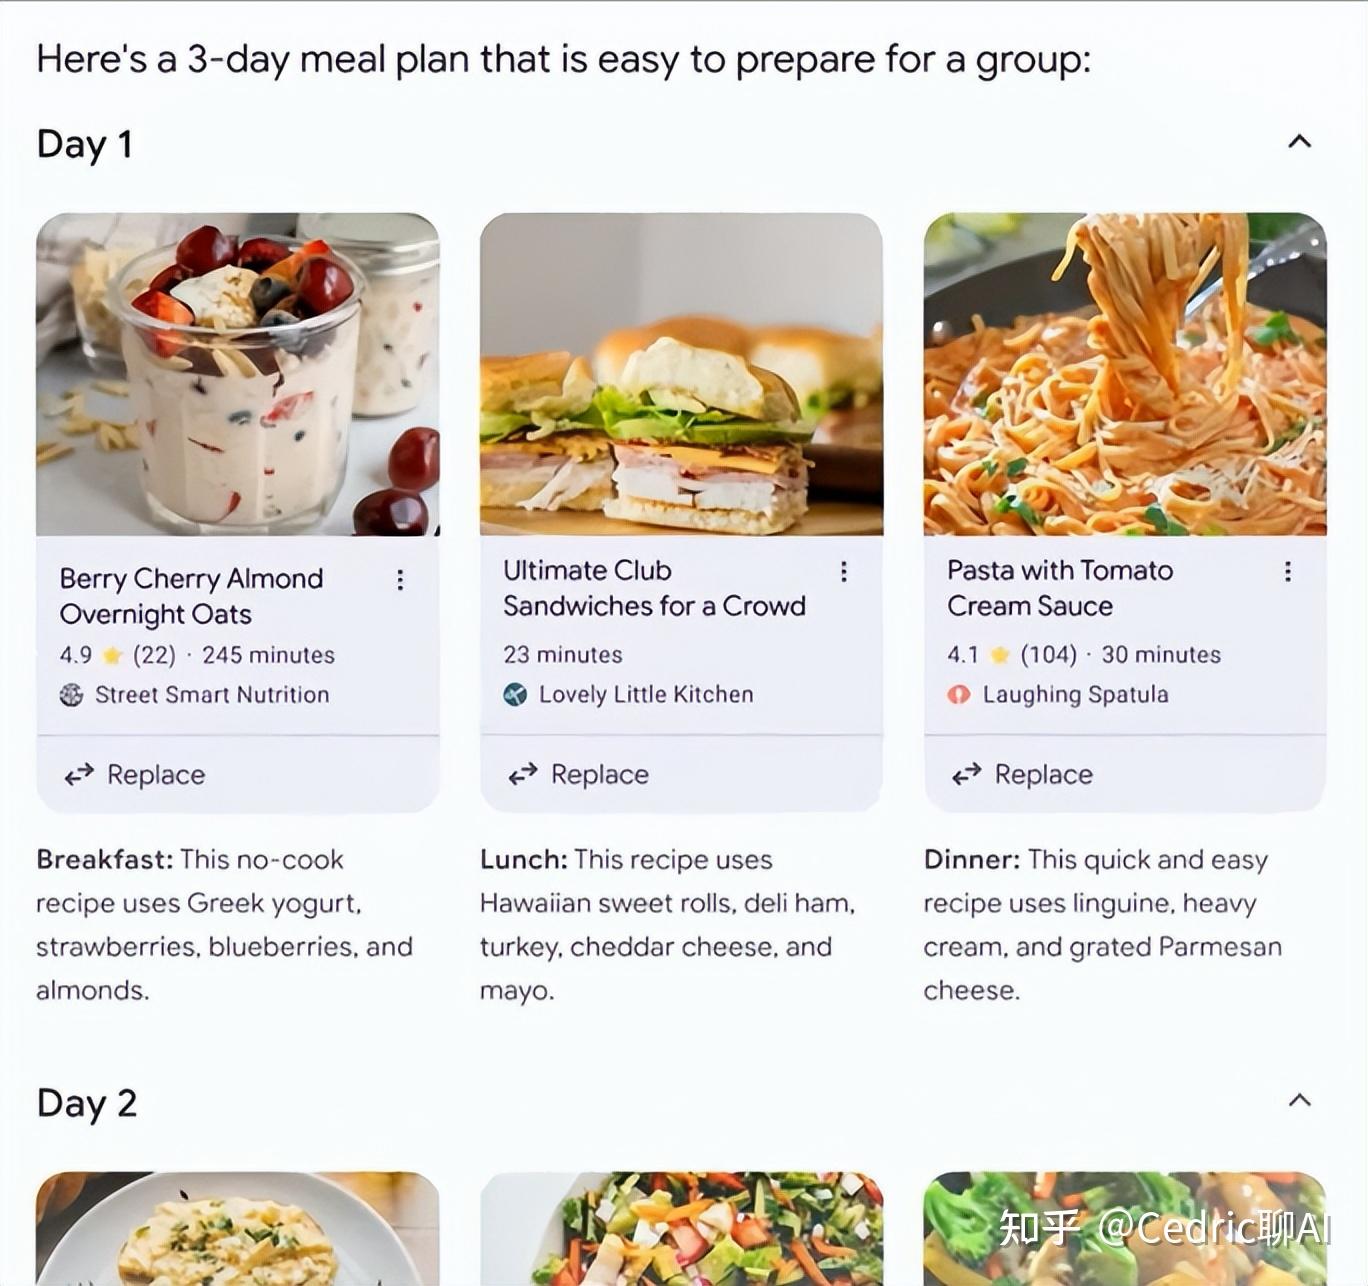
谷歌还展示了通过视频进行搜索的功能,如拍摄唱片机故障的视频并描述问题,AI概述可以即时分析并提供解决方案。
Android 15
在Android系统中,Gemini的集成也带来了诸多创新。用户只需简单的手势操作,即可在手机屏幕上圈出任何内容并进行搜索。
这一功能目前已在Pixel和部分三星设备上使用。通过Gemini助手,用户可以随时在应用中调用AI功能,如拖拽生成的图片到Gmail中或询问视频中的具体信息。
此外,Gemini还具备反诈功能,能识别并警报关键字,如“把钱转到安全账号”,确保用户财产安全。
Google Photos
谷歌Photos基于Gemini推出了新功能——Ask Photos。用户可以通过这一功能快速查找图库中的特定照片和视频。
例如,用户可以询问“我的孩子什么时候学会游泳的”,Ask Photos会自动查找相关照片并给出总结回复。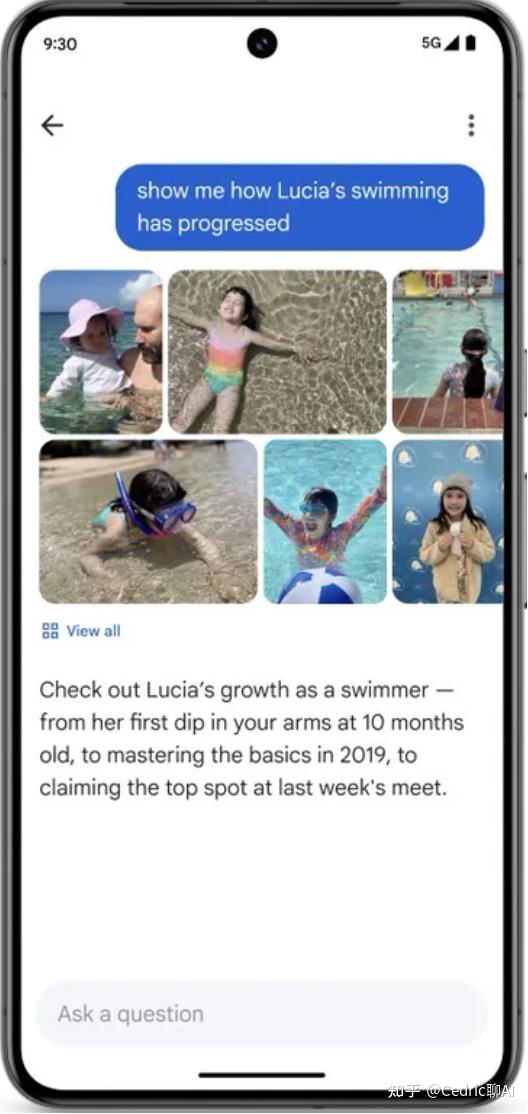
Gmail和Google Workspace
在Gmail中,Gemini可以帮助用户识别并总结所有与学校相关的邮件,提供要点摘要。同样,在Google Meet上,Gemini可以总结会议录音,提供关键信息,帮助用户及时掌握会议内容。Google Workspace中的其他应用也受益于Gemini的引入,使得信息处理更加智能化和高效。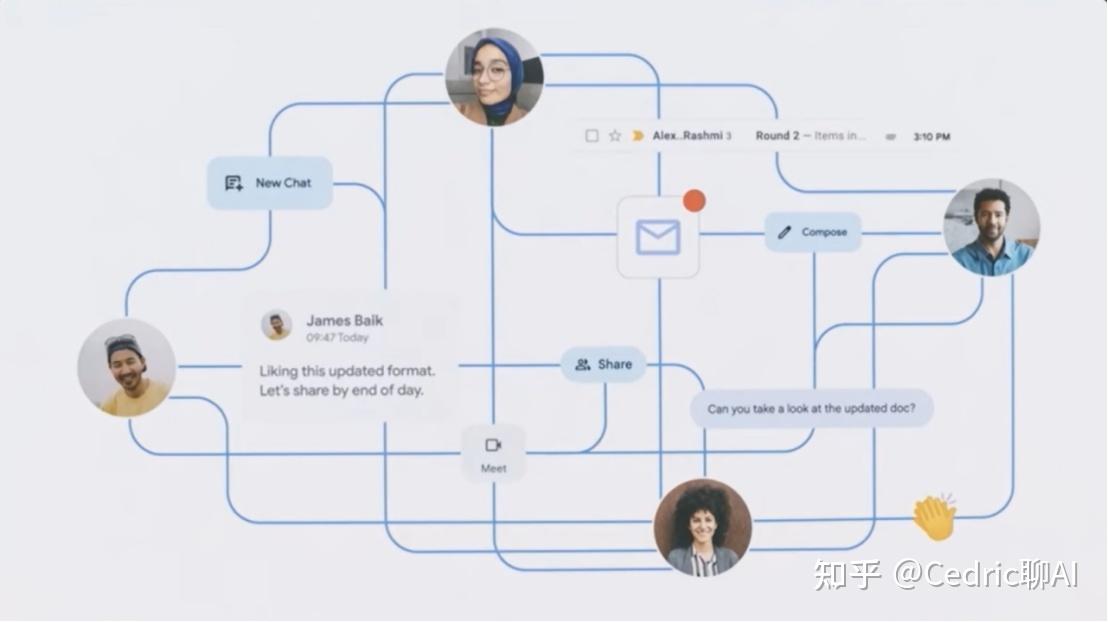
谷歌还发布了第六代TPU(张量处理单元)Trillium,这一新硬件将在2024年底正式上线,为谷歌的AI技术提供强大的计算支持。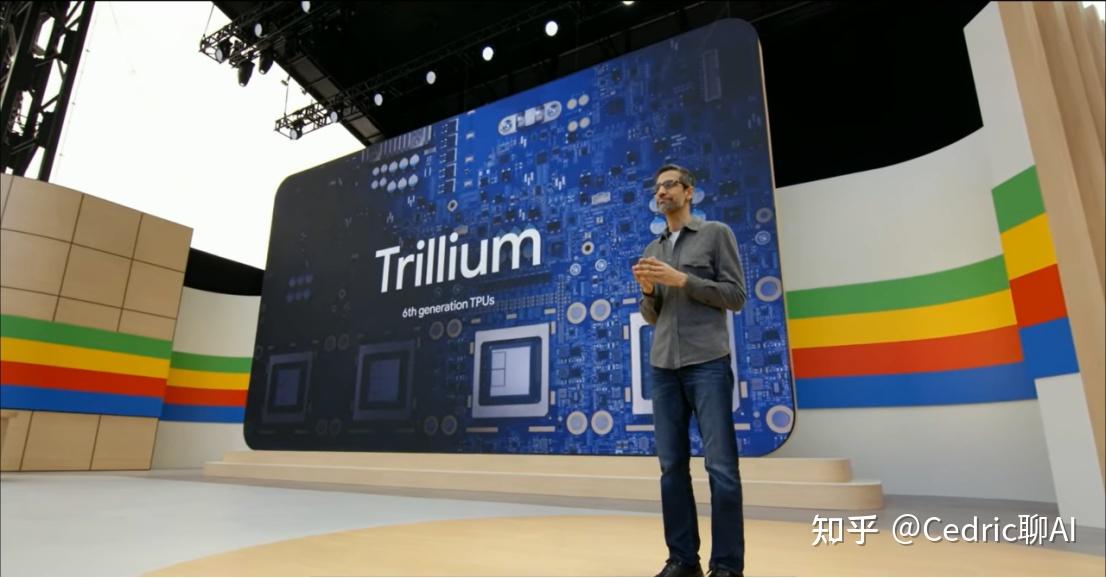
相较于TPU v5e,第六代Trillium TPU在性能上实现了4.7倍的提升,能效提高了超过67%。谷歌通过增大矩阵乘法单元(MXUs)的规模和提升时钟速度。此外,Trillium配备了第三代SparseCore,专门用于加速高级排序和推荐工作负载中常见的超大嵌入处理,有效提升了重嵌入型工作负载的效率。
为了支持更加复杂的模型,谷歌将高带宽存储器(HBM)的容量和带宽翻倍,并将芯片间互连(ICI)的带宽提升了一倍。这使得Trillium能够处理更多的权重和更大的键值缓存,显著缩短了大模型的训练时间和响应延迟。
Trillium可以在一个高带宽、低延迟的计算集群(Pod)中扩展至256个TPU。通过多切片技术和Titanium智能处理单元(IPU),Trillium还能够进一步扩展,连接数百个Pod,组成由每秒数PB数据中心网络支持的超大规模超级计算机。
第六代TPU Trillium将用于训练和微调最强大的AI模型,为生成式AI、图像识别、语言翻译等应用提供支持。谷歌还宣布,诸如Gemini 1.5 Flash、Imagen 3和Gemma 2等新模型,均在TPU上进行训练并使用TPU提供服务。
如果你觉得这篇文章对你有所帮助,欢迎点赞、收藏以及转发分享。同时,请关注我,以获取更多关于人工智能的最新资讯和见解!
参考:
https://blog.google/technology/developers/google-io-2024-collection/
https://blog.google/inside-google/message-ceo/google-io-2024-keynote-sundar-pichai
https://blog.google/technology/ai/google-gemini-update-flash-ai-assistant-io-2024
https://www.youtube.com/watch?v=XEzRZ35urlk