规格参数与使用规范
paper:A Systematic Survey of Prompt Engineering in Large Language Models: Techniques and Applications
Prompt Engineering已经成为扩展大语言模型(LLMs)和视觉语言模型(VLMs)能力的不可或缺的技术。这种方法无需修改模型参数,而是基于特定的任务指令(Prompt)来增强模型的效果。Prompt不是更新模型参数,而是仅通过给定的提示诱使预训练模型无缝集成到下游任务中。提示可以是给定的上下文以指导模型的自然语言指令,也可以是已经学习到的相关知识的向量表示。这个新兴领域已经在各种应用中取得了成功,从问答到常识推理。然而,对于各种Prompt Engineering技术的系统性组织和理解仍然不足。本文按应用领域对最近Prompt Engineering的进展进行结构化的概述。针对每种Prompt方法,详细说明了提示方法、应用程序、涉及的模型以及使用的数据集。我们还深入探讨了每种方法的优点和局限性,并包括一个分类图和表格,概括了每种提示技术的数据集、模型和关键点。这种系统地分析有助于更好地理解这个快速发展的领域,并为Prompt Engineering的研究提供了未来的机会。
Prompt Engineering已成为增强预训练大语言模型 (LLM) 和视觉语言模型 (VLM) 能力的关键技术。它涉及根据特定的任务策略性地设计指令即Prompt,在不改变模型参数的情况下指导模型的输出。提示工程在对 LLM 和VLMs适配能力的影响尤为重要。

通过提供精心设计的指令,来微调模型输出,提示工程使这些模型能够在各种任务和领域中脱颖而出。这种适应性不同于传统的范式,在传统的范式中,通常需要针对特定任务进行重新训练或大量微调才能实现性能。这就是提示工程的变革承诺,它推动着人工智能的发展,并为充满可能性的未来打开了大门。在不断变化的环境中,正在进行的研究不断揭示出提示工程中的创新方法和应用。提示工程的重要性体现在它能够引导模型响应,增强 LLM 在各个领域的适应性和适用性。当代提示工程的景观涵盖了从零样本和少量样例提示等基础方法到“代码链”提示等更复杂方法的各种技术。提示工程的概念最初是在 LLM 中研究和普及的,后来扩展到了 VLM。尽管有关 LLM 和 VLM 的提示工程的文献非常丰富,但仍然存在一个显著的差距,特别是在关于以应用为中心的提示工程技术的系统综述方面。随着提示工程的最新进展,迫切需要进行全面调查,以提供对当代研究的应用和进步的细微理解。
本综述深入探讨了提示工程的不断发展,分析了29种不同的技术,根据它们的不同应用进行了分类。我们采用系统评价的方法,仔细探讨了多样化前沿提示方法。我们的研究包括它们的应用、使用的语言模型以及实验所用的数据集,对提示引擎的演变提供了详细而细致的分析。此外,我们讨论了这些技术的优点和缺点,为它们的比较有效性提供了见解。我们揭示了一个全面的分类图,展示了这些技术如何在 LLM 能力的广阔领域中导航。从语言生成到问答,再到代码创建和推理任务,提示工程使 LLM 能够执行我们从未想过可能的任务。通过弥合现有文献中的差距,本调查旨在成为研究人员和从业者有价值的资源,提供对最新发展的见解,并促进对提示引擎演变过程的深入理解。本文结构如下:第 2 部分介绍从基础到高级的各种提示工程技术,按应用领域进行分类;第 3 部分提供结论并考虑未来的研究方向。
在本节中,我们根据应用领域组织了提示工程技术,并提供了从zero-shot prompting到最新进展的提示技术的简要概述。

零样例提示为利用大型语言模型提供了范式转变。这种方法[Radford等人,2019年]消除了对大量训练数据的需求,而是依赖于精心设计的提示来引导模型完成新任务。具体来说,模型会在提示中接收到一个任务描述,但缺乏特定输入输出映射的标记数据用于训练。然后,该模型会利用其预先存在的知识根据给定的提示为新任务生成预测。
与零样本提示不同,其中不提供示例,小样本提示为模型提供了少量输入输出示例,以诱导对给定任务的理解。即使只提供几个高质量的示例也比没有演示显著提高了模型在复杂任务上的性能。然而,小样本提示需要额外的token来包含示例,这可能对于较长的文本输入来说是禁止的。此外,提示示例的选择和组合可以显着影响模型行为,而偏爱频繁单词等偏差仍然会影响小样本结果。虽然小样本提示增强了处理复杂任务的能力,尤其是在像 GPT-3 这样的大型预训练模型中,但仔细设计提示至关重要,以实现最佳性能并减轻意外的模型偏差。
由于复杂的推理能力有限, LLMs 通常会遇到困难。为了弥合这一差距,引入了连锁思维(Chain-of-thought,CoT)提示作为技术来以一种促进连贯和逐步推理过程的方式提示 LLM。主要贡献在于提出并探索了 CoT 提示,证明其相对于传统提示更能激发 LLM 的结构化和深思熟虑的响应。通过一系列实验,作者展示了 CoT 提示的独特品质,强调了它引导 LLM 通过逻辑推理链的能力。这导致了对给定提示有更深入理解的响应。例如,提示会显示多步数学问题的推理过程和最终答案,并模仿人类如何将问题分解为逻辑中间步骤。通过使用 CoT 提示为 PaLM 540B 实现最先进的性能,在数学和常识推理基准上达到 90.2% 的准确率。
高质量CoT示例的手动创建既费时又不理想。引入了Auto-CoT,以“Let’s think step-by-step”为提示,自动指导语言模型生成推理链。认识到个别生成的链路可能出现错误的可能性,Auto-CoT通过多样化的采样来增强鲁棒性。它对各种问题进行抽样,并为每个问题生成多个独特的推理链,形成最终的演示集。这种自动多样的抽样减少了错误并增强了小样本学习,消除了需要费力地手动构建推理链的需求。Auto-CoT展示了增强的表现,超越了CoT范式,在使用GPT-3的算术和符号推理任务中平均准确率分别提高了1.33%和1.5%。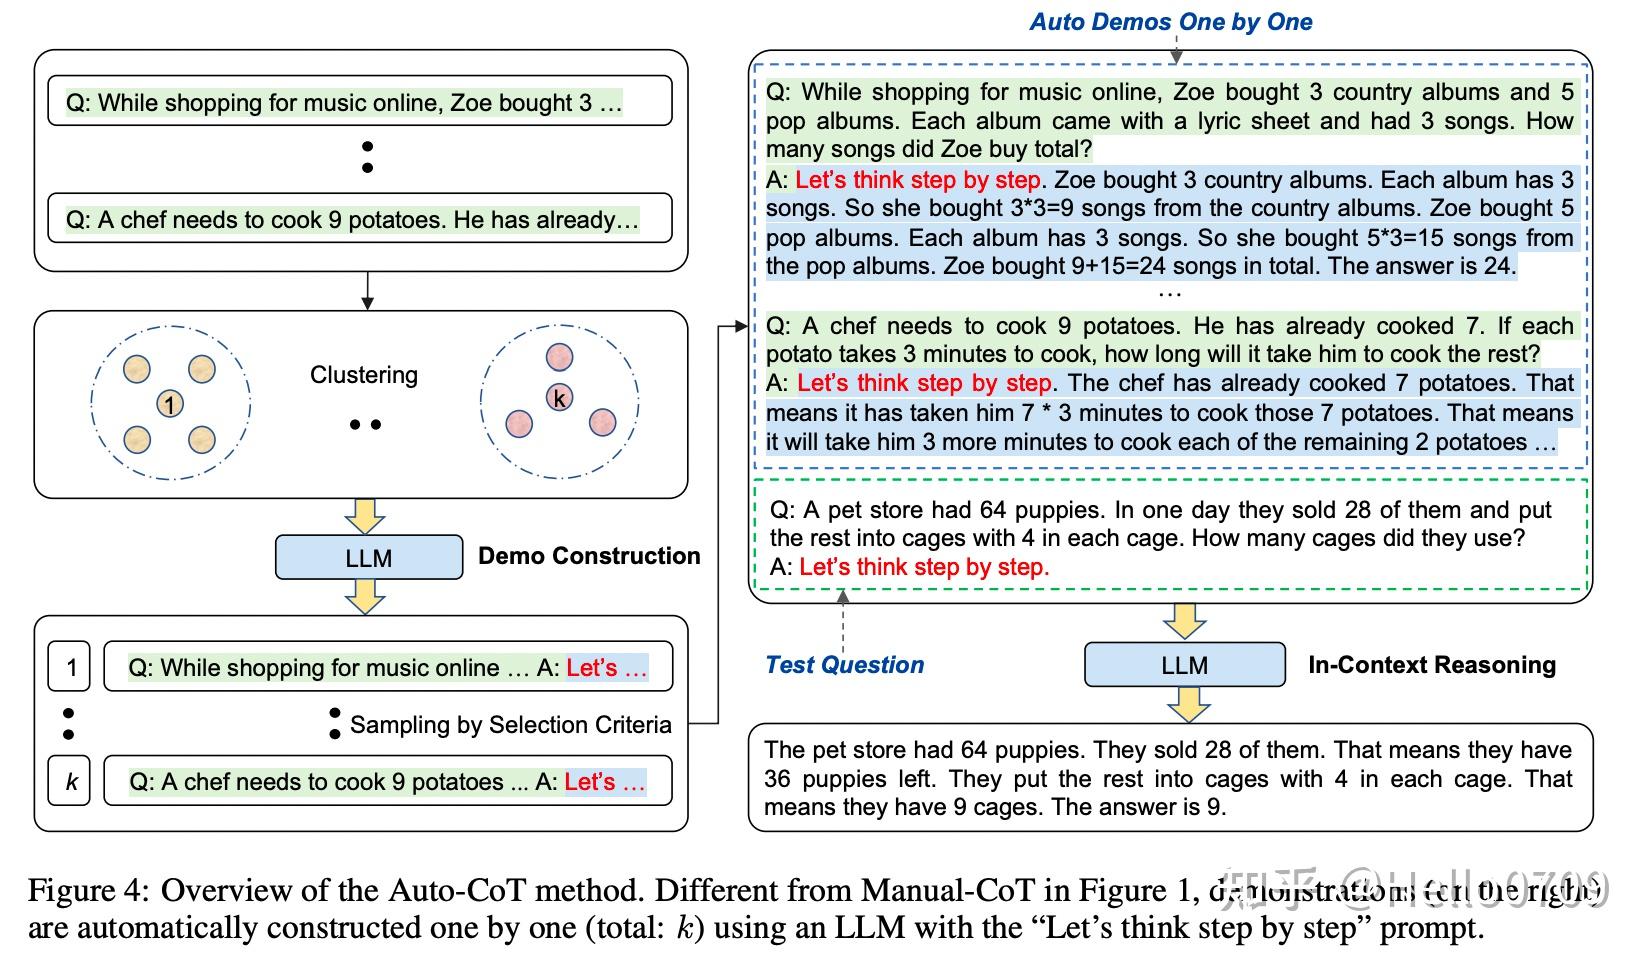
[王等人,2022年] 引入了自一致(self-consistency),这是一种解码策略,用于提高与贪心解码相比的 CoT 提示推理性能。对于具有多个有效路径的复杂推理任务,Self-Consistency通过从语言模型的解码器中采样生成不同的推理链,然后通过积分这些采样链来识别最一致的答案。这种方法利用了这样一个观察结果:需要深思熟虑的问题往往涉及更多的推理多样性,从而导致解决方案。Self-Consistency和COT提示的结合在各种基准测试上显著提高了准确性,例如在 GSM8K 上提高了 17.9%,在 SVAMP 上提高了 11.0%,在 AQuA 上提高了 12.2%,在 StrategyQA 上提高了 6.4%,在 ARC-challenge 上提高了 3.9%,相较于基线的链式思维提示。
逻辑推理能力对于解决多步骤、跨多个领域的复杂问题至关重要。现有方法,如 CoT 提示,鼓励逐步推理,但缺乏有效的验证机制。[Zhao 等人,2023年] 提出了一种名为“LogiCoT”的逻辑链思维提示(神经符号框架),该框架利用符号逻辑的原则以连贯且结构化的方式增强推理。具体来说,LogiCoT 应用归谬法的概念来验证推理的每一步骤。
通过生成模型并提供有针对性的反馈来修改错误步骤。LogiCoT 可以通过一个思考-验证-修订循环来减少逻辑错误和幻觉。在 Vicuna-33b 和 GPT-4 上进行实验的结果强调了 Logi-CoT 对推理能力的重要提升,与 CoT 相比,在 GSM8K 数据集上分别提高了 0.16% 和 1.42%,在 AQuA 数据集上分别提高了 3.15% 和 2.75%。
由于对自然语言的依赖,LLM经常在涉及复杂空间关系的任务中遇到困难,因为自然语言容易产生歧义和偏见。为了克服这一限制,[胡等人,2023年]引入了CoS,使用紧凑符号代替自然语言。CoS具有明显的优势:清晰简洁的提示、增强的空间推理能力以及提高的人类可解释性。CoS存在可扩展性、通用性和不一致性等挑战。
与其他技术的集成,以及基于符号解释 LLM 的推理。值得注意的是,CoS 的实现显著提高了 ChatGPT 的性能,在砖块世界任务中将准确率从 31.8% 提高到令人印象深刻的 92.6%。此外,CoS 可以减少高达 65.8% 的提示标记,同时保持高精度来简化流程。
Yao等人和 Long提出了树思维 (ToT) 框架,以增强对需要探索和前瞻推理的复杂任务的提示能力。 ToT 扩展了 CoT 提示,通过管理称为“thought”的中间推理步骤的树结构来实现这一点。 每个想法都代表一个朝着最终解决方案移动的语言序列。这种结构使语言模型能够评估思想在解决问题时产生的进度来推理。ToT像广度优先或深度优先搜索这样的搜索算法一样集成了模型生成和评估思想的能力。这使得可以在推理链之间系统地进行探索,并在找到错误解决方案时回溯。ToT在24点游戏中表现出色,达到了74%的成功率,而CoT则为4%。此外,在单词级别任务中,ToT相对于CoT具有更高的成功率(60% vs 16%)。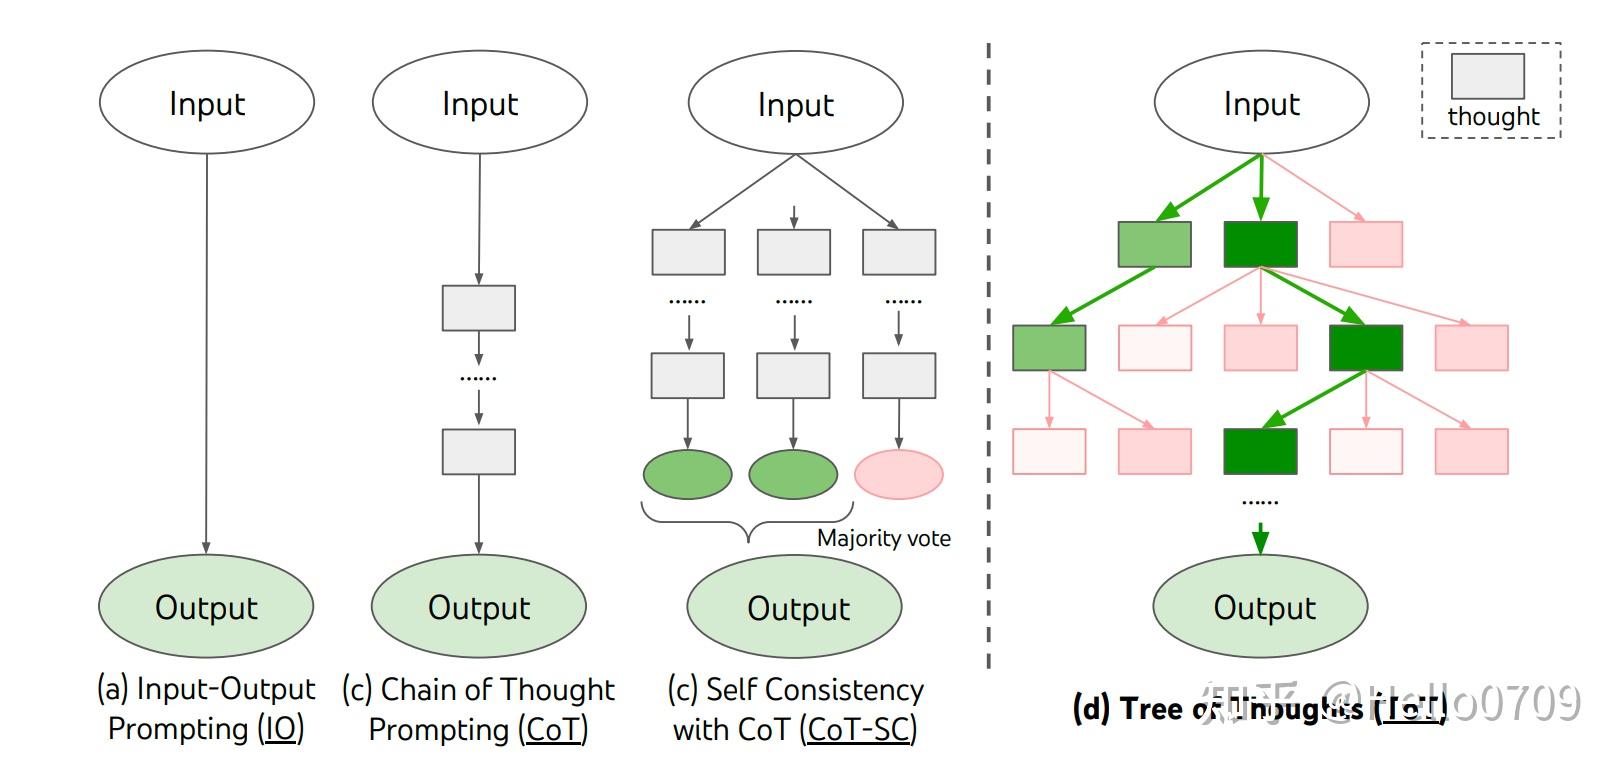
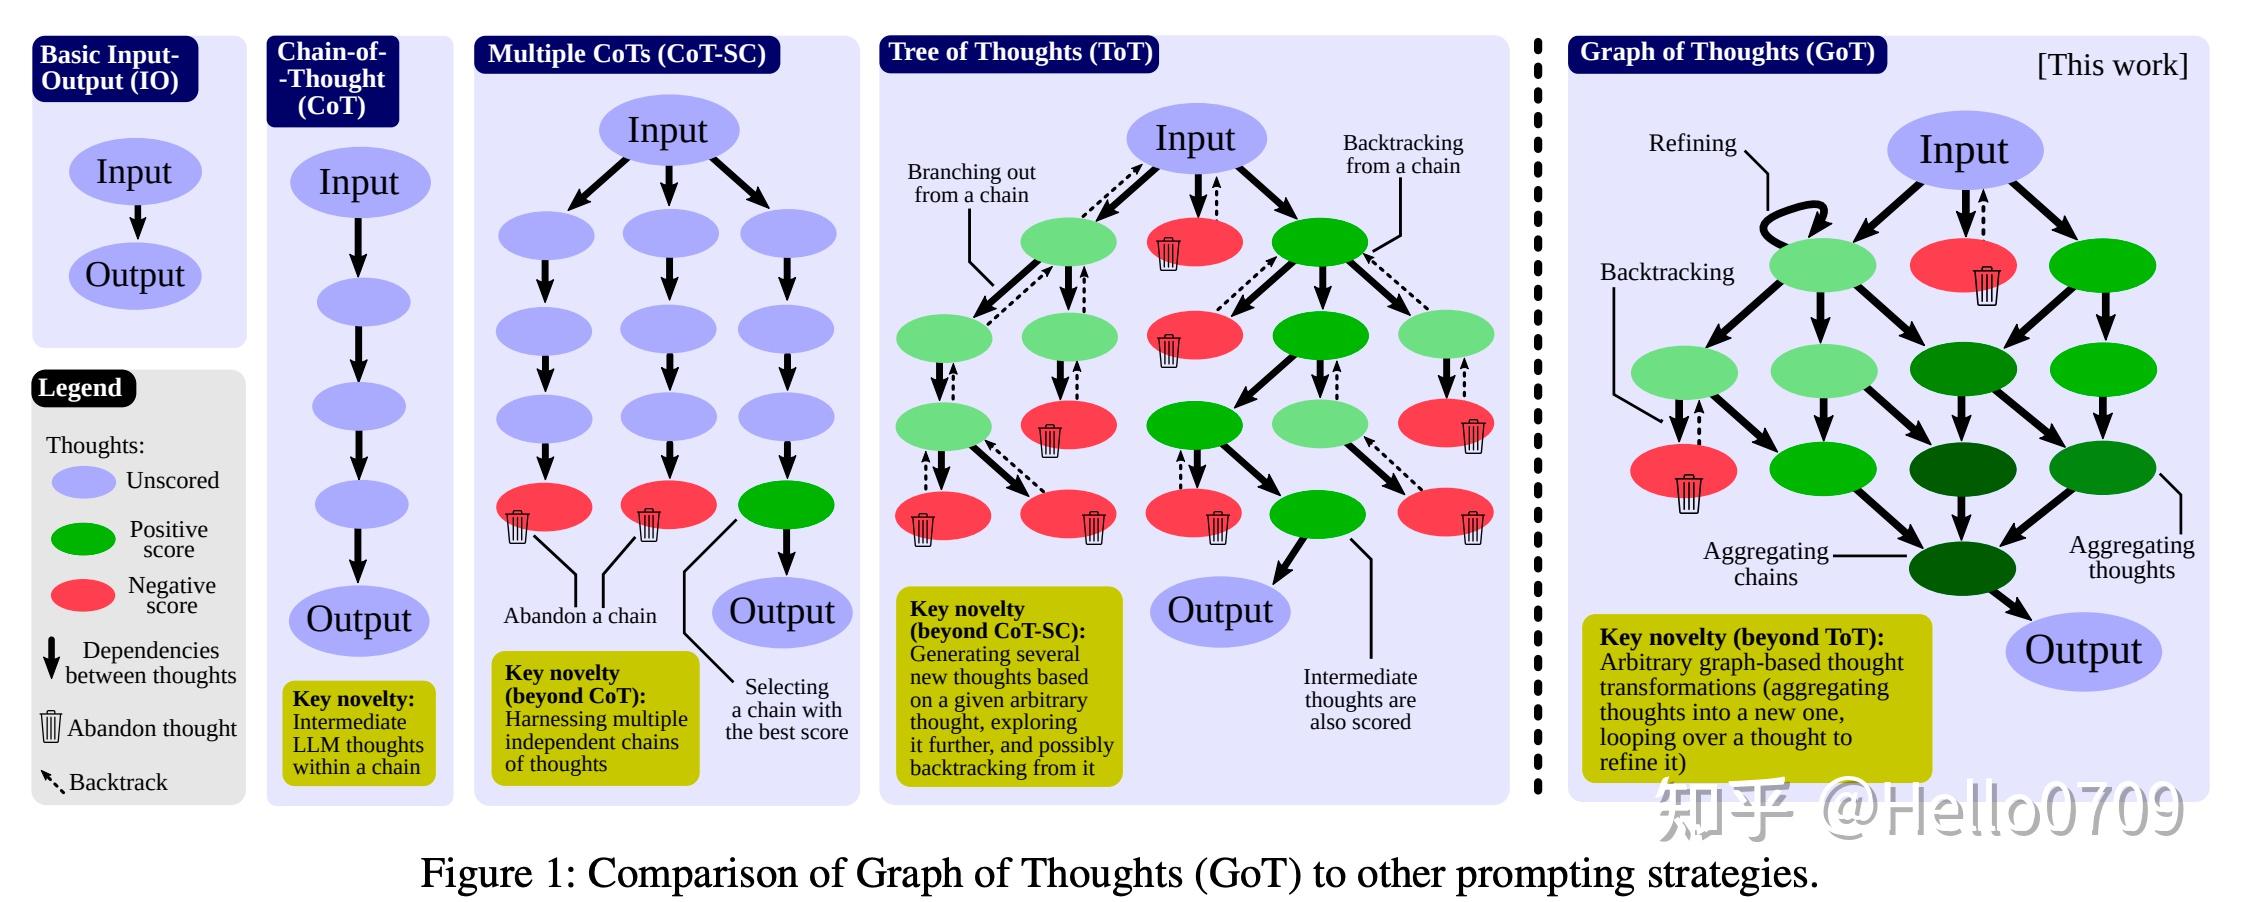
人类思维过程固有的非线性性质挑战了传统的顺序式的COT提示方法。[姚等人,2023年]引入了“Graph of Thoughts”提示,这是一种基于图形的框架,它改进了传统序列方法,以更好地与人类思考的非线性特征对齐。该框架允许动态交互、回溯和评估想法,使来自不同分支的思想聚合和组合,从而脱离了tree of thoughts的线性结构。关键贡献包括将推理过程建模为有向图,并提供具有多种转换操作的模块化架构。该框架作为语言模型提示的一种灵活且动态的方法呈现出来,捕捉到人类思维过程的复杂性并增强模型的能力。GOT推理模型在GSM8K上相对于COT基准取得了显著的提升,使用T5-base时准确率提高了3.41%,使用T5-large时提高了5.08%。它还使用T5-base在ScienceQA上优于最先进的COT模型6.63%,使用T5-large时提高了1.09%。
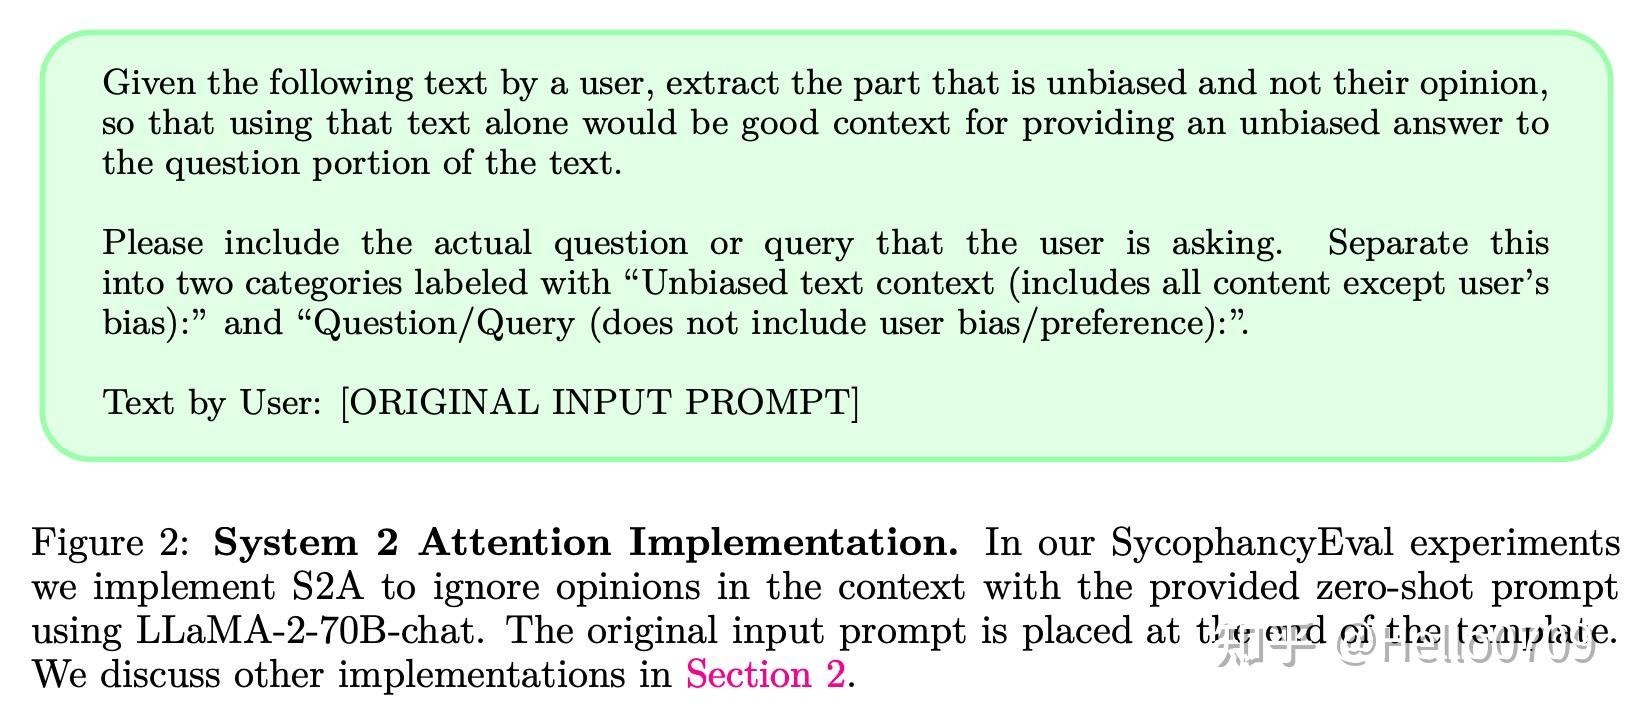
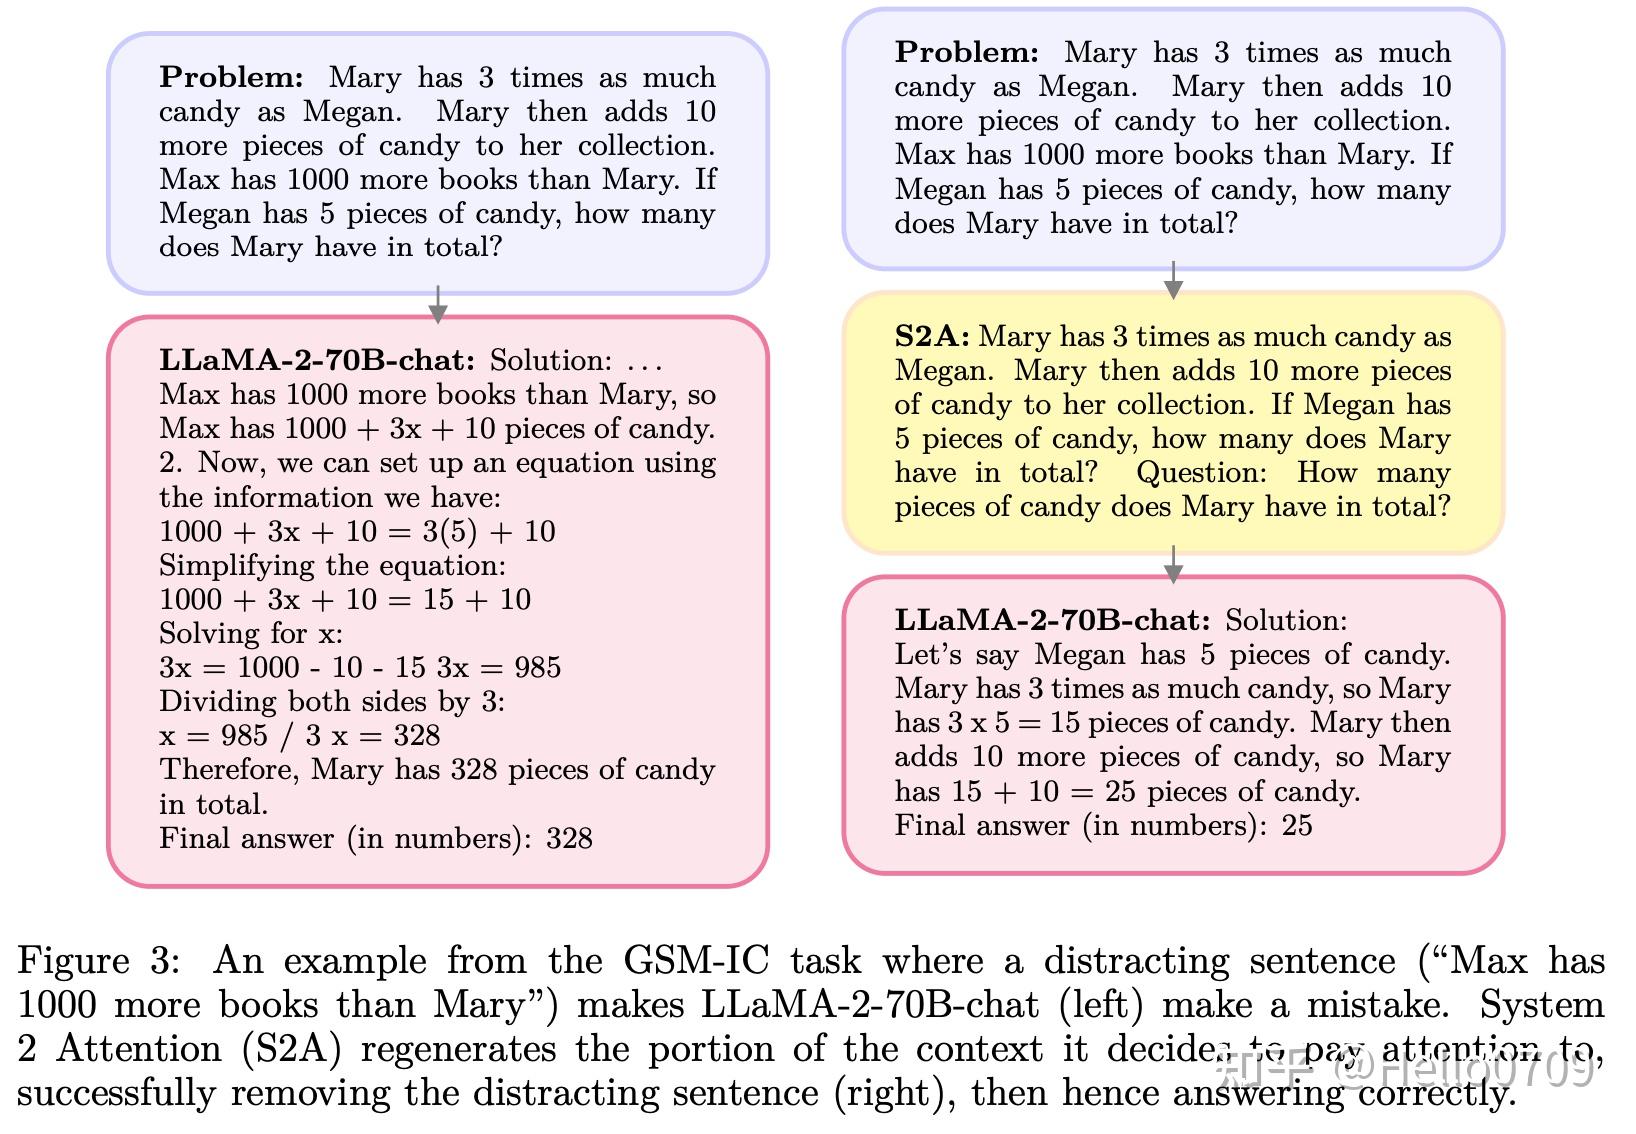
基于Transformer的大语言模型中的soft attention mechanism容易包含不相关的上下文信息,影响token生成。为了解决这个问题,韦斯特顿和苏克巴特尔(2023)提出了System 2 Attention(S2A),利用大语言模型的推理能力通过重新生成输入的上下文以此来针对性的选择相关的部分。S2A采用两步过程:1)通过给定的上下文重新生成与问题相关的上下文内容;2)基于重新生成的上下文和问题进行答案回复。在各种任务中评估了S2A的有效性,包括事实问答、长篇生成和数学应用题等。在事实型QA任务中,S2A 的准确率达到了 80.3%,这表明它在事实性方面取得了显著的提升。在长篇生成任务中,它提高了客观性,并获得了 3.82/5 的分数。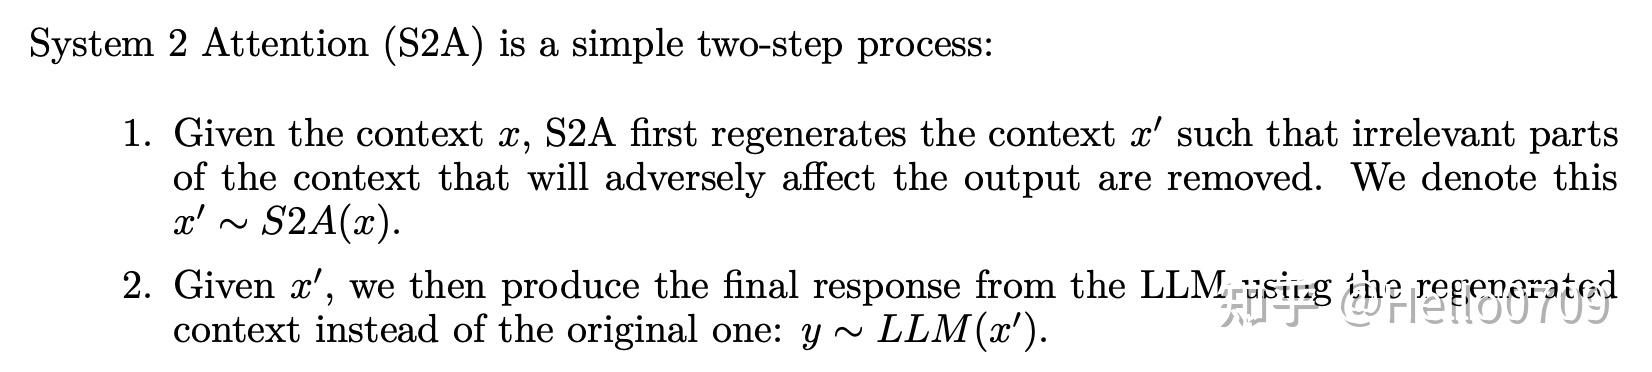
[周等人,2023年] 提出了Thread of Thought (Thot),这是一种旨在增强在混乱环境中 LLM 的推理能力的提示技术。受到人类认知的启发,它系统地将大量的上下文分解为可管理的部分进行增量分析,采用两阶段方法,在 LLM 首先总结并检查每个部分之前对信息进行细化以产生最终响应。Thot 的灵活性使其成为一种通用的“即插即用”模块,可以提高不同模型和提示方法之间的推理性能。在问答和对话数据集上的评估表明,Thot 在混乱环境中的表现有了显著提升,分别提高了 47.20% 和 17.8%。
CoT、PoT 和 ToT 等方法通过自由文本或代码表示推理步骤,但当处理复杂的表格场景时会面临挑战。[Wang et al.,2024]的研究介绍了一种名为Chain-of-Table的开创性提示技术。这种方法使用逐步表格推理来动态生成并执行针对表格的常见SQL/数据帧操作。该过程的迭代性质增强了中间结果,使 LLM 能够通过逻辑可视化推理链进行预测。值得注意的是,Chain-of-Table 在 TabFact 上平均提高了 8.69%,在 WikiTQ 上平均提高了 6.72% 的基准表格数据集性能。
语言模型已经彻底改变了文本生成,然而它们对有限、静态训练数据的依赖阻碍了准确的回答,尤其是在需要外部知识的任务中。传统的提示方法不够充分,需要昂贵的重新训练。检索增强生成(RAG)成为一种新的解决方案,无缝地将信息检索融入到提示过程中。RAG 分析用户输入,构建一个有针对性地查询,并在预先构建的知识库中搜索相关资源。检索到的片段被纳入原始提示,为其提供上下文背景。增强后的提示使 LLM 能够生成富有创意且事实准确的响应。RAG的敏捷性克服了静态限制,使其成为需要最新知识的任务的游戏规则改变者。RAG 在 ODQA 测试基准上优于序列到序列模型和任务特定架构,实现了高达 56.8% 的精确匹配分数(TriviaQA)和 44.5%(Natural Questions)。
与以往将推理和行动分开处理的研究不同,ReAct [Yao等人,2022年] 允许 LLMs 同时生成推理轨迹和任务特定动作。这种交替过程增强了推理和行动之间的协同作用。ReAct 通过与简单的维基百科 API 进行交互来处理幻觉和错误传播问题,从而促进模型在处理异常情况时诱导、跟踪和更新行动计划。ReAct 在各种语言和决策任务中得到了应用,证明了其相对于最先进的基准线的有效性。值得注意的是,在问答(HotpotQA)和事实验证(Fever)中,ReAct 制定了更可解释的任务解决轨迹。此外,在 ALFWorld 和 WebShop 等互动式决策基准上,ReAct 超越了模仿学习和强化学习方法,分别取得了 34% 和 10% 的显著成功率,即使在很少的上下文示例的情况下也是如此。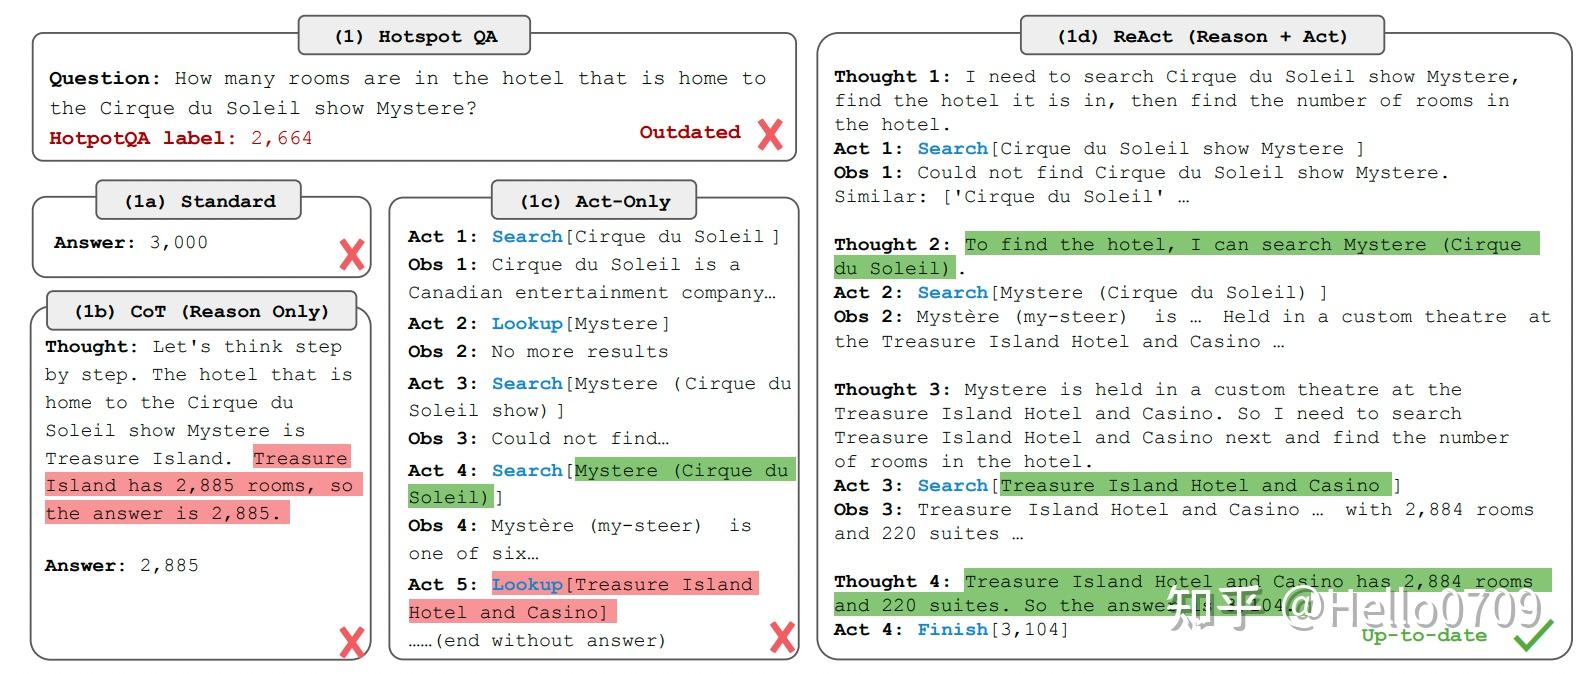
为了解决语言模型中的幻觉,[Dhuliawala等人,2023年]提出了Chain-of-Verification(CoVe),这是一个包括四个步骤的系统过程:Baseline Response、Plan Verifications、Execute Verifications、Final Verified Response。通过这种精心设计的多步方法来验证其工作,语言模型增强了逻辑推理能力,并在矛盾信息的情况下减少了错误。CoVe 模拟了人类对模型输出的一致性和准确性的验证。对列表问题、QA 和长篇生成的实验表明,CoVe 在保持事实的同时减少了幻觉。关注验证问题可以帮助模型识别和纠正不准确性。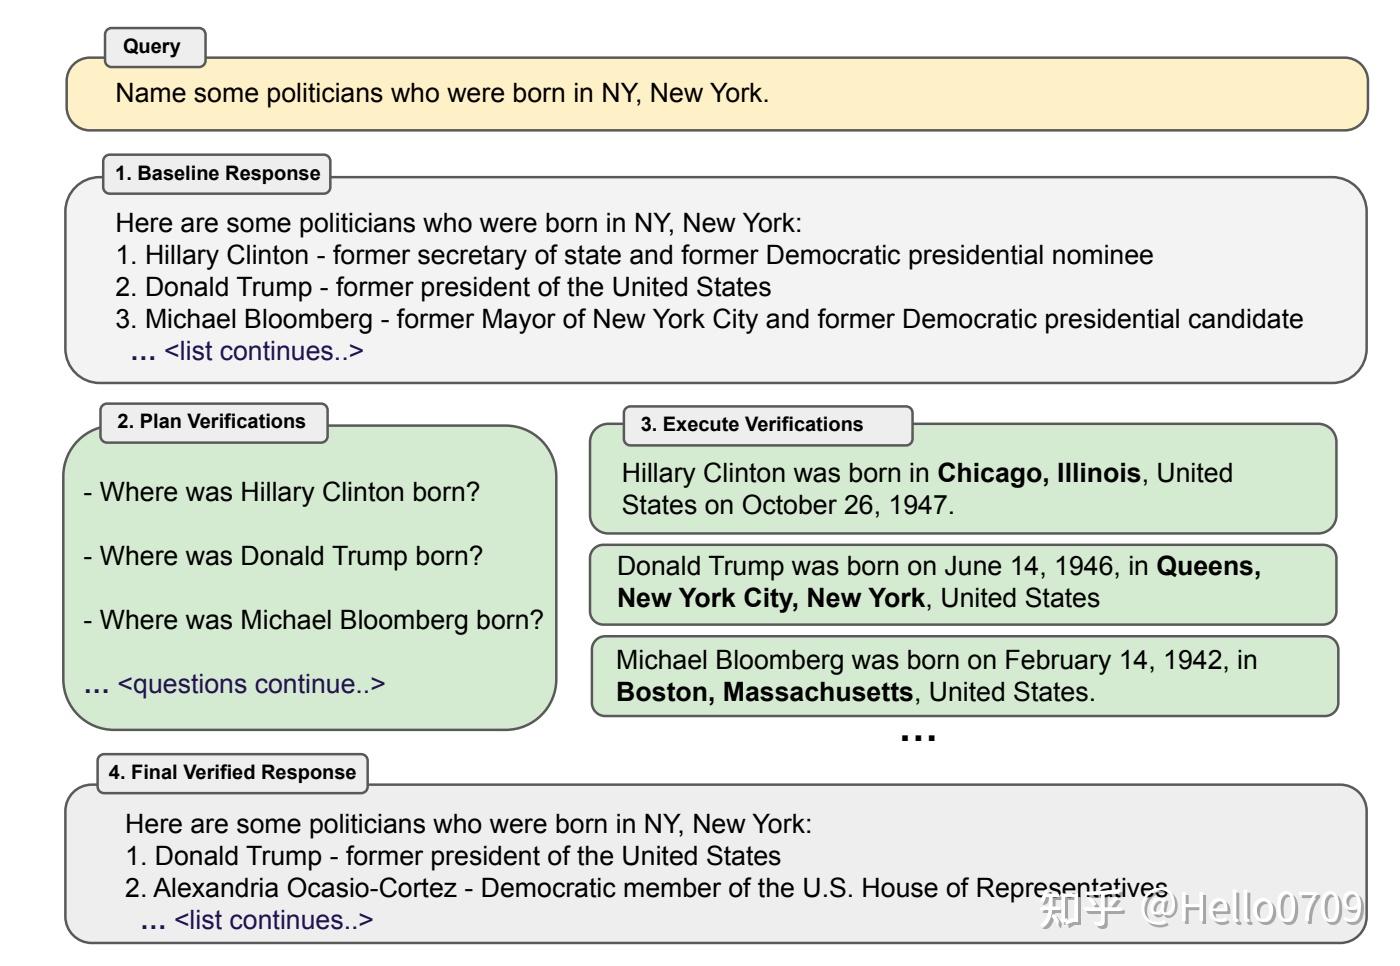
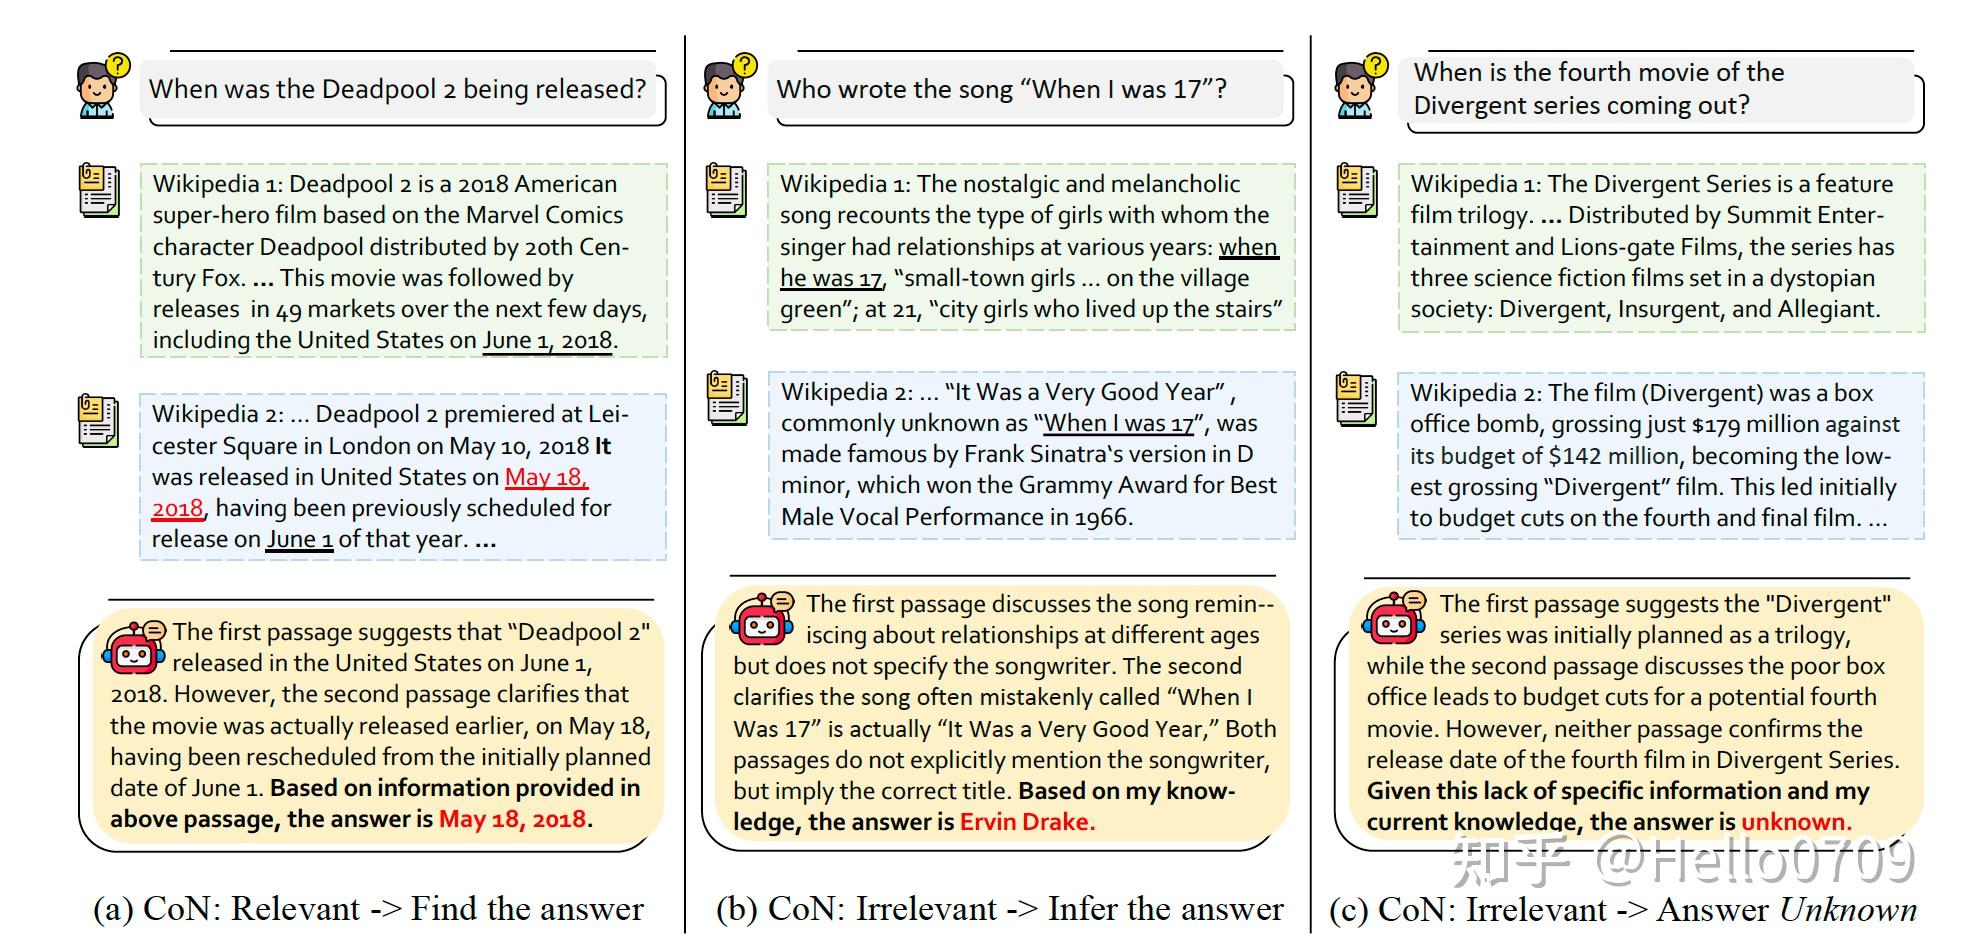
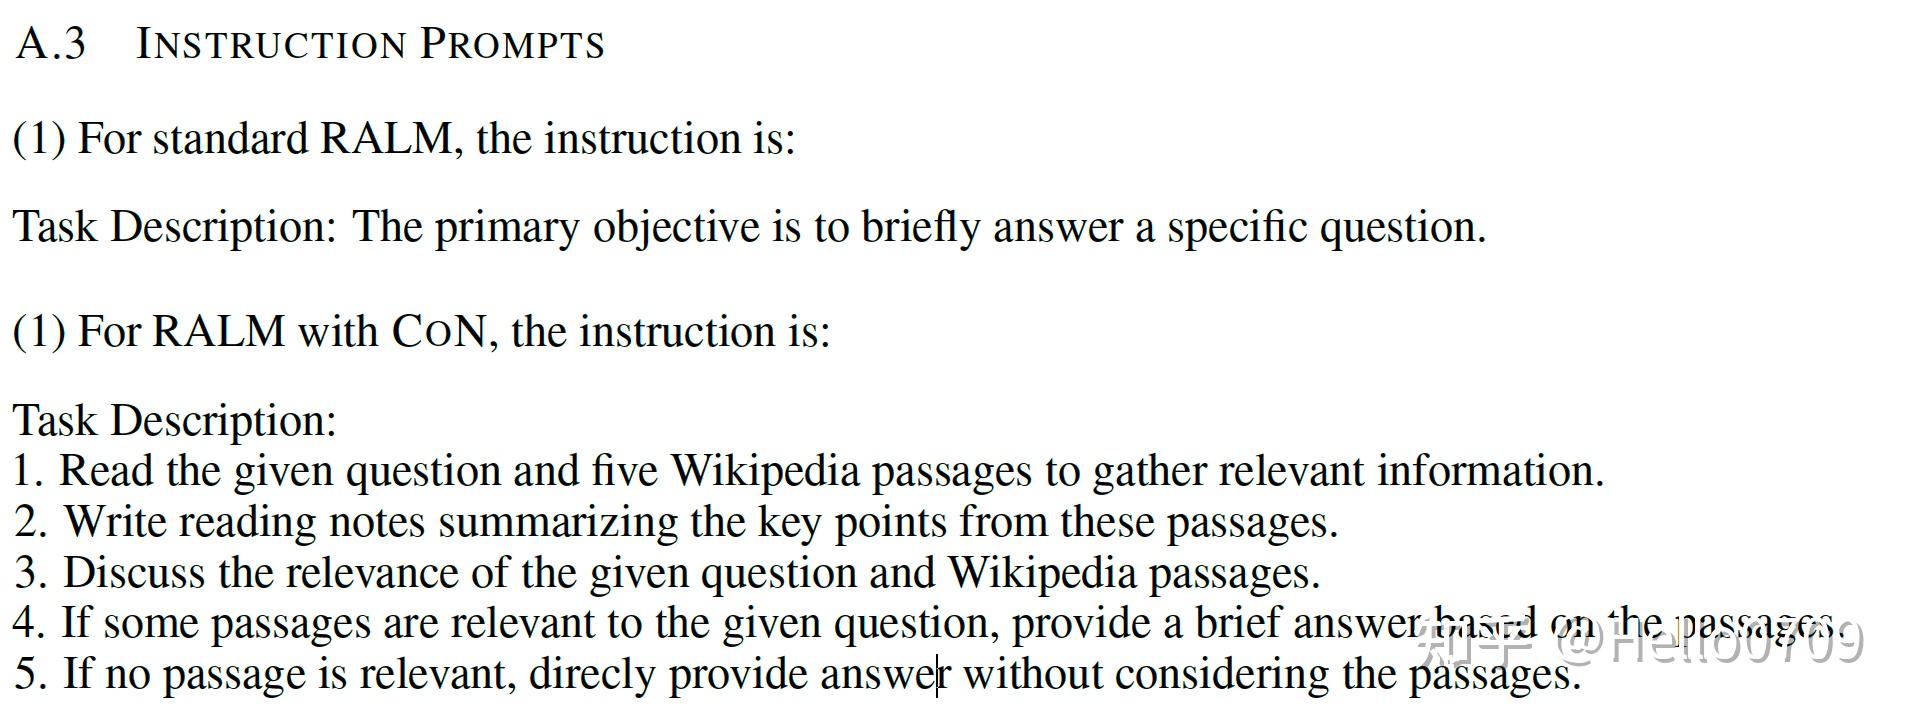
检索增强语言模型(RAMLs)通过整合外部知识来减少事实臆想,从而增强大型语言模型。然而,检索到的信息的可靠性无法保证,可能会导致潜在的误导性响应。标准RAMLs难以评估其知识的充足性,并且在缺乏信息时经常不能以“未知”方式做出回应。为了解决这些挑战,[Yu等人,2023年]引入了一种新颖的方法来提高RAMLs的鲁棒性,该方法可以处理噪声、不相关的文档并准确地解决未知情况。CoN系统地评估了文档的相关性,强调关键和可靠的信息以过滤掉不相关内容,从而产生更精确和上下文相关性的响应。在各种开放领域的问答数据集上进行测试表明,这显著提高了准确性,包括对于嘈杂检索文档的精确匹配得分平均提高了7.9分以及对超出预训练知识的问题拒绝率提高了10.5分。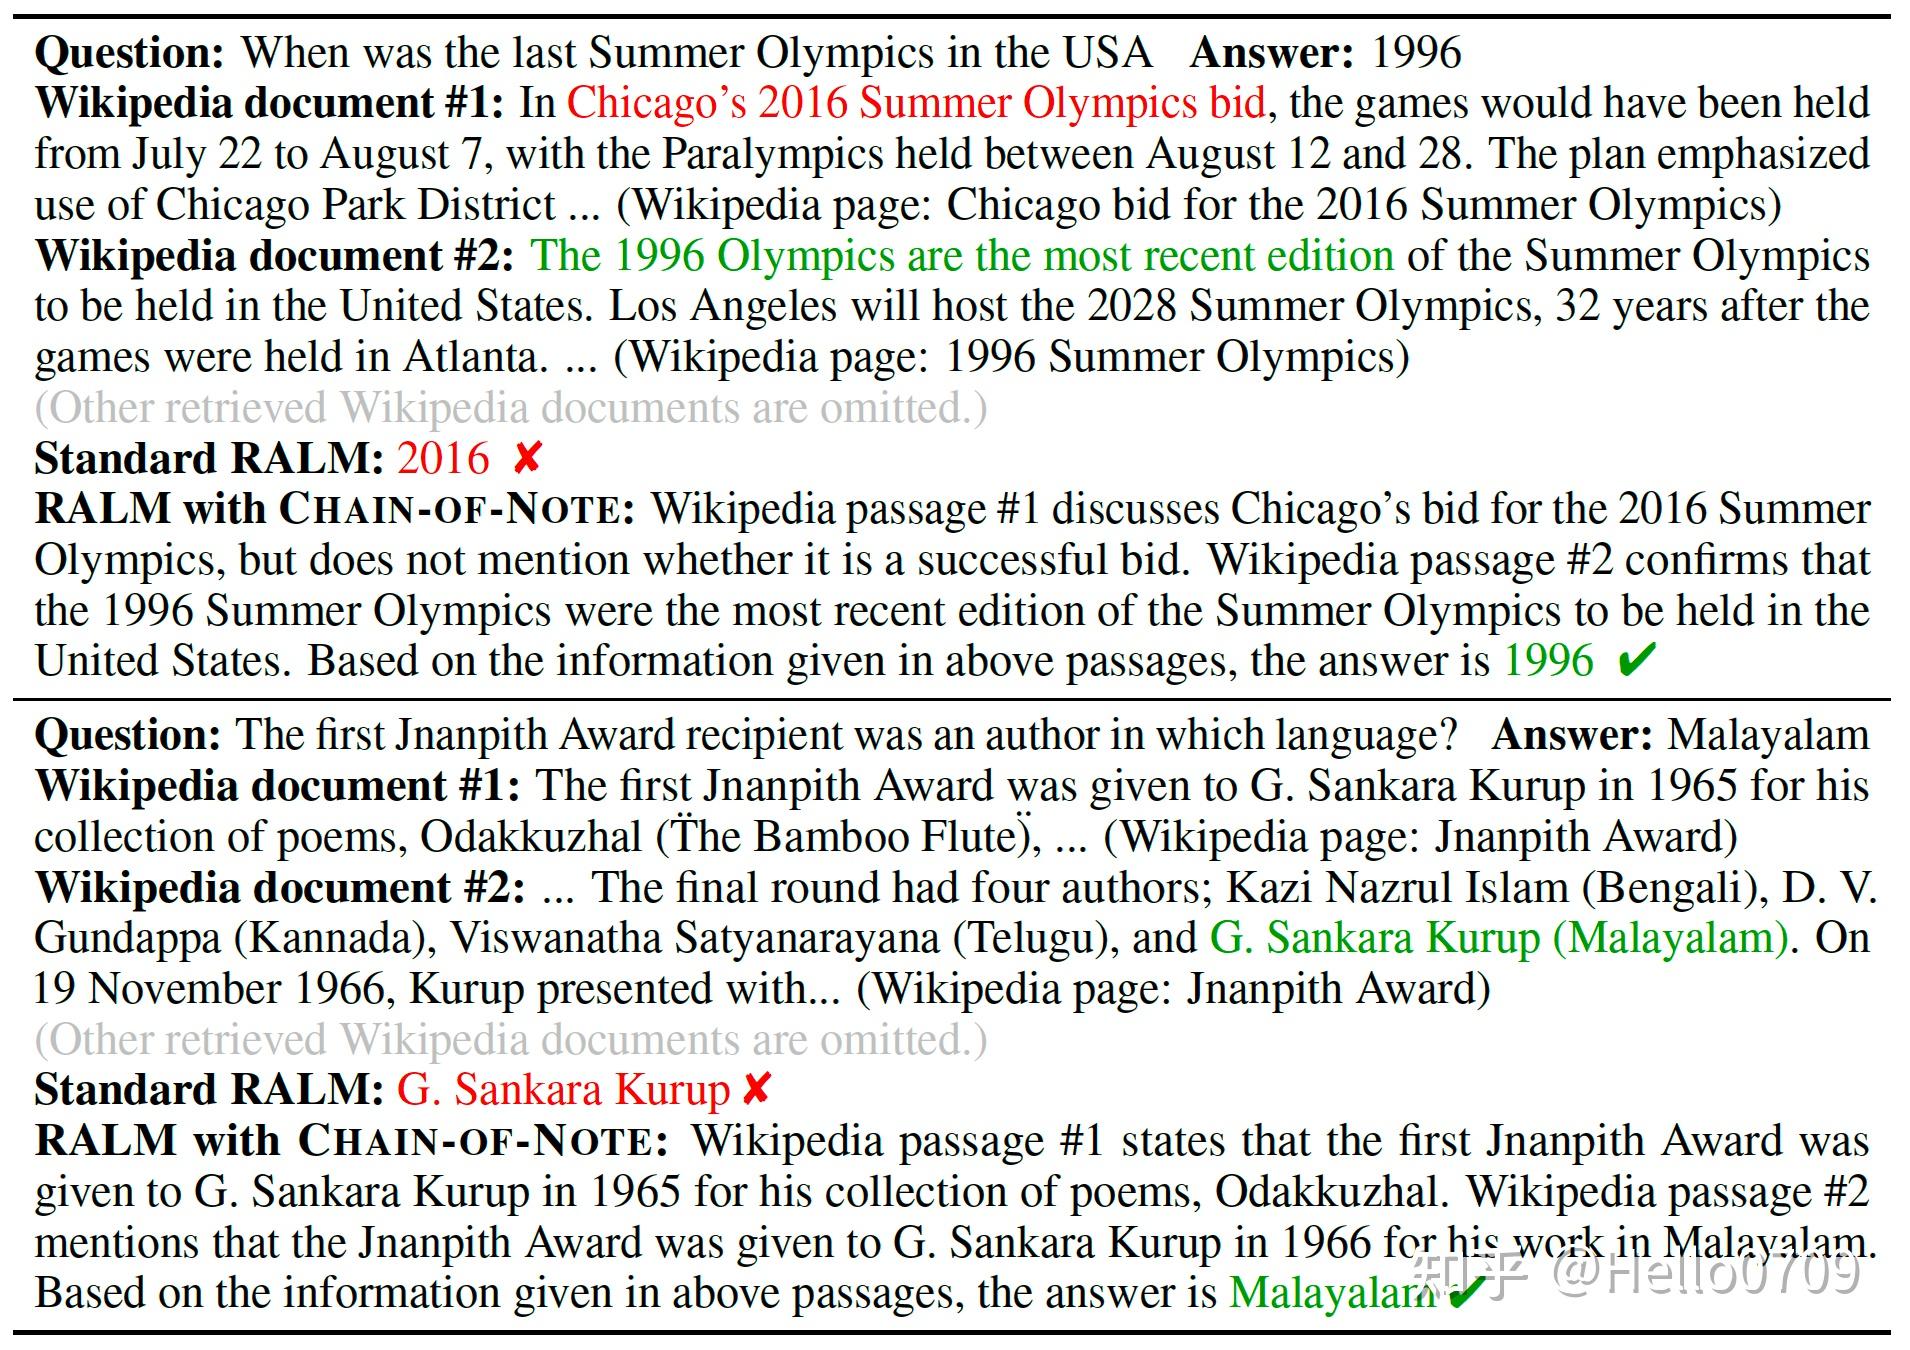
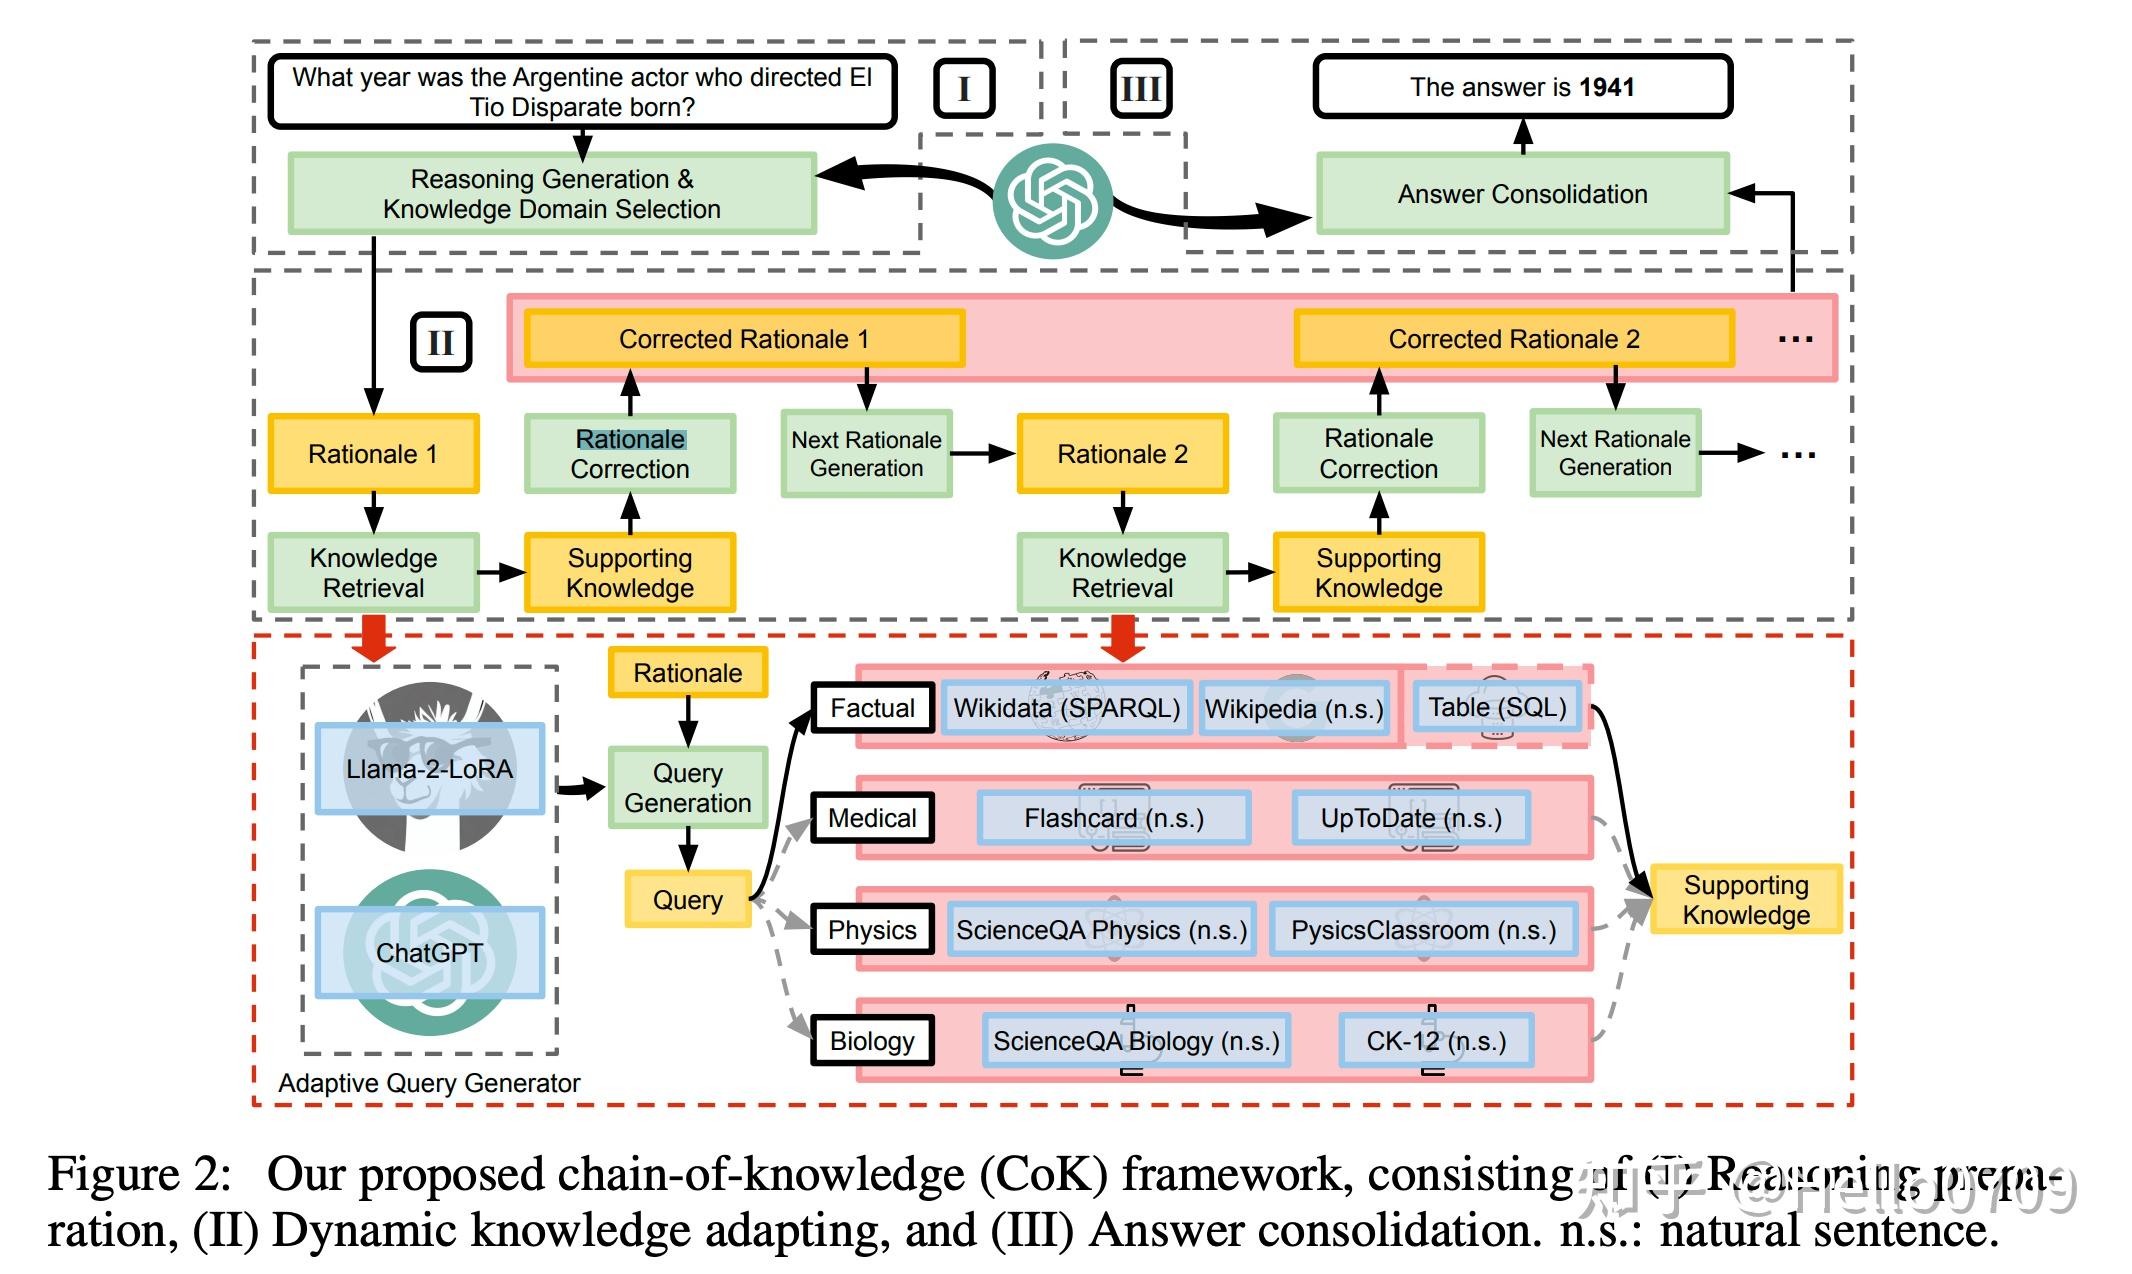
传统的语言模型提示技术已被证明在处理基本任务方面具有强大的能力。然而,由于复杂的推理挑战,它们的有效性会降低,通常会导致不准确的输出,这些输出充满了事实上的幻想和晦涩难懂的思想过程。这种局限性源于它们对固定知识源的依赖、无效的结构化查询生成以及缺乏渐进式纠正,无法充分引导 LLM。受人类解决问题的启发,CoK [Li等人,2023d] 系统地将复杂任务分解为协调良好的步骤。该过程从一个简单的起点开始:全面推理准备阶段,上下文得到建立,问题被构思。随后,它会进入动态知识适应阶段,从其内部知识库、外部数据库以及给定提示等不同来源精心收集证据。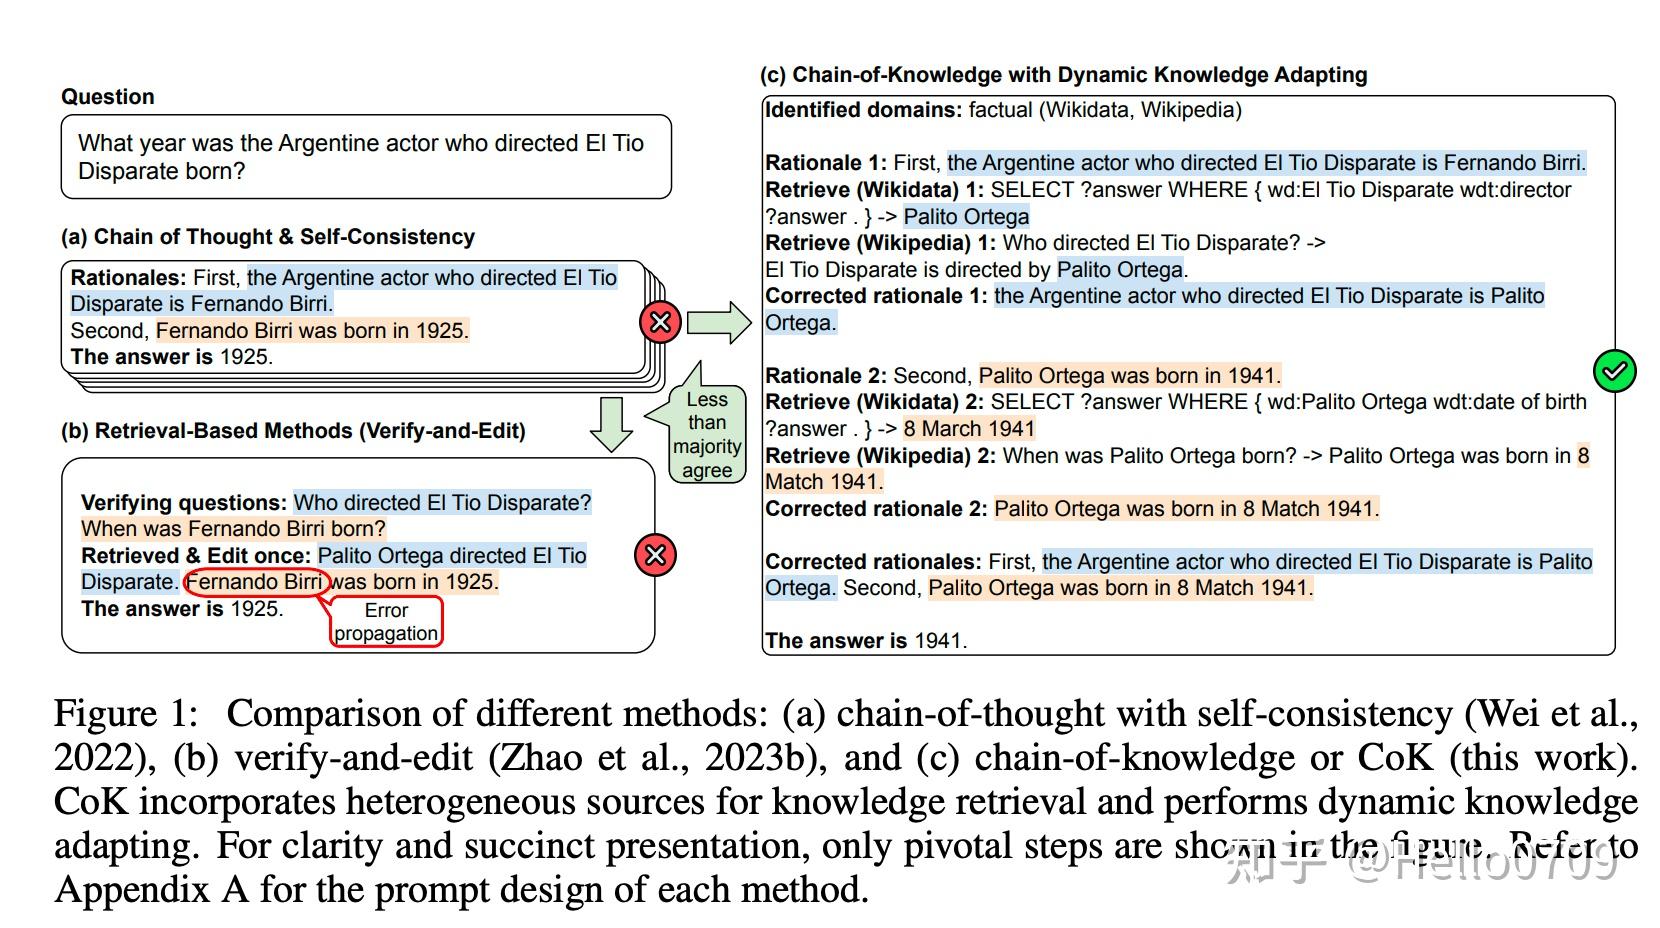
[戴等,2023年] 引入了主动提示来解决适应 LLM 多样化推理任务的挑战。他们通过提出主动提示来解决这个问题,即通过特定于任务的示例提示链式思维 (CoT) 推理来提高 LLM 在复杂问答任务上的性能。与现有基于 CoT 的方法不同,这些方法依赖于固定的人类注释示例集,主动提示引入了一种机制来确定最有影响力的注释问题。该方法借鉴了基于不确定性的主动学习,并利用各种指标来表征不确定性并选择最不确定的问题进行注释。主动提示显示出了优越的表现,在文本 davinci-002 和代码 davinci-002 中平均比自我一致性高 7.0% 和 1.8%,展示了最先进的结果。
虽然为 LLM 创建有效的提示传统上是一项艰巨的任务,需要专家注释人员的努力,[周等人,2022]引入了自动提示工程师(APE)作为生成和选择 LLM 指令的创新方法。APE 通过动态生成并针对特定任务选择最具影响力的提示来摆脱静态、手工设计的提示的局限性。这种方法分析用户输入,制定候选指令,然后利用强化学习选择最佳提示,并根据上下文进行实时调整。对多样化的 BIG-Bench 套件和 CoT 推理任务的广泛测试揭示了 APE 的威力,在大多数情况下(24 项任务中的 19 项)超过了人类编写的提示,并显著提高了 LLM 的推理能力。这一自动提示工程的突破为 LLM 提供了解决更广泛任务范围的能力,从而以更高的效率和适应性解锁它们在各种应用中的全部潜力。
有限的推理能力和缺乏外部工具的使用阻碍了 LLM 在复杂任务中的潜力。[Paranjape 等人,2023 年] 引入了自动推理与工具使用 (ART),以克服这一关键障碍,使 LLM 能够通过多步过程进行推理,并无缝集成外部专业知识。ART 拯救了推理鸿沟,使 LLM 能够解决复杂问题并超越简单的文本生成。通过整合外部工具来获取专门知识和计算,ART 解锁了前所未有的多功能性,并用现实世界的相关性告知 LLM 输出。这使得 LLM 能够为科学研究、数据分析甚至决策支持等多样化领域做出贡献。
ART 模型通过结构化程序引导推理步骤,超越了传统的提示技术,消除了繁琐的手工制作需求。其动态工具集成确保了顺畅的合作,暂停生成以整合外部工具输出,并无缝恢复流程。在 Bigbench 和 MMLU 等具有挑战性的基准测试中进行的经验性验证表明,ART 的有效性超过了传统提示,在某些情况下甚至可以与手工演示相媲美。
传统的大规模语言模型提示通常会遗漏一个关键元素:从错误中学习。这就是对比思维链提示(Contrastive Chain-of-Thought Prompting,CCoT)[Chia 等人,2023 年] 要解决的问题,它为原始提示提供有效和无效推理示例。想象一下,在地图上探索正确的道路和需要避免的错误转弯——这就是对比思维链的优势!这种双重视角的方法在像 SQuAD 和 COPA 这样的推理基准测试上进行了测试,促使语言模型进行逐步推理,导致战略和数学推理评估比传统的连锁思维提示提高 4%-16%,进一步通过自我一致性技术提高了约 5%。然而,对于这种方法仍然存在一些问题,例如自动化生成各种问题的对比演示以及将其应用于推理之外的其他 NLP 任务的应用性。
虽然语言模型在各种任务上都表现出令人印象深刻的能力,但它们理解心理和情感线索的能力仍不确定。李等人(2023a)的研究通过引入EmotionPrompt解决了人们对语言模型理解情感线索能力的不确定性。他们从心理学的角度研究了语言对人类表现的影响,并在提示中附加了11个情绪刺激句子,以增强语言模型的情商。实验结果表明,这些刺激与提示无缝集成,显著提高了语言模型在各种任务中的性能。EmotionPrompt 在指令引导上的相对改进率为8.00%,在 BIG-Bench 任务上实现了惊人的115%提升,这证明了它在增强语言模型处理情感信号能力方面的有效性。一项涉及106名参与者的评估显示,在使用EmotionPrompt时,生成任务的性能、真实性、责任度指标平均提高10.9%,而标准提示相比则没有这种效果。
尽管基于Transformer的语言模型在生成基本编程任务代码方面表现出色,但它们在需要精确推理的复杂、多步骤算法计算中遇到了挑战。为了解决这个问题,[Nye等人,2021年]提出了一种新的方法,侧重于任务设计而不是模型修改,并引入了“便笺”概念。该提议使模型能够在提供最终答案之前生成任意顺序的中间标记序列。便笺提示技术优于 MBPP-aug,其成功率高达 46.8%。结合 Codenet 和单行数据集可实现最佳性能,正确输出率可达 26.6%,完美轨迹可达 24.6%。Scratchpad 提示技术存在局限性,包括固定的上下文窗口大小为 512 个标记以及对监督学习的依赖,用于 scratchpad 的使用。
由于语言模型容易出错、无法处理复杂的方程式以及表达迭代计算的低效性,因此它们在解决数学表达式方面并不理想。为了提高语言模型的数值推理能力,[陈等,2022年] 提出了思维程序(Program-of-Thoughts,PoT)提示,建议使用外部语言解释器来执行计算步骤。PoT使像Codex这样的模型能够通过可执行的Python程序来表示推理过程,与CoT提示相比,在涉及数学单词问题和金融问题的数据集上平均性能提高了约12%。
语言模型在代码生成方面表现出了令人印象深刻的能力。广泛使用的连续提示涉及在生成代码之前产生中间自然语言推理步骤。尽管它在自然语言生成方面的有效性,但当应用于代码生成任务时,连续提示显示准确性较低。[李等人,2023年c]介绍结构化链式思维(SCoTs)作为专为代码生成而设计的创新提示技术。通过将程序结构(序列、分支和循环结构)纳入推理步骤,SCoTs 提示增强了 LLM 在生成结构化源代码方面的性能。这种方法明确地指导 LLM 考虑来自源代码的要求,从而提高了它们的整体效率与 CoT 提示相比,在代码生成方面。作者验证了 SCoTs 在 ChatGPT 和 Codex 上的有效性,并且在三个基准测试(HumanEval、MBPP 和 MBCPP)中表现出比 CoT 提示优越的表现高达13.79%。
虽然连续提示对于提高语言模型(LMs)的语义推理能力非常有效,但它在处理需要数值或符号推理的问题时却步履维艰。[李等人,2023年]介绍了Chain-of-Code (CoC)作为扩展,通过利用代码编写来改善基于逻辑和语义任务的推理。CoC鼓励LMS以灵活的伪代码格式化语义子任务,使解释器能够捕获未定义的行为,并使用“LMulator”进行模拟。实验表明,CoC优于链式思维和其他基准线,在BIG-bench Hard上达到84%的准确率,提高了12%。CoC在大型和小型模型中都证明了其有效性,通过采用“用代码思考”的方法,增加了对推理问题正确回答的能力。
在各个领域,优化是一种基本过程,通常涉及迭代技术。[杨等,2023年]简介-提示比较范围OPRO 是一种新颖的方法,利用 LLM 作为优化器。与传统方法不同,OPRO 利用自然语言提示根据问题描述迭代生成解决方案,从而快速适应不同的任务并定制优化过程。通过针对线性回归和旅行推销员问题等经典问题的案例研究展示了 LLM 的优化潜力。此外,它还探讨了在自然语言处理任务中最大化准确性的提示优化,并强调了 LLM 的敏感性。实验表明,在小训练集上优化提示以提高准确性有效地转化为测试集上的高性能。OPRO 引领着显著的性能提升,其中 OPOR 最有效的提示在 GSM8K 数据集上优于人类设计的提示高达 8%,在 Bigbench 中的挑战性任务上高达 50%。
邓等人 (2023)的研究指出了探索LLM时经常被忽视的一个维度:人类思维框架与LLM之间的差异,并引入了“改写并回应”(RaR)。 RaR允许LLM在单个提示中重述和扩展问题,证明理解力和响应准确性的提高。包括改写和响应的两步RaR变体,在各种情况下实现了显著的性能提升。重新表述的问题与随意提出的人类查询形成对比,有助于提高语义清晰度并解决固有的歧义。这些发现为理解并增强各种应用中 LLM 的有效性提供了有价值的见解。
为了解决复杂的多步推理这一持续存在的挑战,[郑等人,2023年]引入了针对像PaLM-2L这样的高级语言模型量身定制的Step-Back提示技术。这种创新的方法使模型能够进行抽象,从特定实例中提取高层次的概念和基本原理。Step-Back提示方法涉及一个两步过程,整合了抽象和推理。通过广泛的实验,在诸如STEM、知识问答和多跳推理等需要密集推理的各种任务中应用Step-Back提示,结果表明推理能力显著提高。观察到显着性能提升,例如MMLU Physics和Chemistry任务提高了7%,TimeQA提高了27%,MuSiQue提高了7%。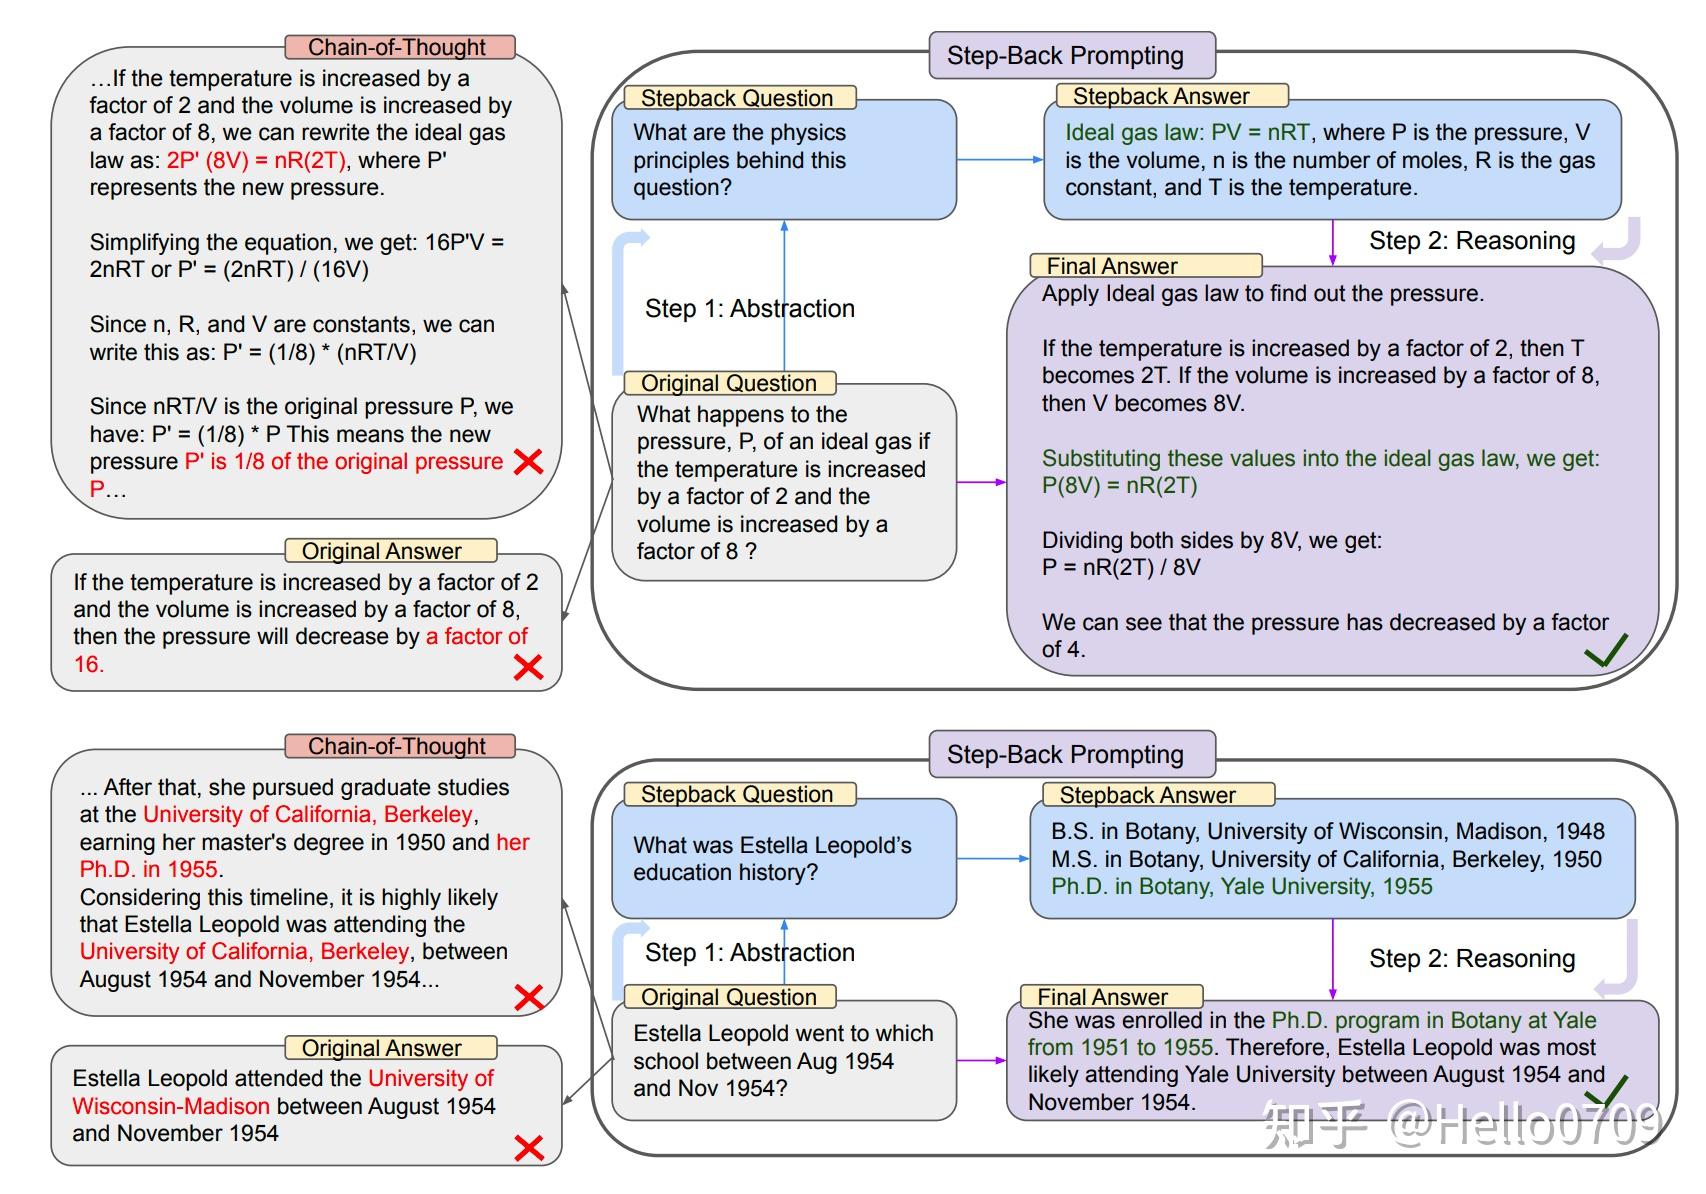
在人工智能领域,提示工程(prompt engineering)已经成为一种变革性的力量,释放了LLMs的巨大潜力。本文旨在作为基础系统地分类了29种不同的提示工程方法,根据它们针对的功能进行分类,进一步启发了对提示工程的研究,并赋予了创新者在提示工程不断演变的景观中的力量。分析涵盖了应用、模型和数据集,揭示了每种方法的优点和局限性。此外,我们还添加了一个图表和一个表格来突出重要的观点。尽管取得了显著的成功,但挑战依然存在,包括偏见、事实不准确和可解释性差距,需要进一步研究和缓解策略。提示工程的未来充满巨大的潜力,新兴趋势如元学习和混合提示架构有望增强能力。然而,道德考虑至关重要,强调负责任的发展和部署,以确保我们的生活积极融入其中。
大模型SFT真的能学到新知识吗?
从样本的角度看如何提升大模型微调的性能
Prompt Engineering综述
Dolma: an Open Corpus of Three Trillion Tokens for Language Model Pretraining Research
helloai:[论文阅读]大型语言模型检索增强生成综述
检索噪声对RAG有没有用?
LLM内部先验知识与RAG冲突了怎么办?