规格参数与使用规范
给大家推荐两个基于大规模预训练模型的智能应用开发大赛,总奖金有125万元。两个比赛的任务是一样的,奖金数不同。
比赛任务是在超大规模预训练模型“悟道2.0”的基础上,结合社会热点主题——健康医疗、教育学习、社交生活、效率工具、环境自然等开发新颖实用的智能应用。
大赛开放了包括:文本生成、图片生成、写诗、新闻生成等9个“悟道”大模型API 接口,参赛者不仅能够免费使用这些功能,还能够直接下载“悟道”模型用于应用开发。 具体可以点击下方卡片了解:
点击!
报名去!12月19号,还有小一个月!做方案来得及!
知道这个消息之后,真是,始惊,后醉,终狂~~~
这是目前知道的最top的,奖金池最丰厚的关于超大规模语言模型方面的创性创造性的竞赛了!
本来在写其他的若干paper的idea总结,最近几天突然看到鹏飞大神的这篇文章,顿时热血沸腾了,依稀回到当年一起在度厂的那些好时光(当时是鹏飞大神在度厂NLP实习)。https://arxiv.org/pdf/2107.13586.pdf
我也是第一次看这个综述文章,只能是一边学,一边写了。目前的记忆,只有gpt3的prompts,以及之前写的一篇关于P-tuning的paper:迷途小书僮:[细读经典]P-tuning:用“连续提示微调”来增强“超大规模语言模型”的下游能力
好,走起:
首先这个词,"paradigm"用的真好,“范式”的翻译也很传神,不禁想起在度厂和保安干了几个回合的某大神创立的第?范式的独角兽AI公司。哈哈,为毛我写这些八卦。。。正如《教父》所言,真正nb的人,需要准备迎接来自社会的“侮辱”,例如T10 vs. 保安 -- 保安胜!夏虫不可冬语。秀才遇到兵,有理也说不清啊。。。
行了。
“prompt-based learning",基于”提示“的学习。它和传统的DL+NLP的区别在哪里?看下表(左边一列是传统有监督机器学习;右边一列是”prompt-based learning“):P(y|x; Θ)输入x,输出y;参数集合Θ是根据
下面这个图,很传神地给出了x->x'->x''->y的”prompt-based learning“的具体几步的例子: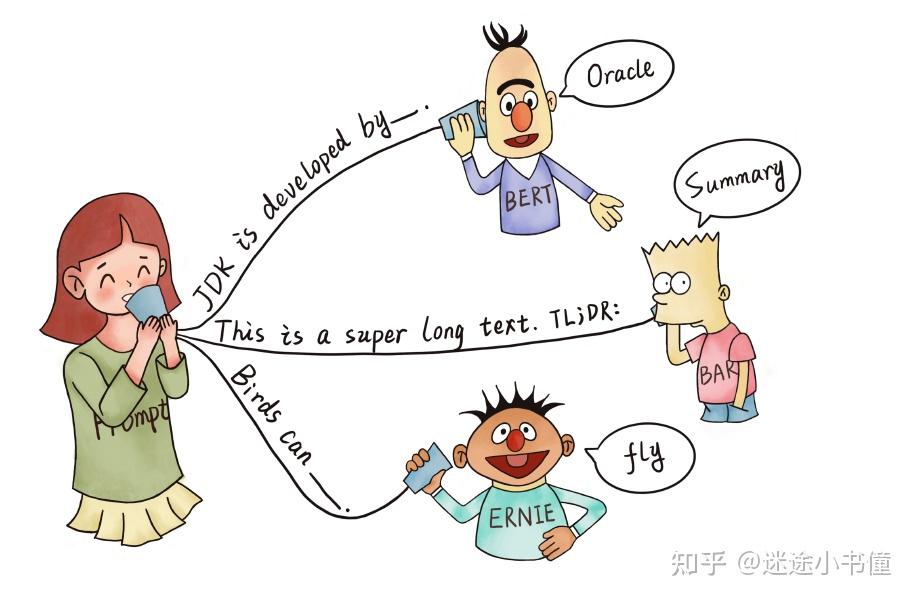
例如第一个例子,对应的知识图谱三元组应该是:
小女孩是prompt(出题的人);有三个预训练模型(答题者),ERNIE, BERT,BART,会根据出的具体的”填空题“,以及自己的目前储备的”知识“,来回答这些”填空题“。
另外,TL;DR=too long; don't read,一边是作为一个摘要的起始提示符。
该综述论文的主要贡献:
贡献一:介绍基础入门知识;
贡献二:给出统一化的数学定义;
贡献三:把目前的工作归类为若干方向,例如预训练模型的选择,提示和微调策略;
贡献四:建立一个资源分享和论文列表分类整理的”社区“:http://pretrain.nlpedia.ai/
鹏飞大神这里给出了一个超赞的总结表格,总结了这四次”范式“的“革命”: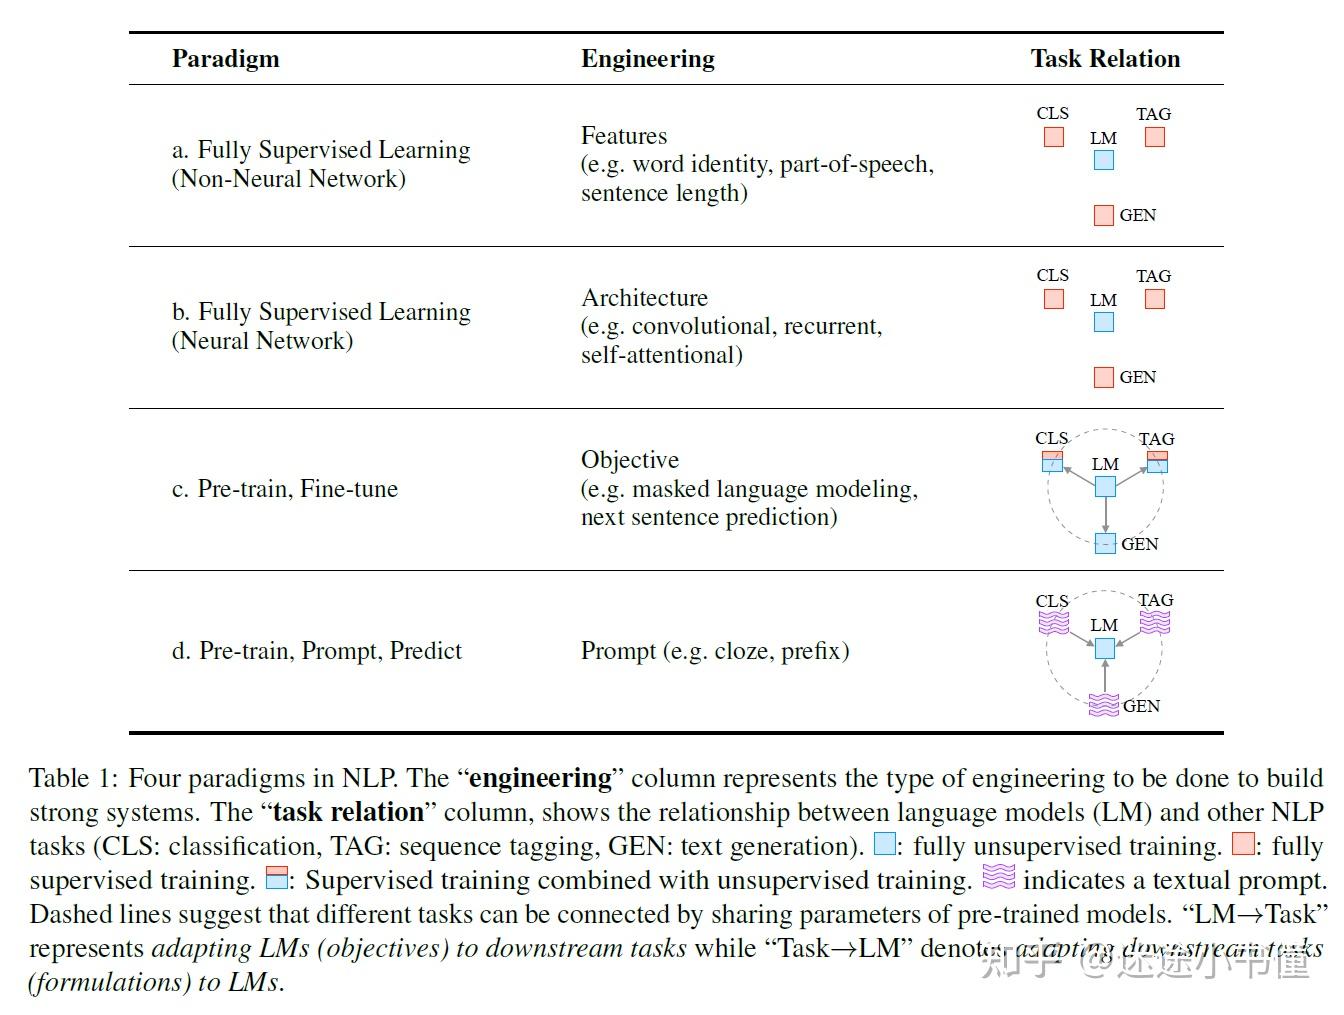
任务层面,概括分成了四类:CLS是分类任务(classification tasks,例如情感分析);TAG是序列标注(tagging,例如词性标注,命名实体识别);GEN是文本生成,例如生成式文本摘要;而LM即语言模型。
第一个纪元(范式):feature engineering-特征工程,纯有监督学习为主,例如分词,词性标注,命名实体识别,依存分析这些任务,首先需要一定规模的标注数据,然后学习模型参数,再基于模型对新的句子进行解码inference;截至2011年前后,特征工程是众多NLP从业者的主要的突击方向;
第二个纪元:architecture engineering-架构工程,以设计新奇神经网络为主的有监督学习为主。而这些“架构”,包括如,卷积神经网络,递归神经网络,并发神经网络,lstm,gru,自注意力网络,图神经网络,等等;截至目前,设计新的网络架构,仍然是一个颠覆性研究的突破点;
第三个纪元:objective engineering-目标工程,以设计新的预训练任务为代表,例如掩码语言模型预训练任务,下一个句子预测,句子顺序预测,等等;这个时候,多个种类的NLP任务之间,通过大规模语言模型,有效的连接到一起了。大概从ElMo, BERT, GPTx等模型开始,这个方向发展的如火如荼,也到了类似“大炼钢铁”的时代---甭管家里丹炉(GPU)有多大有多少,都可以炼丹了;这一时期的方法论,也被称为“预训练+微调”;
第四个纪元:prompt engineering-提示工程,例如填空,前缀等等,可以“诱发”、“检索”出大规模预训练语言模型中的,实际任务所需要的,“知识”为目的的“套路”。和第三纪元的大的区别在于,大规模预训练语言模型“不动”了(例如175B参数的gpt3,动不了了。。。微调依然调不动了。。。),而是让各个落地任务,各自准备自己的“抓手”,去LM里面抓取自己想要的。而这种抓的能力,也成为了这个纪元的重要的突破点。例如,硬抓,软抓,软饭硬吃(即明明是抓LM的知识,还要吐槽LM的知识不全之类的。。。甚至还要多个LM一起抓,从而对LM的学习到的知识来次大排名),等等。。。
“提示工程”相关的,具体的例子也有很多了,例如,I missed the bus today. I felt so ---,这个属于情感分析的;English: I missed the bus today. French: ---,这个属于英文翻译为法文的例子;
如果熟悉GPT3是如何被应用到实际任务的,上面的例子应该不陌生。
对于传统有监督机器学习而言,我们的目标是对如下”出场人物“进行建模:
P(y|x, ),其中x是输入“文本”,y是输出“标签”,或者“文本”,或者其他形式;模型参数
是待学习的。例如对于“文本分类任务”,x="I love this movie",而y=++,其可选值的集合为
;再如,有条件的文本生成,如x="我爱中国“,y="I love China",则是中文翻译为英文的任务。
然而,
在现实世界中,构建人工标注的
而,超大预训练语言模型可以表示为P(x| ),是对文本x的直接建模;然后我们想从这个P(x|
)来直接预测/生成y。这在一定程度上对P(y|x,
)的直接建模进行了”解耦“,这样也就不再依赖人工标注数据
下面的Table 2,又是一个nb的关于prompting methods的总结: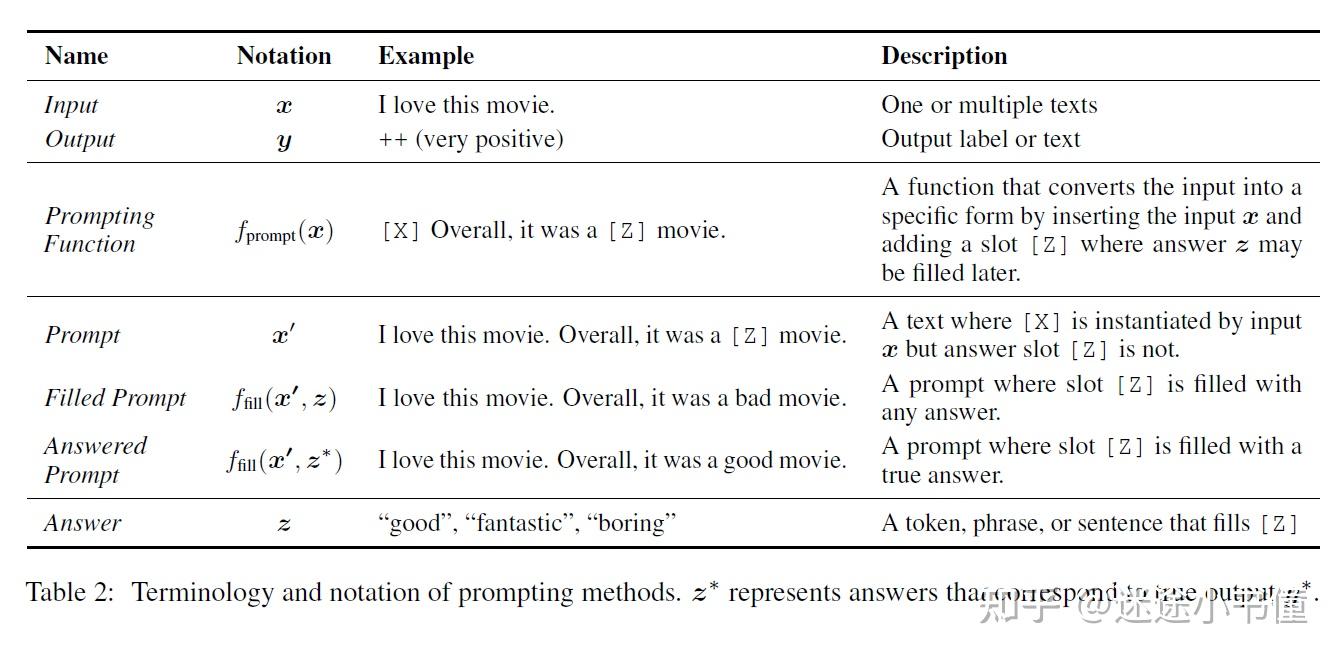
看看”出场人物“-之-”prompting function - 提示函数“:prompting function - 提示函数, ,其负责把输入文本x变换为一个prompt x',即:
。而这个函数包括”两步“:第一步,应用一个“模板”,其应该包括一个输入slot [X],和一个答案slot[Z],而[Z]后续会被映射给最终的输出y;第二步,用输入文本x填充slot[X];举例子:x="I love this movie.",假设我们有一个模板(别问我怎么得到的,无外乎:人工设定的 or 自动学习出来的),"[X] Overall, it was a [Z] movie.",这样的话,x'就是“I love this movie. Overall it was a [Z] movie". 这个句子就可以扔给例如BERT这样的预训练语言模型了。注意,这个[Z]不在句子末尾的例子,被称为”cloze prompt“-填空型提示。再看机器翻译的例子,”Chinese: [X] English: [Z]“,这样就可以把输入x=”好好学习“替换进来,得到x'=”Chinese:好好学习 English: [Z]“,从而让语言模型产出[Z]。注意,这个[Z]在句子的末尾,被称为”prefix prompt“-前缀型提示。(即,提示信息本身是”前缀“)另外,[X]和[Z]这样的slots的数量,可以根据具体的下游任务进行一定的变化。例如两个[X]槽,或者若干个[Z]槽。
然后是重要的“answer search”(答案搜索)阶段,即根据已有的LM,对[Z]的可能的取值集合 进行”搜索“,从而找到得分最高的候选文本
。
这里,取值集合 可以有若干取值,例如,(1)对于分类任务的话,
{"excellent", "good", "OK", "bad", "horrible"},其(用真实的自然语言的单词,来表示略微抽象的labels)表示的是若干真实的分类标签
={++, +, ~, -, --}。(2)当然,如果是文本生成任务,那么
的取值可以是整个词汇表。
正式地: 函数,或者”填充函数“,表示的是用一个候选答案z来填充prompt x'中的[Z]。一个prompt x'经过这个”填充过程“之后,得到的prompt,被称为filled prompt (填充后的提示)。这个”答案搜索“的过程,可以被表示为:
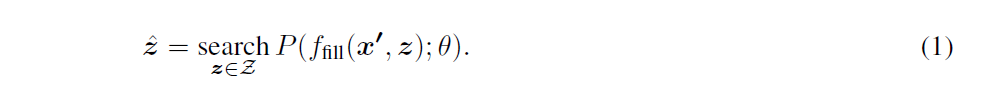
这里的P即,使用已有的预训练语言模型LM来对filled prompt打分得到的“概率”。
这个"search",可以有若干选择,例如(1)一个argmax搜索,搜索最高分的候选z;(2)一个采样算法,其依据训练好的语言模型来执行sampling操作得到候选答案。
最后,则是从候选z映射回具体应用任务定义的y了。例如上面的例子中的"excellent"对应到”++“。当然,这个映射,也可以是多个自然语言的词汇,对应到单个情感类别++。例如:
"excellent", "fabulous", "wonderful",这三个词都对应到一个class,”++“。
这里,鹏飞大神继续给出了一个巨nb的表Table 3,(个人感觉这个表总结的太好了),很好地总结了多个代表性的NLP任务,所对应的若干(人工设计的)“prompts”的例子: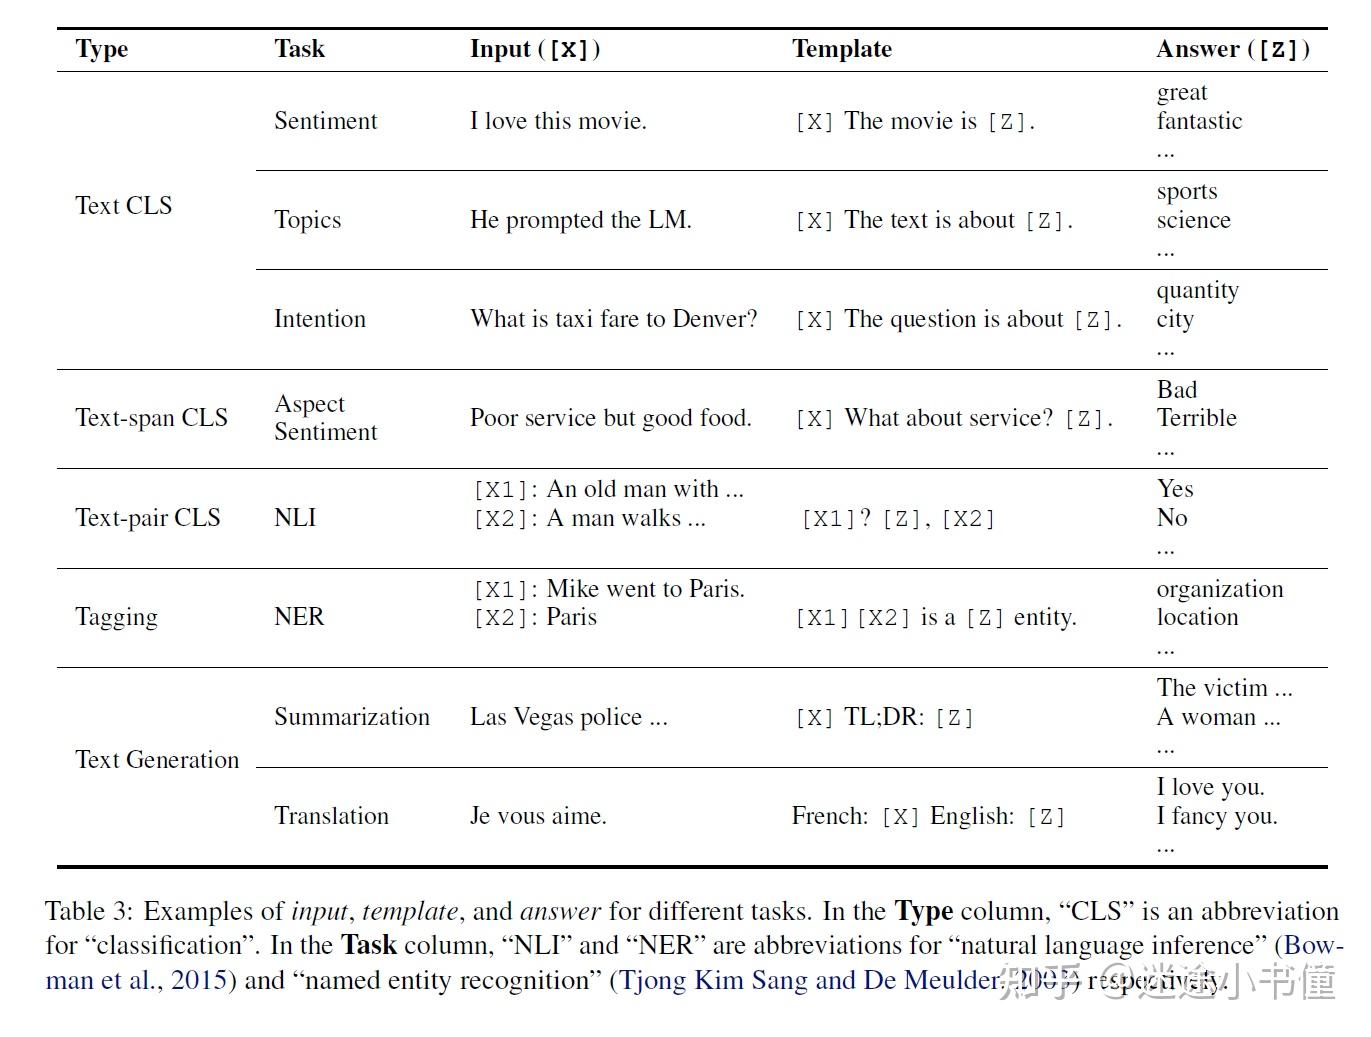
这里解读一下这个表,先看最左边一列,一共五种type:Text CLS,文本分类任务。这个任务,还可以再分成三个经典类型,例如(1)情感分析sentiment,输入是I love this movie.的例子,而使用的模板是[X] The movie is [Z]. 如果是这样的模板的话,大概只能是对movie进行分类了。(哈哈)。然后,回答是情感(带强度)词,例如,great, fantastic等;(2)文本“主题”分类任务,例如输入的文本text是He prompted the LM. 使用的文本是,[X] the text is about [Z].,然后语言模型试图去填充Z相关的这些slots。待预测的取值范围是“主题”类别,例如,"sports","city",等这样的具体的类别。(3)意图识别,特别是在chatbot的query意图识别的时候,这个任务会非常关键,即识别出来用户的意图,从而针对意图进行回复的准备。假设输入的query是,What is the taxi fare to Denver?,而人工构造的模板是,[X] The question is about [Z],候选的Z的取值包括,quantity,city等。Text-span CLS,文本片段的分类任务。例如,当一个句子中包括若干不同主题下的情感倾向的时候,提问可能是针对其中一点来询问情感倾向。例如,Poor service but good food. 服务不行,但是食物不错。这就可以具体对其中的一项进行情感分类了。例如,模板为[X] What about services? [Z],而这个slot的候选,可以是bad, terrible等,具有情感倾向的词。Text-pair CLS,文本对自然语言推理(分类)任务,例如NLI,自然语言推理(Natural language inference,NLI),是给定两个句子,让模型判断两个句子之间是否存在“推理”(因果关系)。例如,[X1]: An old man with ... [X2]: A man walks ...,而使用的模板是:[X1]? [Z], [X2],其中Z的取值是Yes或者No,分别代表了两个句子之间“有推理关系”,和“没有推理关系”。Tagging - 序列标注任务,例如NER=named entity recognition=命名实体识别,识别句子中的,人名,地名,机构名等的。例子,[X1]: Mike went to Paris. [X2]: Paris (地名),然后构造的模板是,[X1] [X2] is a [Z] entity。即对于本例子来说,是Mike went to Paris. Paris is a [Z] entity。 而这里的Z的取值范围为如organization, location等。(这样看的话,需要把一个句子中的每个词,或者每个n-gram都作为X2,扔给这个template,感觉有点慢。。。)Text Generation - 文本生成任务,有几个经典的应用,例如(1)摘要(生成式),例如给出一个文档,Las Vegas police ... 一大串文字,而使用的模板是[X] TL; DR: [Z],这里的:TL;DR可以是Too long; Didn't read(太长,所以没有看)。也可以是Too long; Don't read (太长,请不要看),常作为一篇很长的文章的摘要标题(这里作为“摘要”的提示开始符)。(2)翻译,这个前面的例子就很多,鉴于我完全不懂法语(我估计鹏飞大神也不懂。。。哈哈),简单用中文替换得了(虽然用法文做例子更好一点?毕竟中英文结合的预训练语言模型,可能相比,法英文相结合的预训练语言模型,更少一些)。输入的是中文句子,我在看奥运中国男团削棒子,模板为:Chinese: [X] English: [Z]。
上面的5个大的方向和例子,其实彰显了prompts-提示,的设计的重要性。可以看到,对于五种应用任务,每个prompt都具有自己的特点。这样的话,在人工或者自动构造这些prompts的时候,需要花费一些心思了。
哪些心思?
其一,预训练模型的选择(Section 3),各种bert, gptx, ernie, t5, megatron, pangu-alpha... 数以百计了,具体选择哪些,是一个根本性的问题;
其二,提示工程(Section 4),关于prompts的engineering,具体任务,具体prompts;这个其实可以参考P-tuning论文的如下的例子,可以看到,不同的prompts的“微妙变化”,都会导致最终精度的巨大变化:迷途小书僮:[细读经典]P-tuning:用“连续提示微调”来增强“超大规模语言模型”的下游能力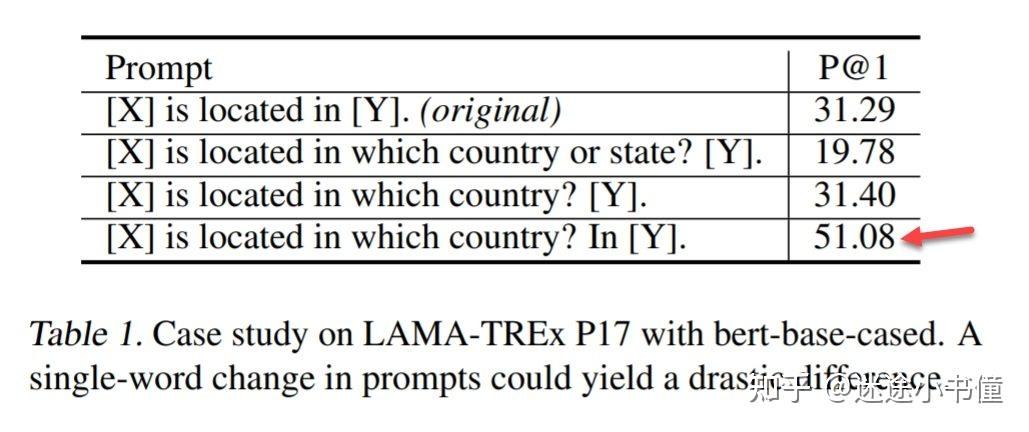
上面是同一个任务,只是prompts里面有小的词汇的变化,结果上居然可以相差20%甚至更多。。。简直颠覆认知了。。。
其三,答案工程(Section 5),关于answer的工程。根据任务的不同,答案Z的取值范围,Z的生成方法,在prompts中的位置,以及Z(例如,”excellent“)和Y(例如,"++")的映射关系都需要特别的处理;
其四,范式的扩展(Section 6),expanding the paradigm,鉴于prompts的微小的变化,都会带来结果的巨大变化,那么如何设计更具有“柔韧性”的,“鲁棒性”的,“扩展性“的prompts,是个课题;
其五,基于Prompts的训练策略(Section 7),例如Prompts可学习,LM可学习,或者两者兼而有之等。
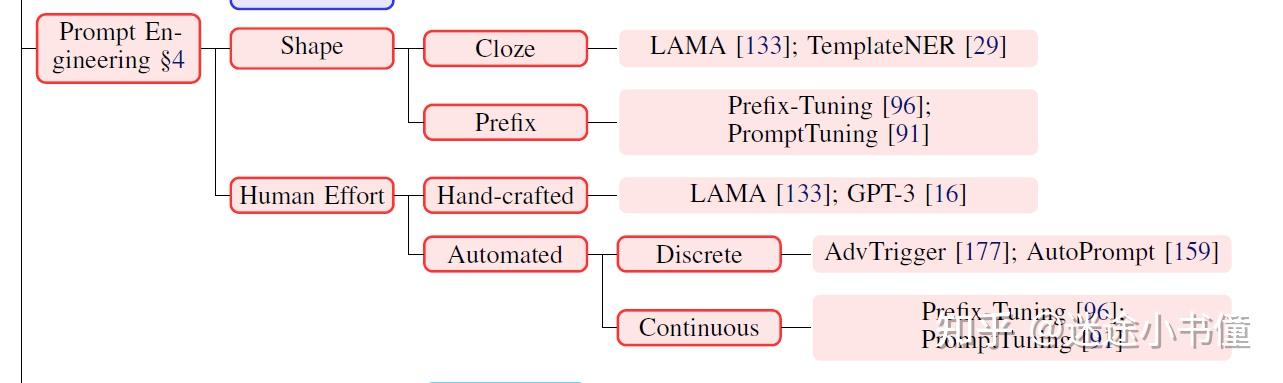
而针对上面的5大方向,下面的“技点树”很好地进行了总结:
(后续会针对这五大方向,分别展开描述)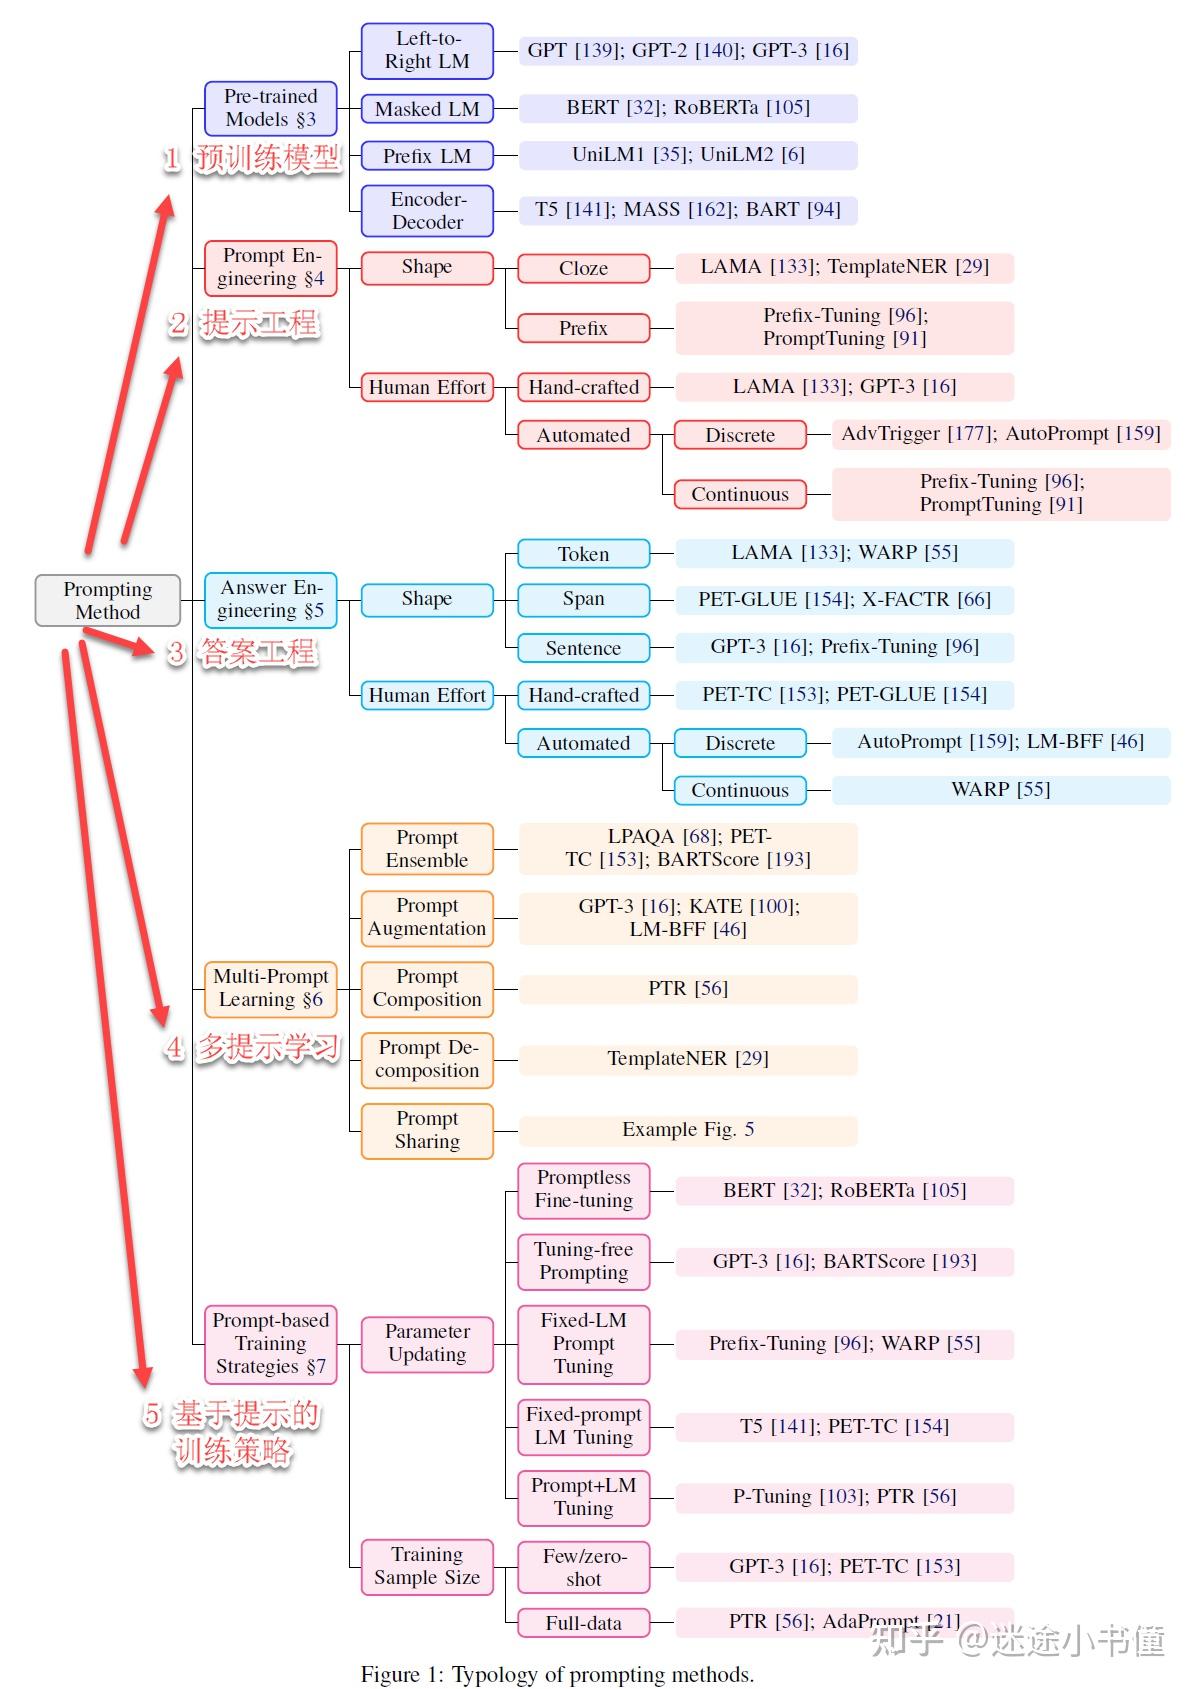
这部分的相关的技术分支和相关的代表性论文,如下图所示:
这部分,其实鹏飞大神的在复旦的老师,邱老师,之前有篇相当全面的综述性预训练模型的文章:Pre-trained Models for Natural Language Processing: A Survey
而我之前也写过两篇学习笔记:迷途小书僮:NLP中预训练模型的综述I[深度长文-慎点]迷途小书僮:NLP中预训练模型的综述2[深度长文-慎点]
在鹏飞大神的文章里面,在预训练模型方向,是针对四个方面进行了概括性划分:
方向一:从左到右LM;即,单向的,代表性的就是GPTx系列了,都是基于“自回归”来做的;
方向二:掩码LM;代表性的就是BERT, RoBERTa之类的模型了;
方向三:前缀LM;UniLM1,UniLM2,(其实和T5里面的seq2seq LM有相似的地方。。。);
方向四:编码-解码Seq2SeqLM;例如T5,MASS, BART,是Seq2Seq MLM类型的,即被mask掉的词,仍然有个先后预测关系,这样前一个被预测出来的词,可以协助后一个词的预测。
--
微软的UniLM (NeurIPS 2019 paper, https://arxiv.org/pdf/1905.03197.pdf) 则对MLM进行如下扩展:单向(针对例如长文本生成这样的任务),双向(GLUE基准任务,抽取式阅读理解QA),以及seq2seq(自动摘要,问题生成,生成式QA)。具体如下图所示: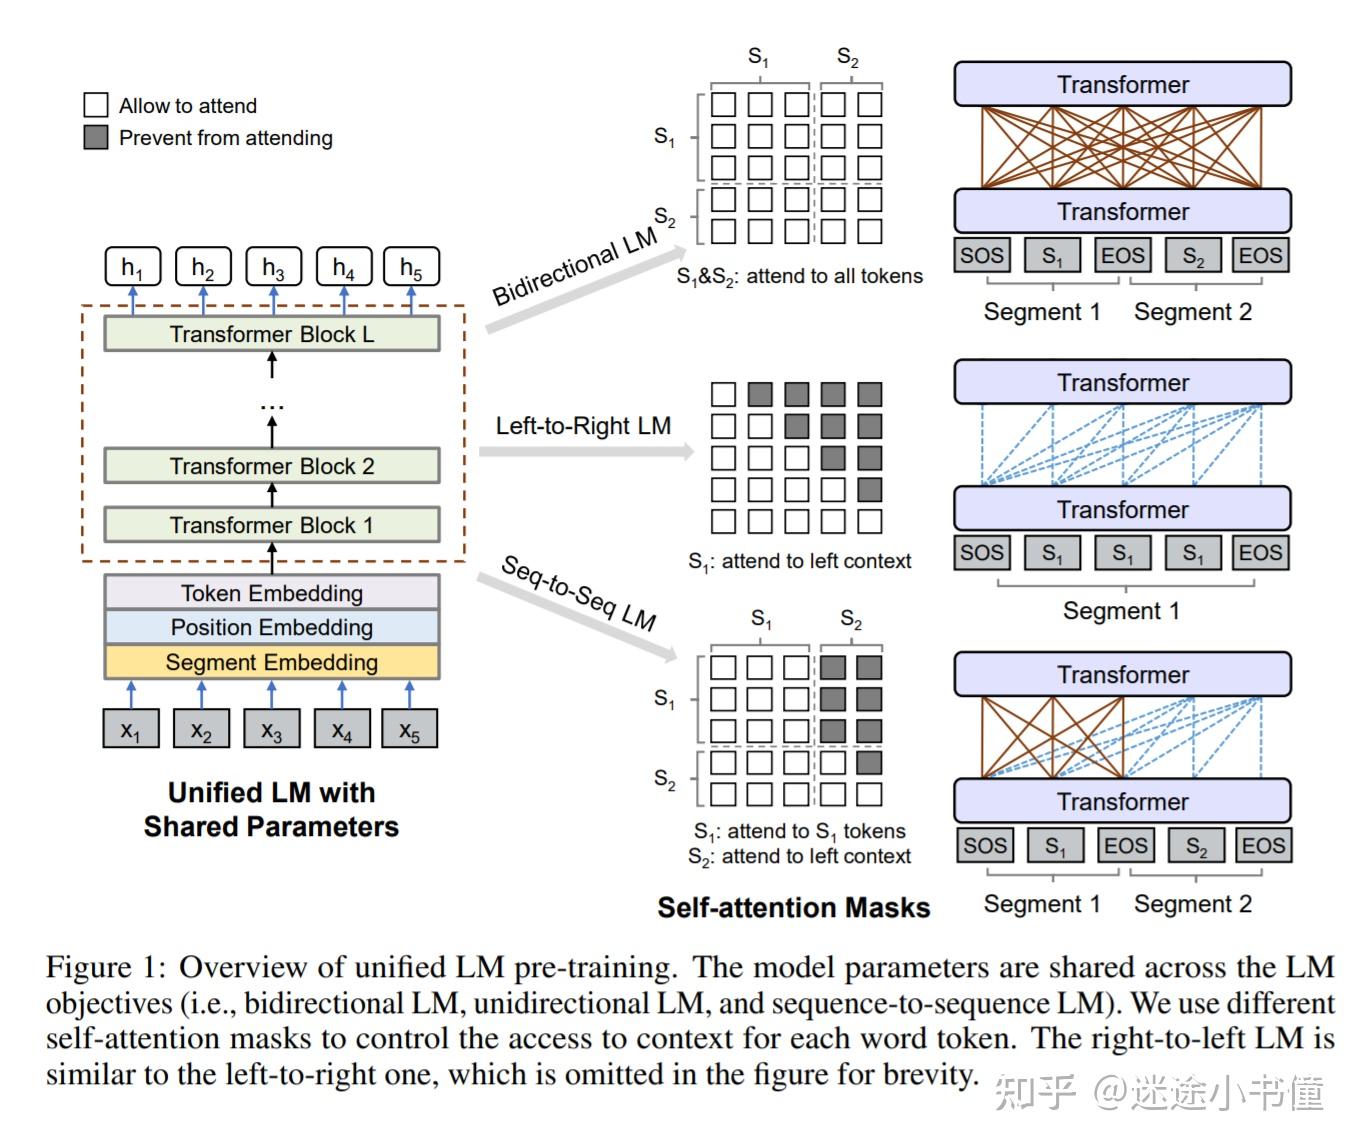
单向MLM: 例如,为了预测序列" "中的[mask],我们只可以使用
。
双向MLM: 和BERT是一样的了,即 都可以用来预测[mask];
序列到序列的MLM:设有两个segments(文本序列) ,目标是从
生成
。那么这里的限制条件是:在
中是双向可见的,而在
中是从左到右单向可见的。模型的输入是:
,那么:
可以看到
;
可以看到
;
只能看到
,其右边的tokens(
)就看不到了。
--
而在训练目标(任务)上,则包括如下三个部分:
其一,标准语言模型,即standard langauge model (SLM),通常是基于“自回归”(autoregressive)方式来训练P(x),即从左向右,一次预测一个token。
其二,与SLM相比较,另外一个方法则是“去噪”(denoising)目标函数,其首先应用某些噪音函数到输入x,即:
,然后基于加了“噪音”的
,来恢复原来的输入
,即:
。而这个方向上,也有两个细分:
第一个细分是:CTR: corrupted text reconstruction - 损坏文本重构,只是对输入句子的,加了噪音的部分,计算其loss;
第二个细分是:FTR:full text reconstruction-全体文本重构,是针对输入的句子的所有词,计算其loss,而不管这个词是否是被加了噪音的。
依据预训练任务的不同,预训练语言模型的擅长的下游任务,也有所侧重。例如,left-to-right这样的自回归语言模型(GPTx系列),对于prefix prompts-前缀提示-这样的应用会有一定的优势;
而“重建目标”(类似BERT),则对cloze prompts-填空式提示,具有一定的优势。
基于SLM(标准语言模型,自回归)和FTR(全文本重构)的目标函数,则对“文本生成”类任务具有一定的优势。
下面看论文中的Table 4,通过例子,来了解一下预训练语言模型的一些“加噪音”的方法:
加噪音方法一:masking,遮掩。例如BERT,被遮掩的可以是一个token,若干(随机选择的)tokens,或者实现通过NER识别出来的命名实体,例如上面例子的New York被替换成了一个[Z] (即[MASK]);
加噪音方法二:replacement,替换。这里的例子中,使用了[X]和[Y]这样的其他的随机选择的(例如从词表中sampling)token/tokens;例如,Jane will move to New York . -> Jane will move today New York . 预训练任务,可以是类似FTR,即从“Jane will move today New York .”恢复“Jane will move to New York .”。
加噪音方法三:delete,删除。只是随机或者非随机(例如指定只删除named entities)删除一些tokens,然后让模型预测。这里,常常配套使用的是FTR,即从"Jane to New York",来基于自回归的方法,复原出来“Jane will move to New York”;
加噪音方法四:permutation,排列,重排列,重新排列。文本首先被切割成若干spans,即若干片段,然后这些片段被重新排列构成新的文本。XLNet属于这个方向。
对于表示学习的方向性,一般可以参照BERT的双向,和GPTx的从左向右。代码实现的时候,一般是通过加attention masks的方式得到的: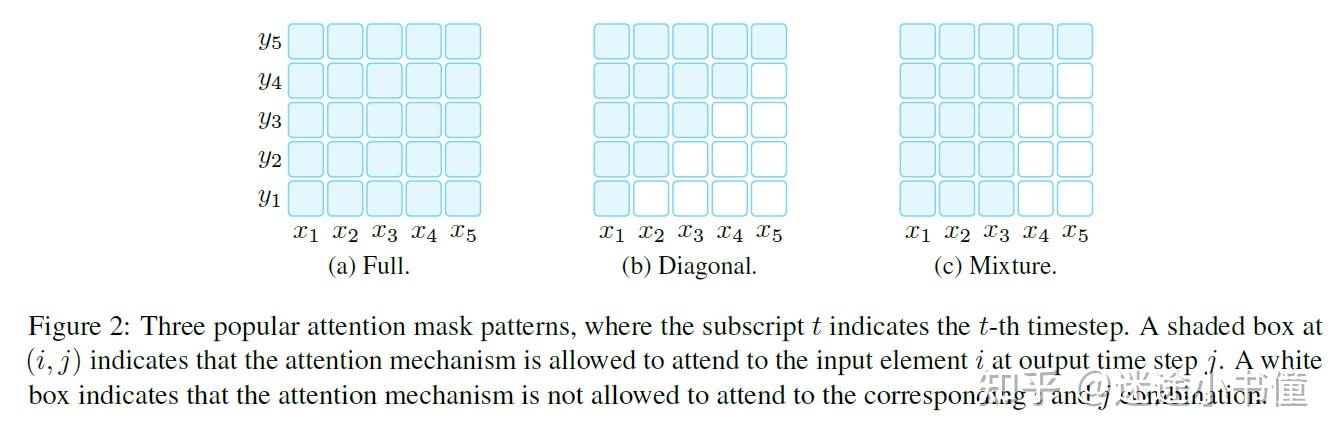
上图中,最左边的图是"Full",即在输出的y1的时候,x1到x5都是可见的;以此类推,在输出y5的时候,x1到x5都是可见的。(例如bert).
中间的图,是对角线形式的masks,在输出y1的时候,只有x1可见;输出y2的时候,只有x1, x2可见,依此类推。(例如gptx).
最右边的图,是mixture,混合的masking,在预测y1到y3的时候,x1, x2, x3都可见,然后预测y4的时候,x1-x4都可见;预测y5的时候,x1-x5都可见。
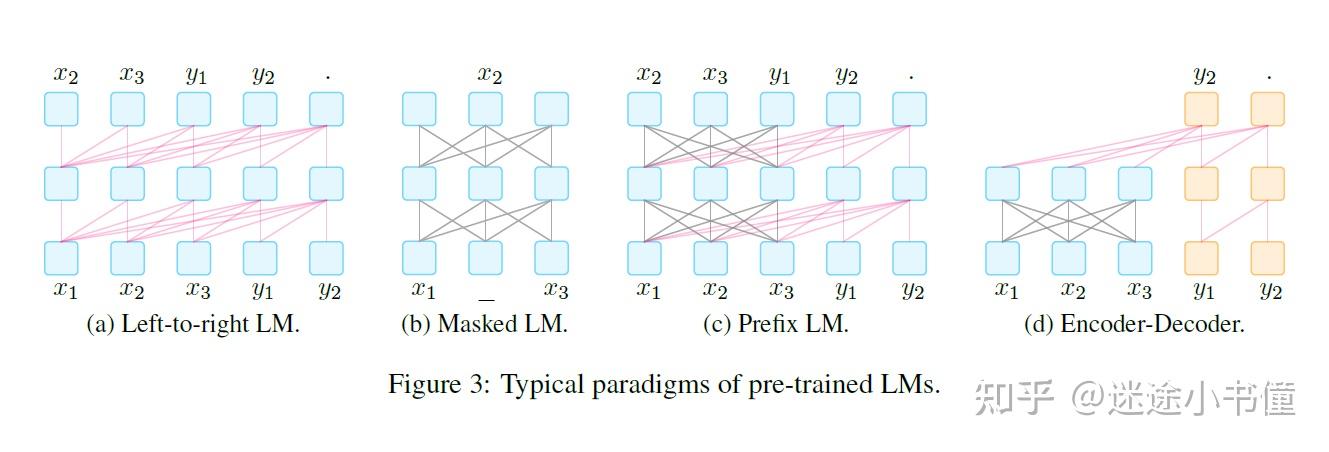
上图示例了预训练模型的若干套路,(a)对应gptx;(b)对应bert;(c)对应的是例如双语的gpt,注意输出都是自回归形式的,从x1预测x2,然后x1,x2预测x3等等;而(d)类似于seq2seq MLM(?感觉不太像啊,y1没有被预测?是不是在x3和y1之间少了一个?从而让预测得到y1?或者y1=?),其中y1 y2是被mask的部分,通过已有的剩余的上下文x1, x2, x3来先预测出来y2,然后再根据x1, x2, x3和y2来预测出来 . 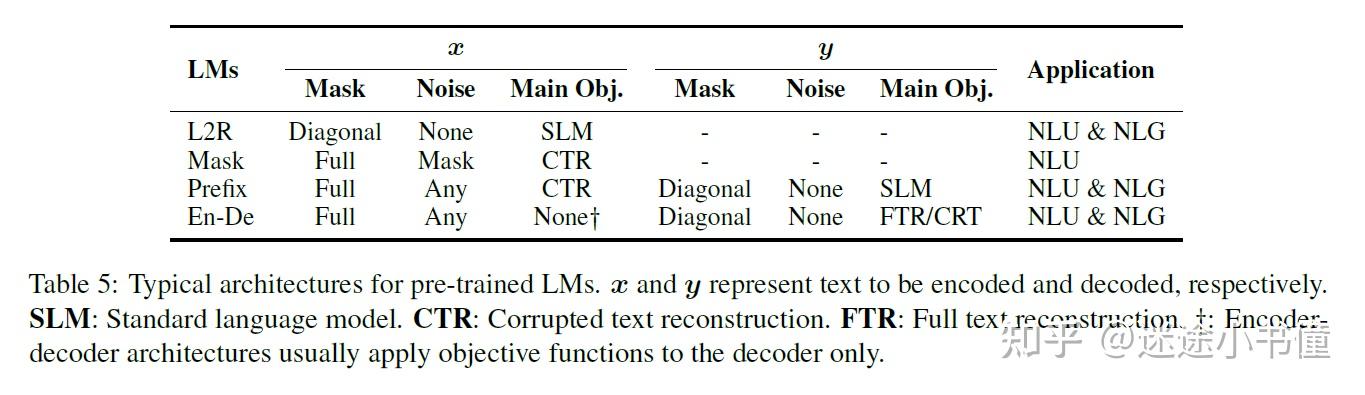
和Figure 3对照的是,Table 5,这里的x代表被编码的文本序列;y代表被解码的文本序列。
第一:对于L2R,left-to-right的Figure 3(a)来说,是GPTx类型的,使用的attention mask矩阵是对角形式的,即Figure 2(b);没有Noise,即没有(必要)加噪声;而主要的目标函数,是标准LM-SLM,自回归Loss。当然gptx可以被应用于NLU(分类)和NLG(生成)问题;
第二:对于mask lm-MLM而言,对应Figure 3(b),是bert类型的,使用的attention mask矩阵是Full,即Figure 2(a);使用的noise主要是mask,遮掩一些tokens,然后主要的目标函数是CTR,即“损坏文本重构”。应用的方向,主要是NLU方向;
第三:对于prefix LM,对应Figure 3(c):在x文本序列的部分,使用的attention mask是full,即在产出y的时候,所有x可见;可以加入任意noise,然后主要的目标函数是CTR(?)--这里值得商榷,如果加了"delete"这种噪音的话,其实前面也提到了,可能FTR会更好?即从x1, x2, x3来产出x2, x3和y1的过程。对于y序列而言,使用的attention mask是对角的,即自回归形式的,没有加噪音,主要的目标函数是标准LM,即自回归函数。
第四:编码-解码,鉴于输入的x序列不需要被预测(所以x序列的目标函数是None),所以对于x序列而言,使用的attention mask是full,全可见;可以加入任意noise,(例如为了增强对抗学习,样本的稳定性扰动)。而对于y而言,attention mask是对角线可见的,一般不加noise,主要的目标函数一般是FTR或者CTR(感觉针对y序列整体的FTR更好一些。。。)。
到了核心区了。
目标: - 构造这个提示函数,从而在下游任务上达到最优效果;
人工,或者,自动,构造/选择每个下游任务的最优的模板。
第一步:确定prompt shape,即提示的形状(如prefix prompts/前缀式提示,cloze prompts/填空式提示;当然,根据任务的不同,可以有若干X和若干Z;细节可以参考Table 3);
第二步:采用人工或者自动的方法来构建符合目标prompt shape的prompt。
人工构造prompts的例子,就太多了,上面也罗列了太多例子,而且prompts对最终结果有显著的影响:
当然,prompts可以再细分为若干种类,例如discrete prompts(离散提示),是使用具体的words/tokens。另外,与此对应的还有continuous prompts(连续提示),是基于embeddings来表示prompts。
先看离散提示,discrete prompts的几篇著名文章:https://watermark.silverchair.com/tacl_a_00324.pdf?token=AQECAHi208BE49Ooan9kkhW_Ercy7Dm3ZL_9Cf3qfKAc485ysgAAAs0wggLJBgkqhkiG9w0BBwagggK6MIICtgIBADCCAq8GCSqGSIb3DQEHATAeBglghkgBZQMEAS4wEQQMsktzRbjqZiWPssbZAgEQgIICgKdBhTsCohdbABRe3xiqqpIN0Wmg6FT9N0rIwdtpzcLWOZ9xoQkyfkGeuQFcnkOmwTHb-1J8U8KTNsW1sTzcf9F8oUlztSleXhSEYVh5Xc-I3iIp88Crlnc6MIKyKpJfT_arZg3l62BkdnIprPjtcS-oGMB4OLFAsGVea5C1Uu3oe7Bz6edV85Y6S6nyPCikY8cOMesrbBqstavyPOr_JlMdO3oJnK5gQRcBPxtXQhRoV1mHmXIyikjZeEZ8jl8x_gI35Vl4zw1cfG-MJREJ-W-ruyHhOnkTgPGA4pNI0OGR0_-3oKJFydEOMURx-vL_OhgkSYmFZefU9kdSf2CgQdIKlmjxgzRdT4cqEkbEFYtIDPJWt30V1O6lh1y2ENgfYemsYSccO2ady6cp2LDdDEmJvkJvbdWqZR-DCYrtYrWp24cgBHwEWJy56jYG7zuJBmMHCol6KnFQ3IbcTxnDFfQ3ByWarHcnKO4yPqkLSf8d38-Q-iSeypfYYW28SGT0x2kU8Dt9dO5aKJ01uRqK_xprUzMR-Vf2kexVe2yRBrG0zqgz2zAM5xfFvqGZZZ32cl9OmJaifqSWgVfM2zTDA8w3r--gmhXSKWE284MNB5M0GmyaCNl4VGAfNnMN6TWNoT6wXlRr3ZQNlHFe2C1CRyGh10MesuHR6LUSIDUYYRhPdV8Znhy0ojeBdvZqAF-TCUarsURZvYMcg9tyHB38s-T8C0fhJi9Jwxd5LwRGMZ-z6LdGk92ZHDXr_MzDvonjlLDBUL8VtCY_nD3JS3uMLA_uSNO2F-Jltoqm8gjxhyszizGvqDxdE35h64iWs6SFWpfv1tL48RL3FPszu-4ZeT4
这篇文章2020年发的TACL,讲的是如何拿预训练语言模型当作”知识库“使用,然后使用了依存树和paraphrase来挖掘prompts。看几个例子: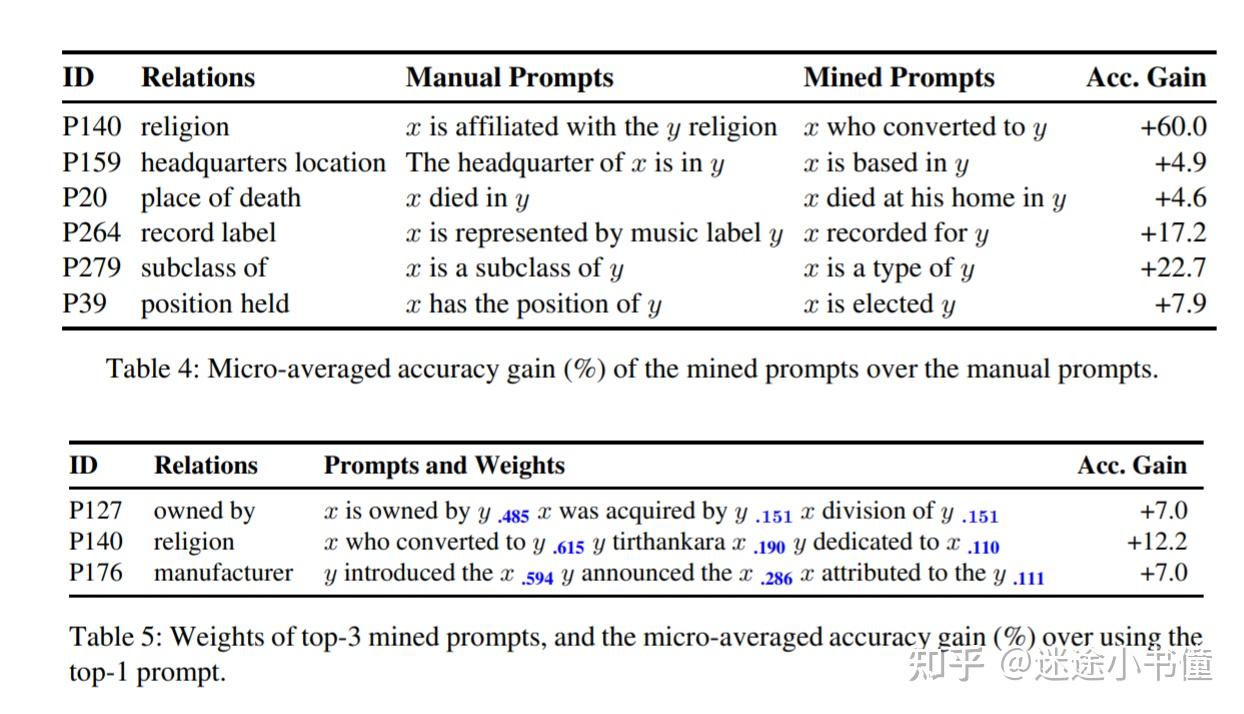
这里用的是LAMA(别问我lama是啥。。。哈哈)数据集合:https://github.com/facebookresearch/LAMA
可以看到,被挖掘出来的若干”连接词“(or, predicates,连接谓词),增加进来后,精度提升还是非常明显的。
简单解释一下论文中提案的两个方法,一个是dependency-based prompts,举例子说明这个方法:
有些templates词,并不出现在subject (paris)和object(france)的中间,例如:
The capital of France is Paris
France <-(pobj) of <- (prep) capital <- (nsubj) is -> (attr) Paris
其是通过dependency tree来寻找subject和object之间的最短路径。
这样的话,上面的连接France和paris的路径,就是capital of x is y,就是新挖掘到的一个prompt。
另外一个方法是paraphrasing-based generation,例如:
x shares a border with y
其可以把中间的连接词,替换为一些paraphrases,例如:
x has a common border with y
以及:
x adjoins y
这个方法,和query扩展技术比较类似。(通过变化query的用词,增加recall)
可以有若干方法构造得到paraphrasing的prompts,例如english -> chinese -> english,这样的话,可以得到Paraphrases。
好,我们通过google 翻译看个例子: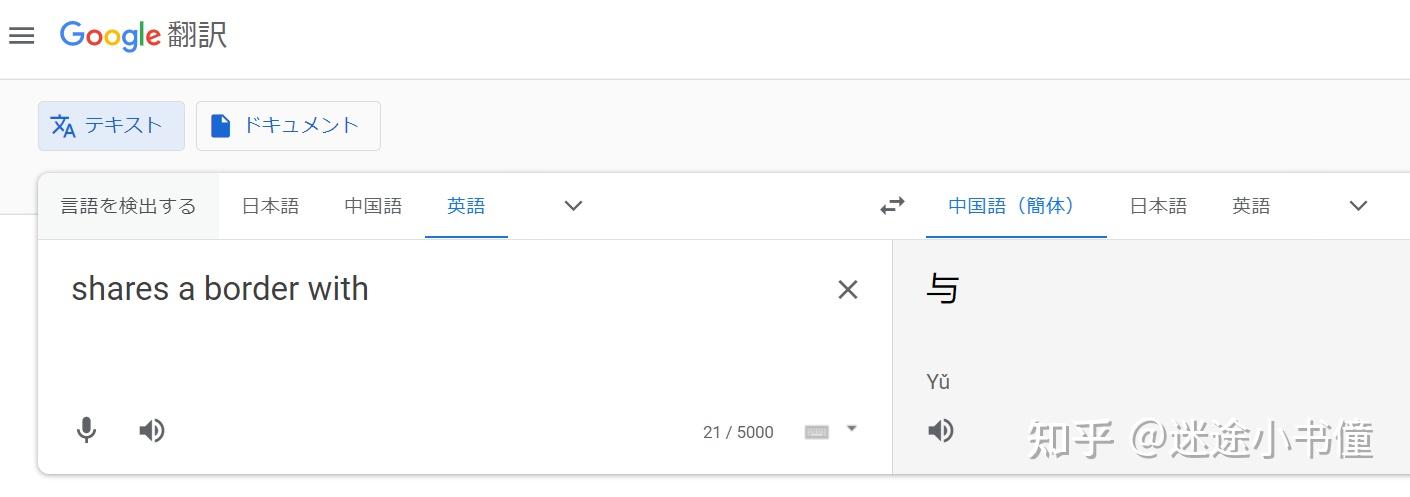
单独翻译成”与“,这个有点尴尬了。。。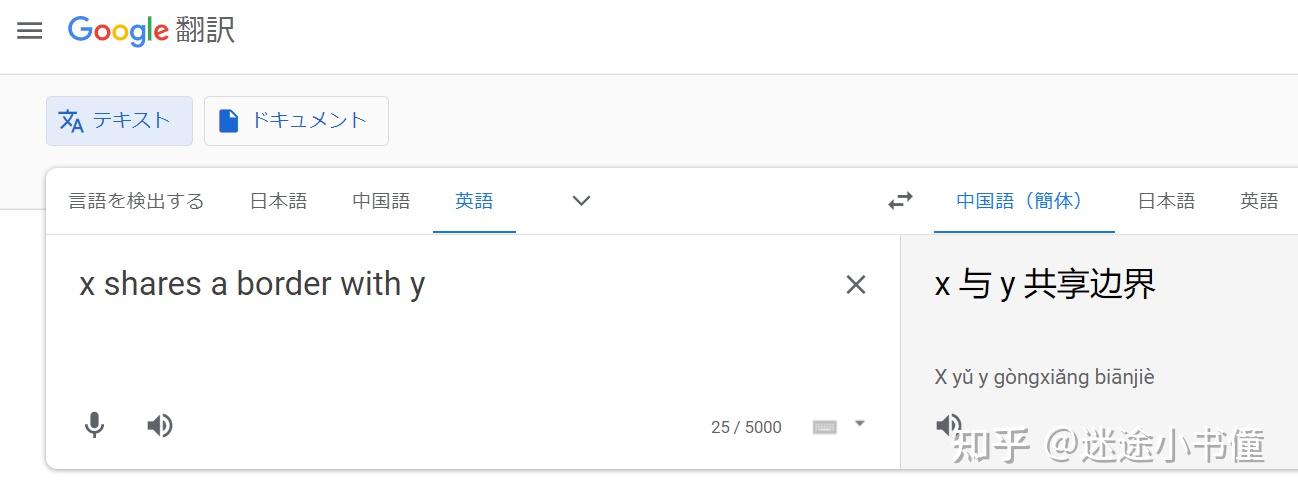
然后翻译回来: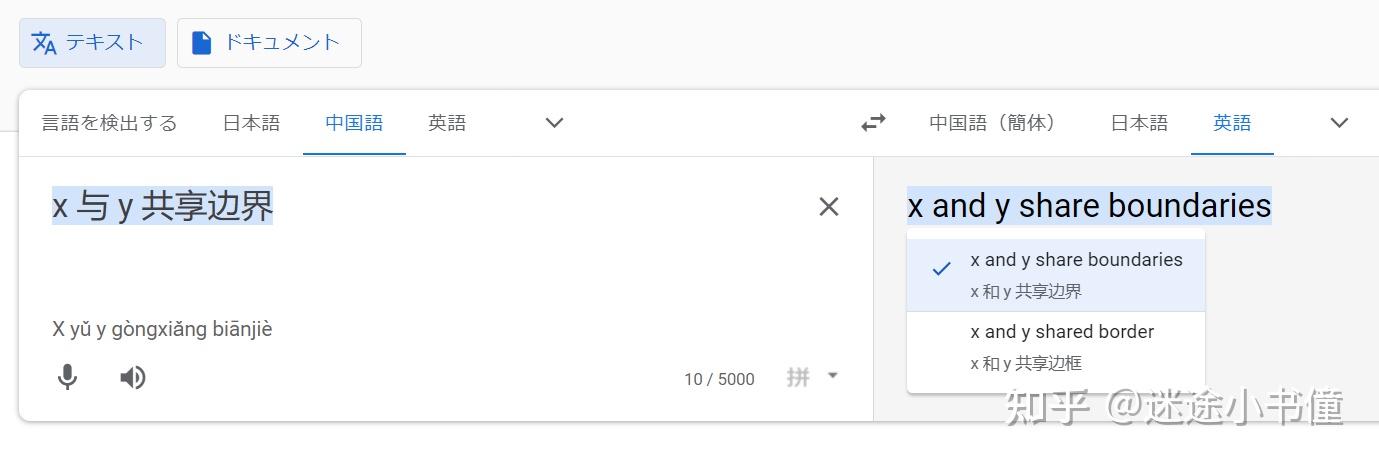
可以得到,x and y share boundaries, x and y shared border;这两个paraphrases。它们都可以用来做prompts。
有几个相关的paper,例如:https://arxiv.org/pdf/2106.11520.pdf
它的里面有个表,prompt set: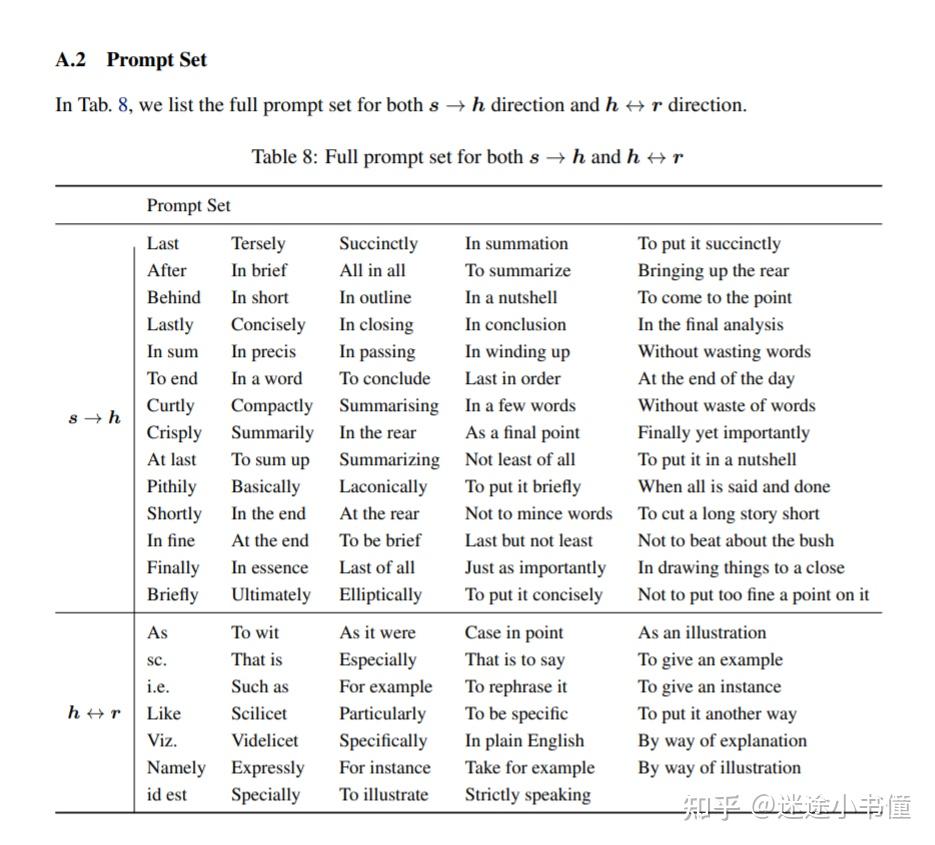
这里的s代表给定的source text,h代表待生成的hypothesis,而r代表references(人工构造的references)。这是以有条件文本生成为例子(如,摘要生成;机器翻译)。
而与此相关的另外一篇文章,是EACL2021(short paper)上面的: https://aclanthology.org/2021.eacl-main.316.pdf
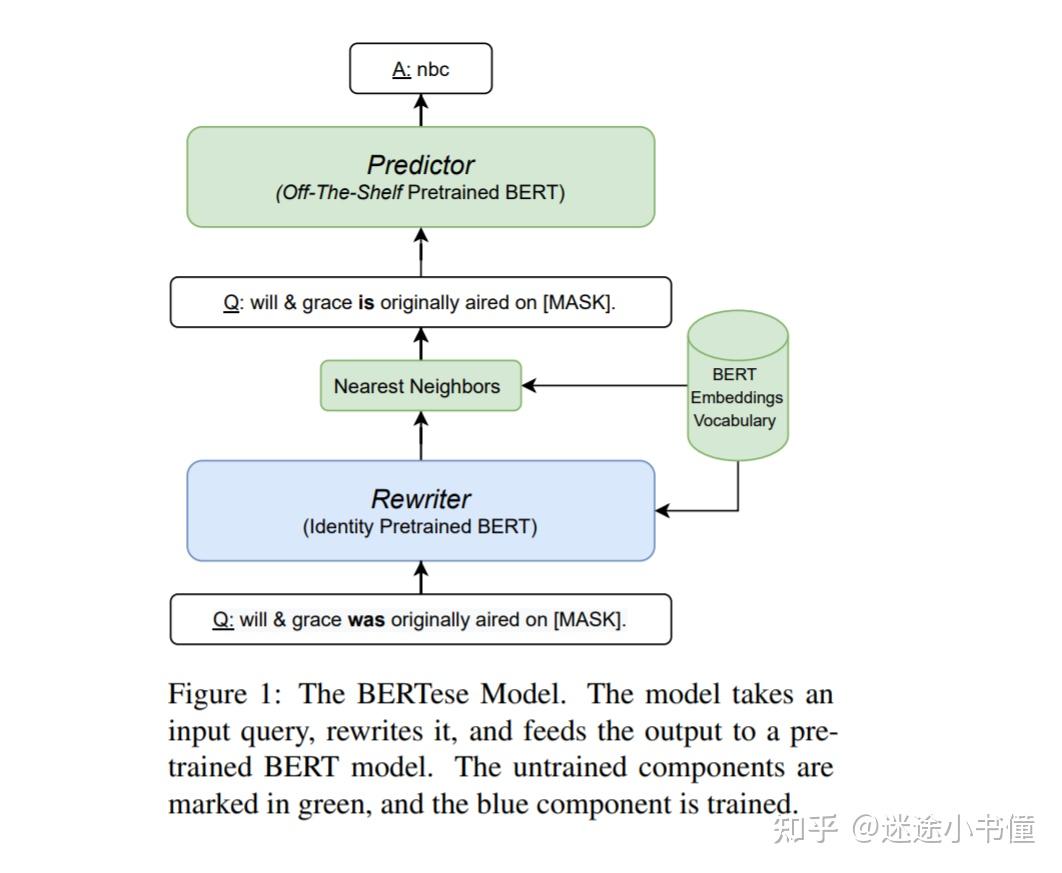
通过可训练的”rewriter“,上图的方法,把输入的query进行改写(使用的是bert的embedding vocab),把was 改写为了is(可以理解为一种paraphrase),然后让predictor(即已经训练好的bert模型)来填坑[mask]。
https://arxiv.org/pdf/2010.15980.pdf
这个自动搜索多个subject和object之间的”连接词“的方法,Autoprompt(EMNLP2020的文章),在我之前的关于P-tuning的读书笔记里面有所介绍:迷途小书僮:[细读经典]P-tuning:用“连续提示微调”来增强“超大规模语言模型”的下游能力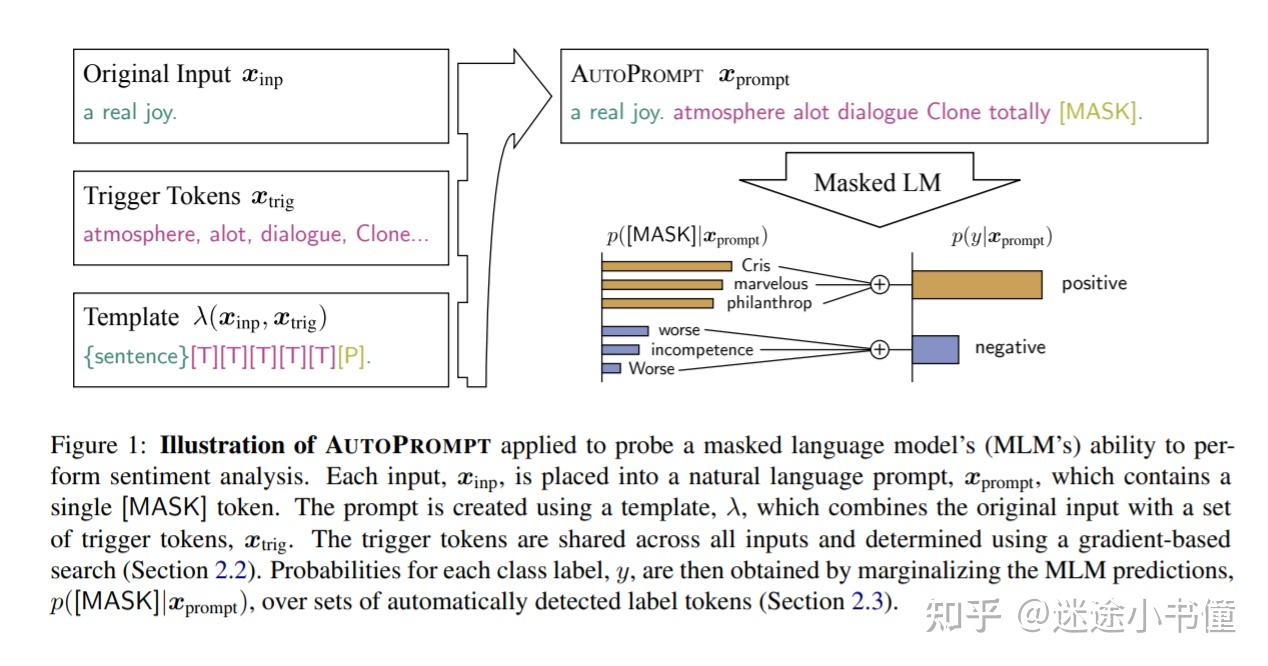
上面的图概述了其核心思想和示例。任务是情感分析,例如给定输入句子:”a real joy.“,该模型的最终产出是positive或者negative的情感判定。
x-inp 是input x,而后,x-inp会”带起“若干trigger tokens(激发词),例如atmosphere, alot, dialogue, clone等;再往后,输入的句子,和激发词结合起来,根据template-模板的配置,来构造出最终的bert的输入:
a real joy. atmosphere alot dialogue Clone totally [MASK].
然后,bert等masked language model会根据这个输入的sequence来预测被遮掩掉的词。
这个方向,介绍两个工作,其一是Gao+(ACL 2021)的工作,是把seq2seq预训练模型T5应用到模板搜索过程。因为T5本身的预训练任务就是预测一个span(一个子串),他们使用T5来生成模板词,其一:指定按照位置生成词,其二:提供训练样本给T5,来解码模板词。https://aclanthology.org/2021.acl-long.295.pdf
这篇文章比较新,主要思想如下图所示:
这里面的(a)和(b)没啥好说的,分别是MLM和fine-tuning。而(c)则是该论文的核心思想的示例。
可以看到有四个部分,[input]表示输入的句子(做情感分析用的):[CLS] No reason to watch.
然后是第二个部分:It was [MASK]. 是模板;
第三部分是一个正例样本: A fun ride. It was great . [sep];
第四部分是一个负例样本:The drama discloses nothing. It was terrible . [sep]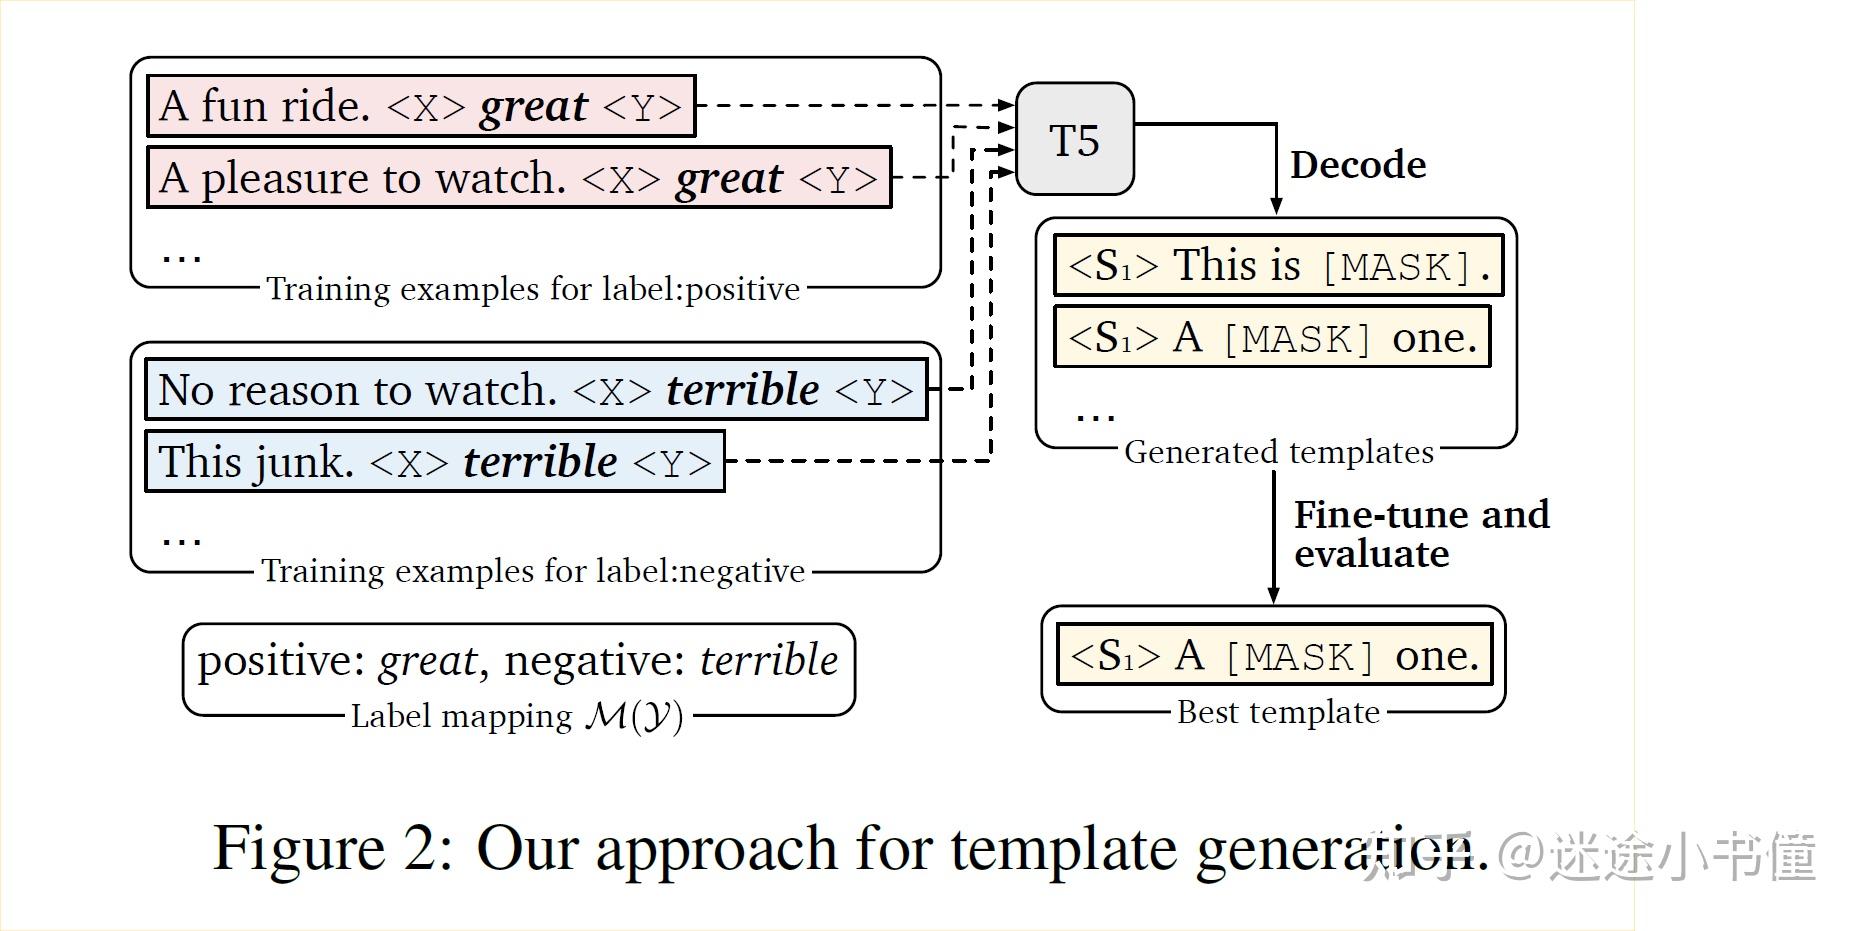
这里的思想是准备若干训练样本,然后让T5直接生成一个个的”模板“,最后选择一个在样本集合上最大”概率“的那个样本template即可。因为这个template/prompt是自动生成的,所以,这是”提示生成“。
如此看来,需要准备一部分”训练数据“,这个地方不怎么漂亮。。。
另外一篇文章也是2021的,大概思路和上面的基于T5来生成“模板”类似。https://arxiv.org/pdf/2102.12206.pdf
看其核心的图示: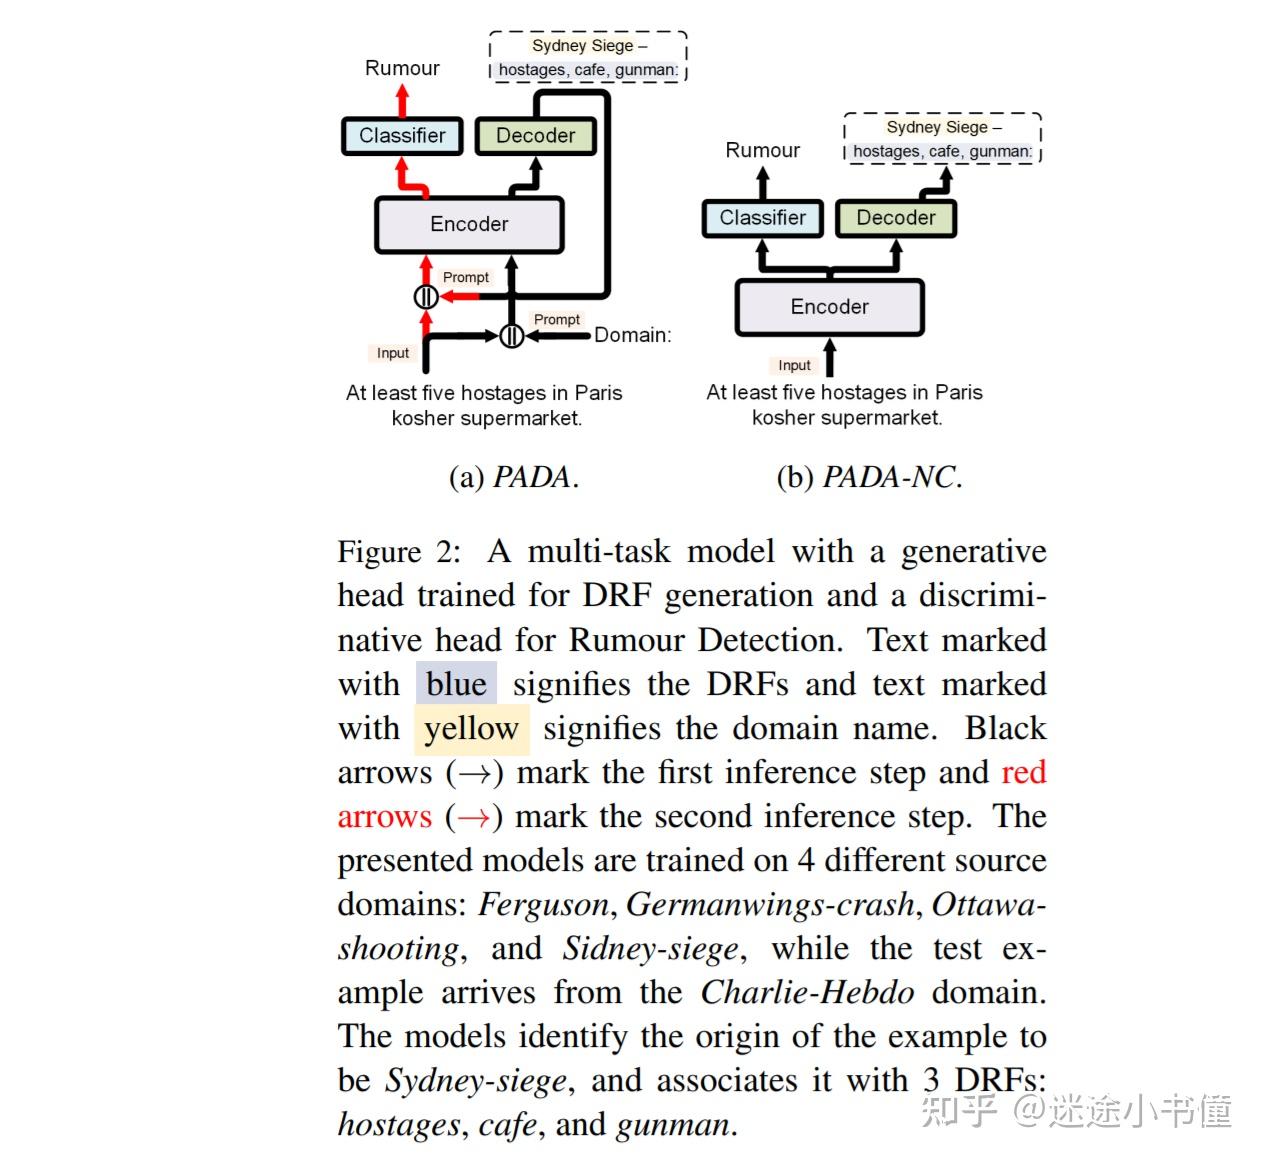
这里的DRF=domain related features,
PADA = Prompt-based Autogressive Domain Adaption algorithm (based on T5 model)- 基于提示的自回归领域适应算法
巴黎犹太超市至少有五名人质。=at least five hostages in paris kosher supermarket.
不知道为啥作者用这个怪怪的例子,还加上“rumour detection”(谣言探查。。。?)这样的例子,很容易被扣上“政治不正确”的帽子。。。
左边 的图(a),黑色是第一次inference,即先有input + 一个domain的prompt,然后经过encoder和decoder(都是T5的),然后得到若干新的prompts;
红色是第二次inference,即input和第一次inference得到的prompts一起,扔给一个encoder,然后再经过classifier,去确定input是否是一个rumour。
而与此相对的是一个baseline,即pada-nc,其没有经过两次inference。
下面的表格是涉及哪些domains: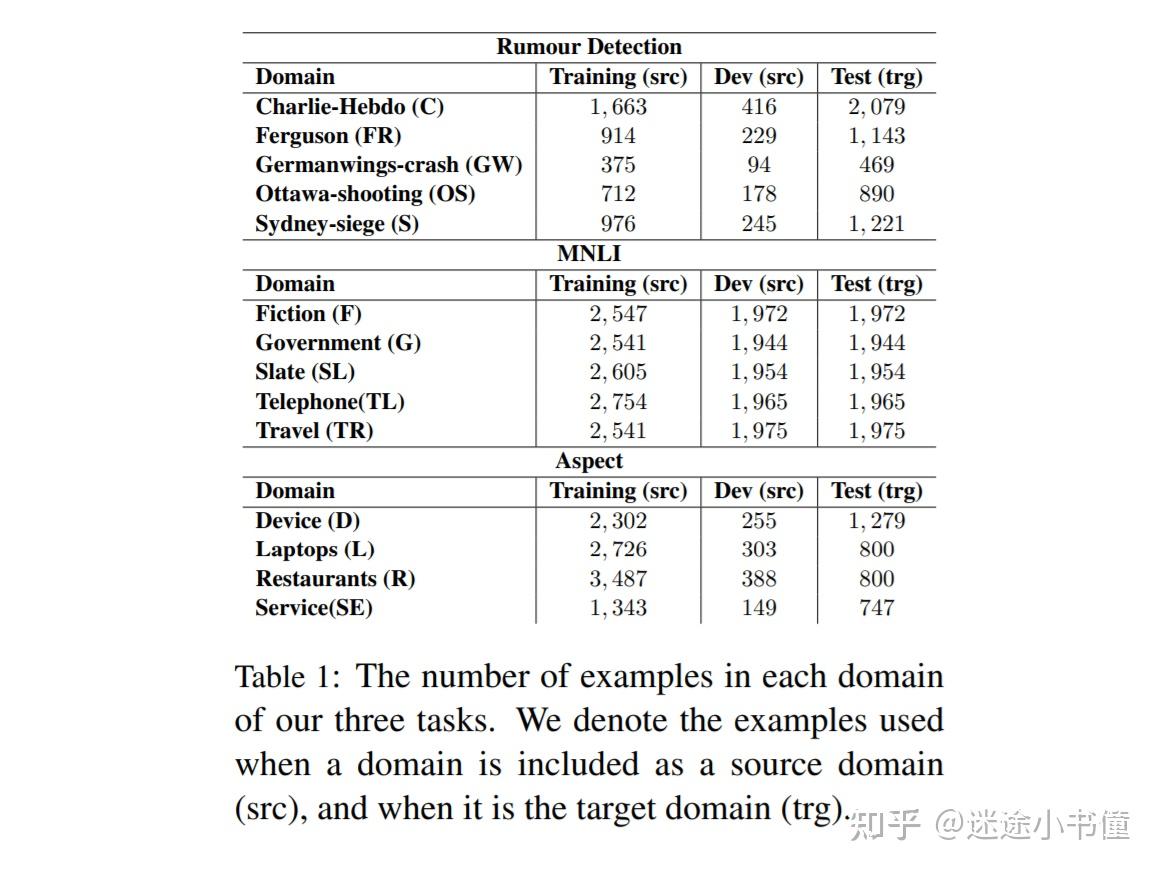
然后下图是关于rumour detection task的结果的: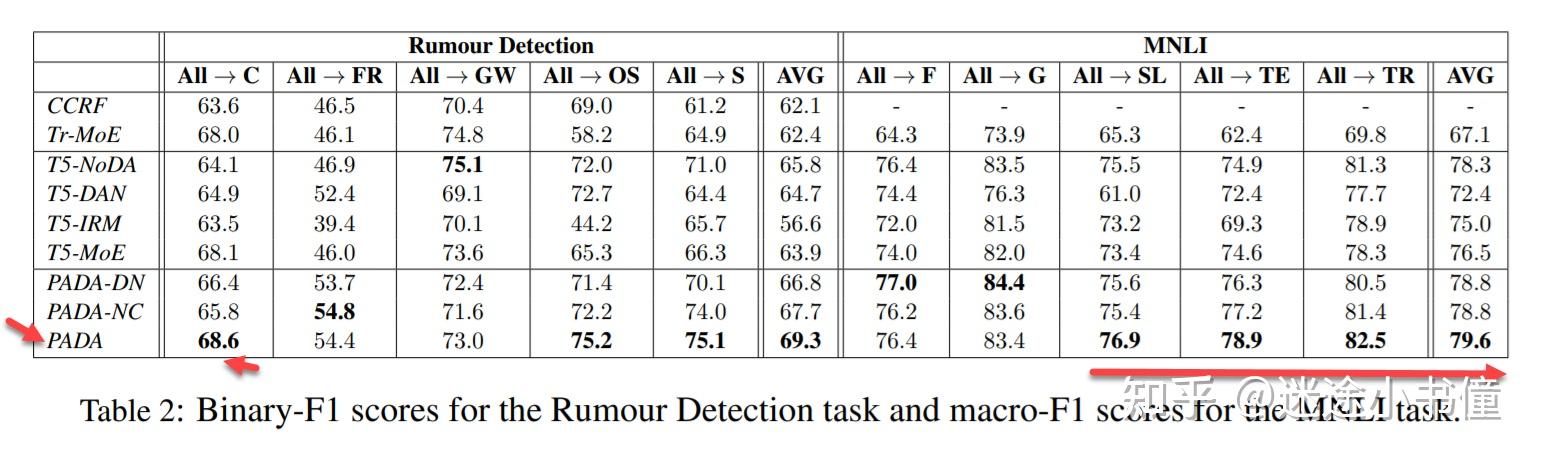
待续!