规格参数与使用规范
视频链接:【AI 集群】英伟达 Blackwell 产品演进分析_哔哩哔哩_bilibili
作者:ZOMI酱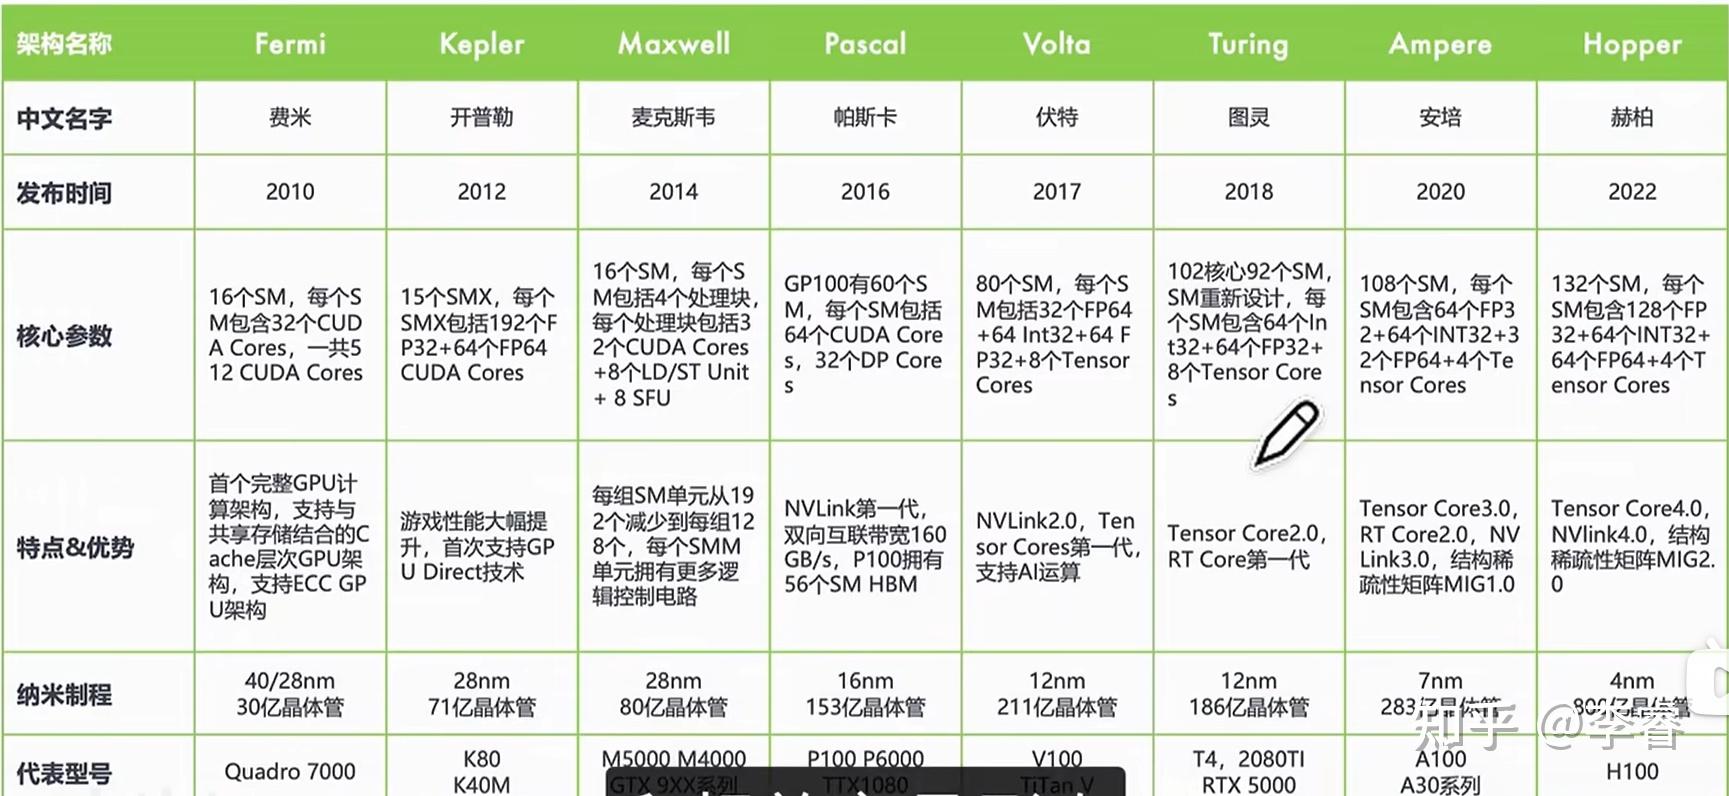 NVIDIA GPU架构发展 NVIDIA GPU架构发展B200、B100、GB200、NVL72、NVL32、SuperPod、GH200、H200、H100、L20、SuperPod-576ConnectX-800G网卡、网络交换机
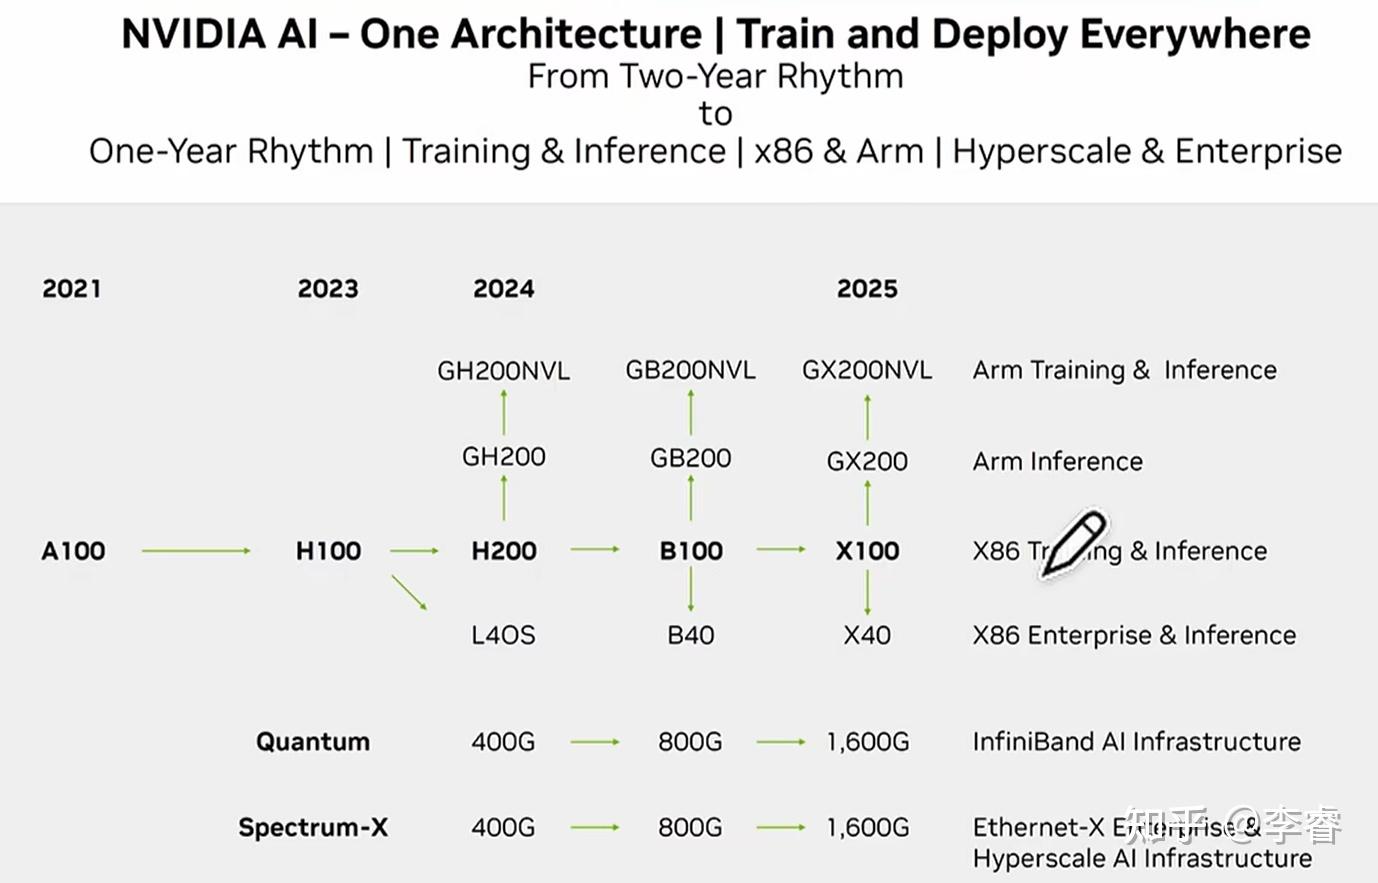
 单GPU介绍A100 -> H100 FP16算力增加3倍多,功耗只从400W增加到700WH200 -> B200 FP16算力增加2倍多,功耗只从700W增加到1000WB200 FP16算力是A100的7倍,而功耗是其2.5倍Blackwell GPU支持FP4精度,其算力为FP8的两倍
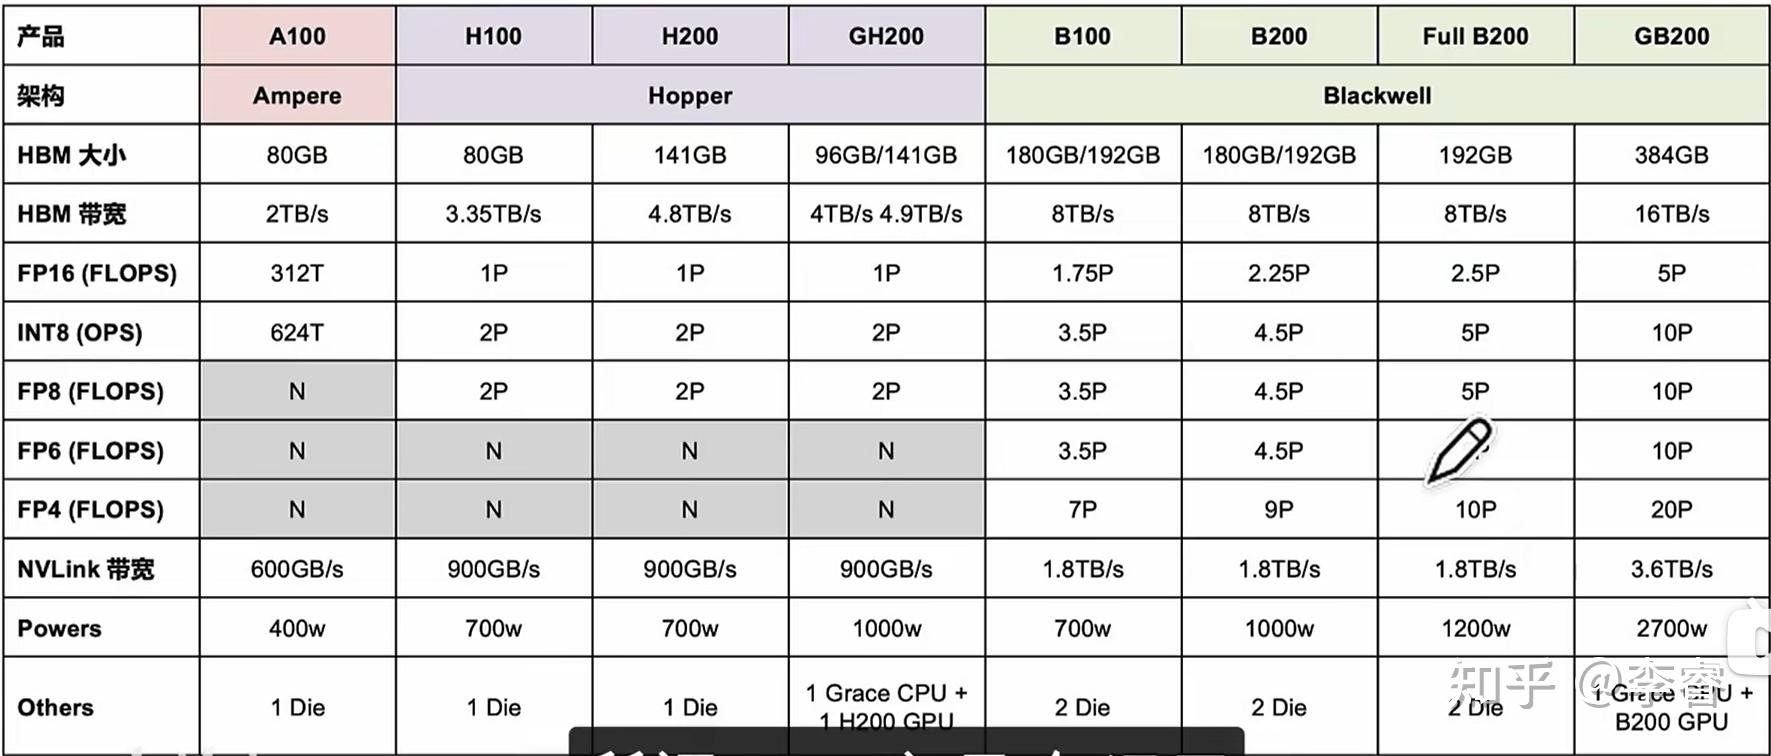
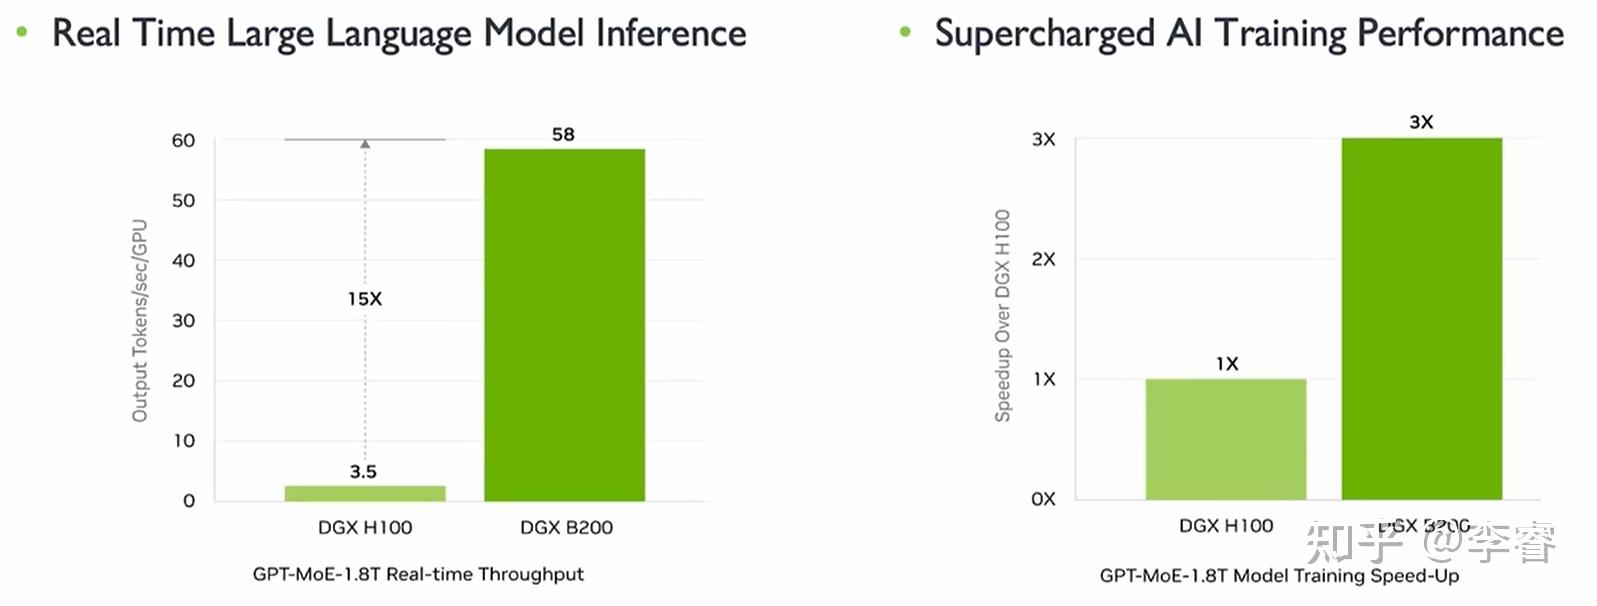
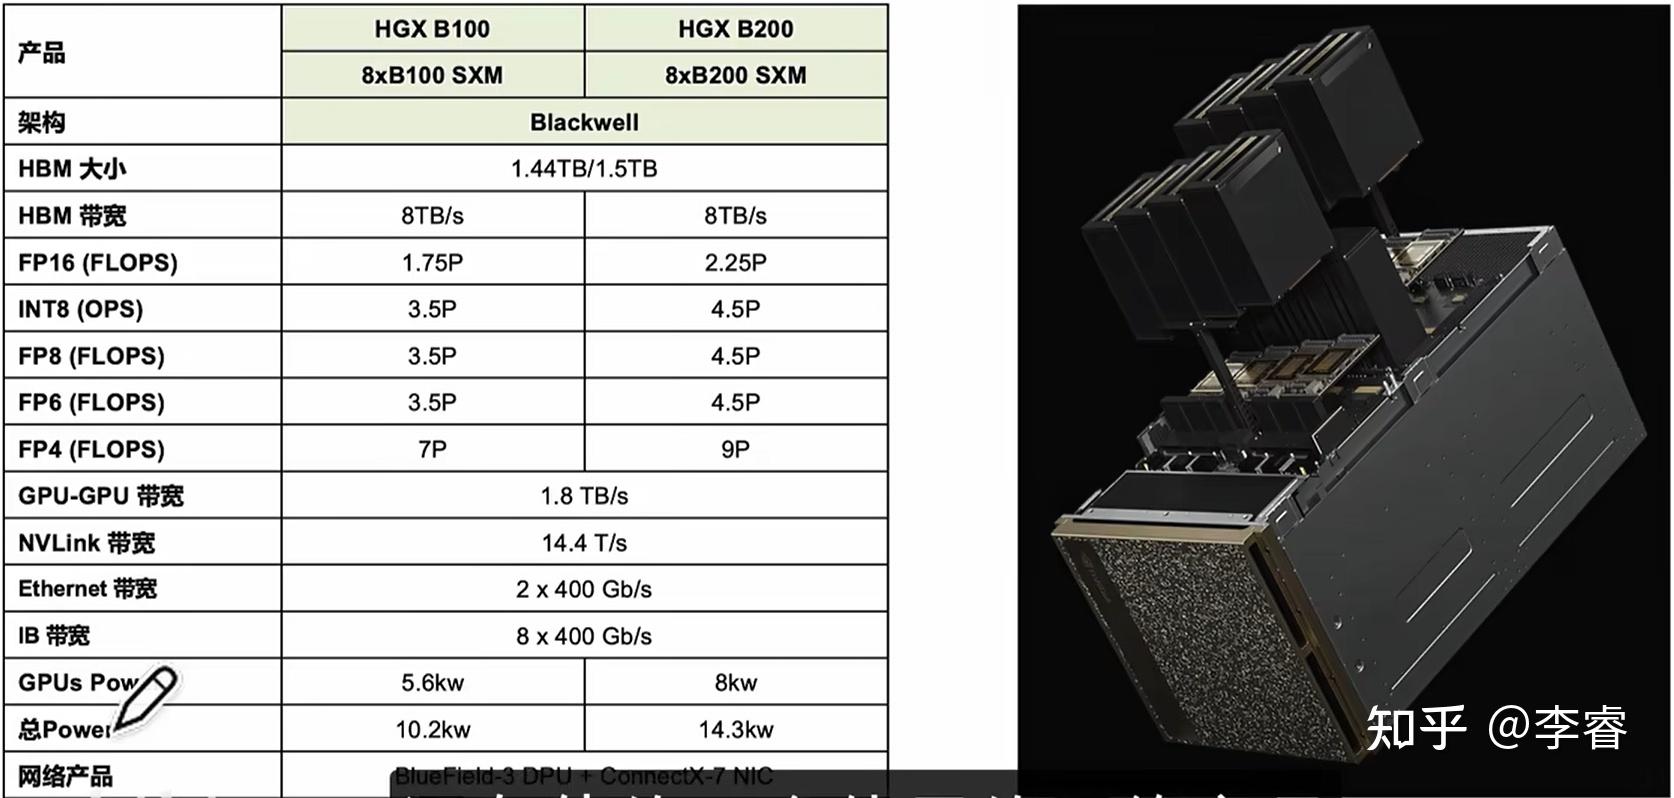
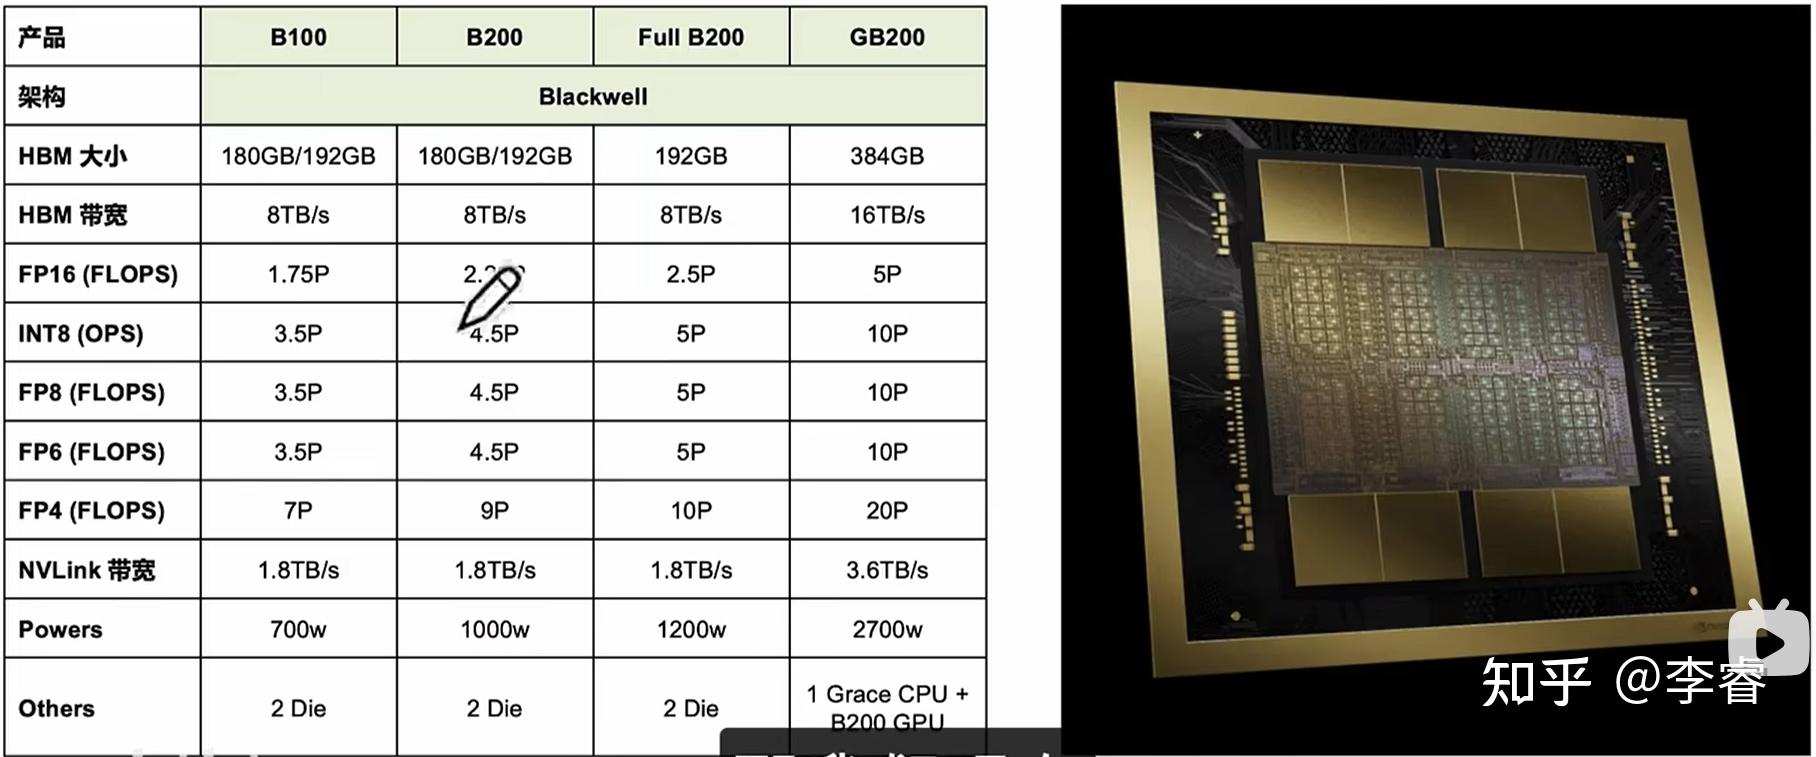 DGX B200适用于推理HGX H100 -> HGX B200 FP16/FP8算力提升2.25倍,HBM更大,显存带宽也达到2.3倍左右NVLink带宽加倍,假设MFU为50%,那整体训练速度提升3倍符合预期用FP4算力和Hopper架构的FP8算力比较
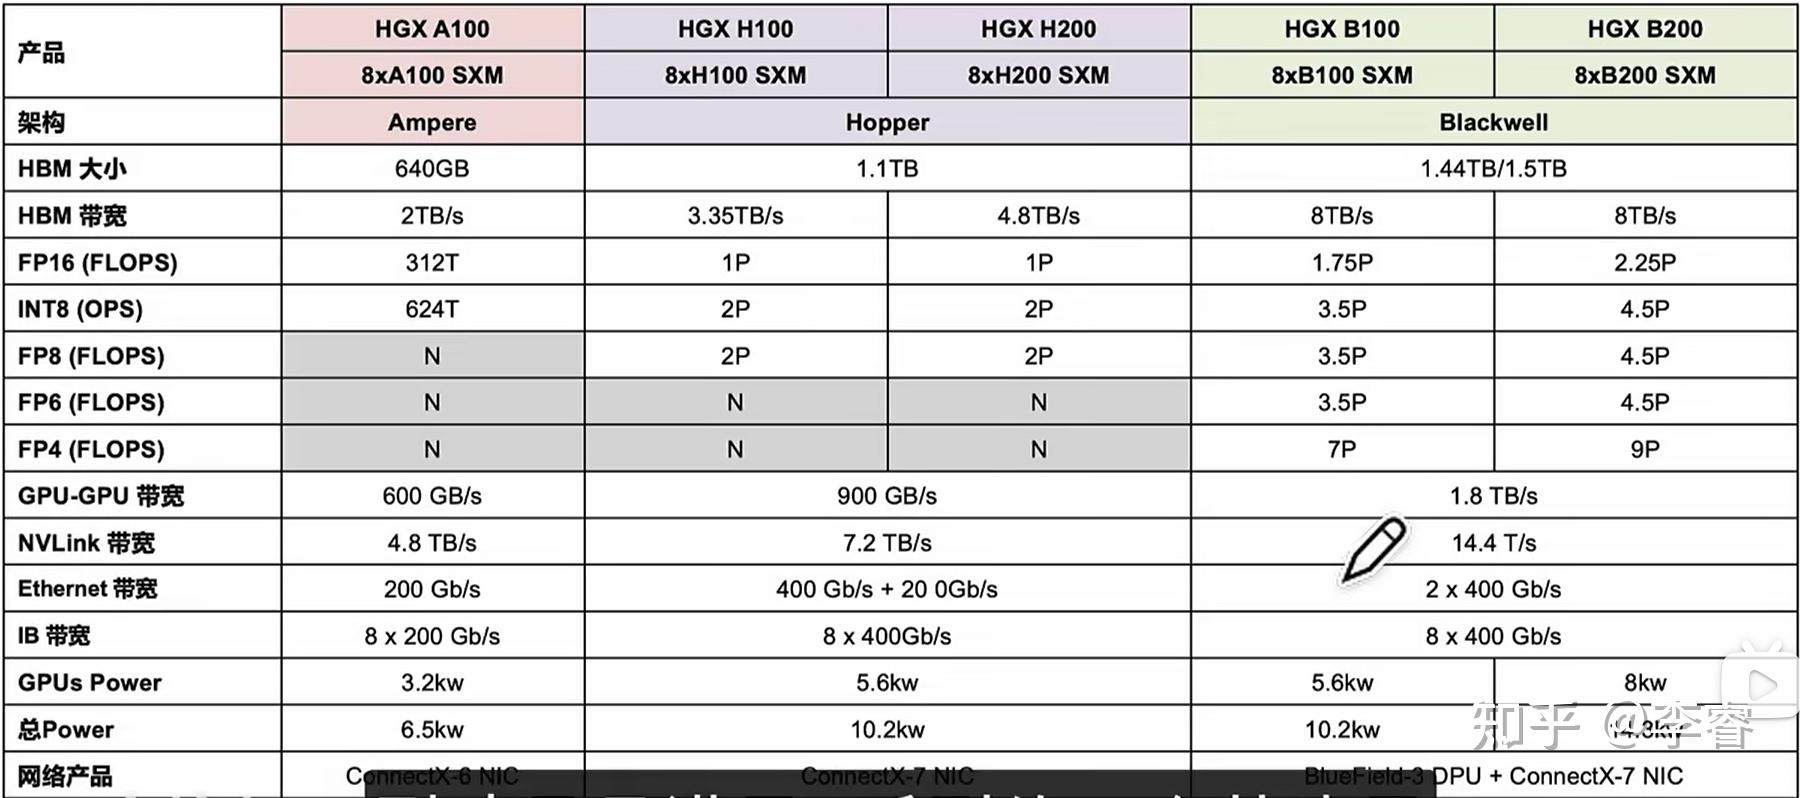
 HGX产品HGX A100 -> HGX H100 or HGX H200,FP16算力增加到3.3倍,功耗不到原来2倍HGX H100 & HGX H200 -> HGX B100 & HGX B200,FP16算力增加到2倍左右,功耗相当
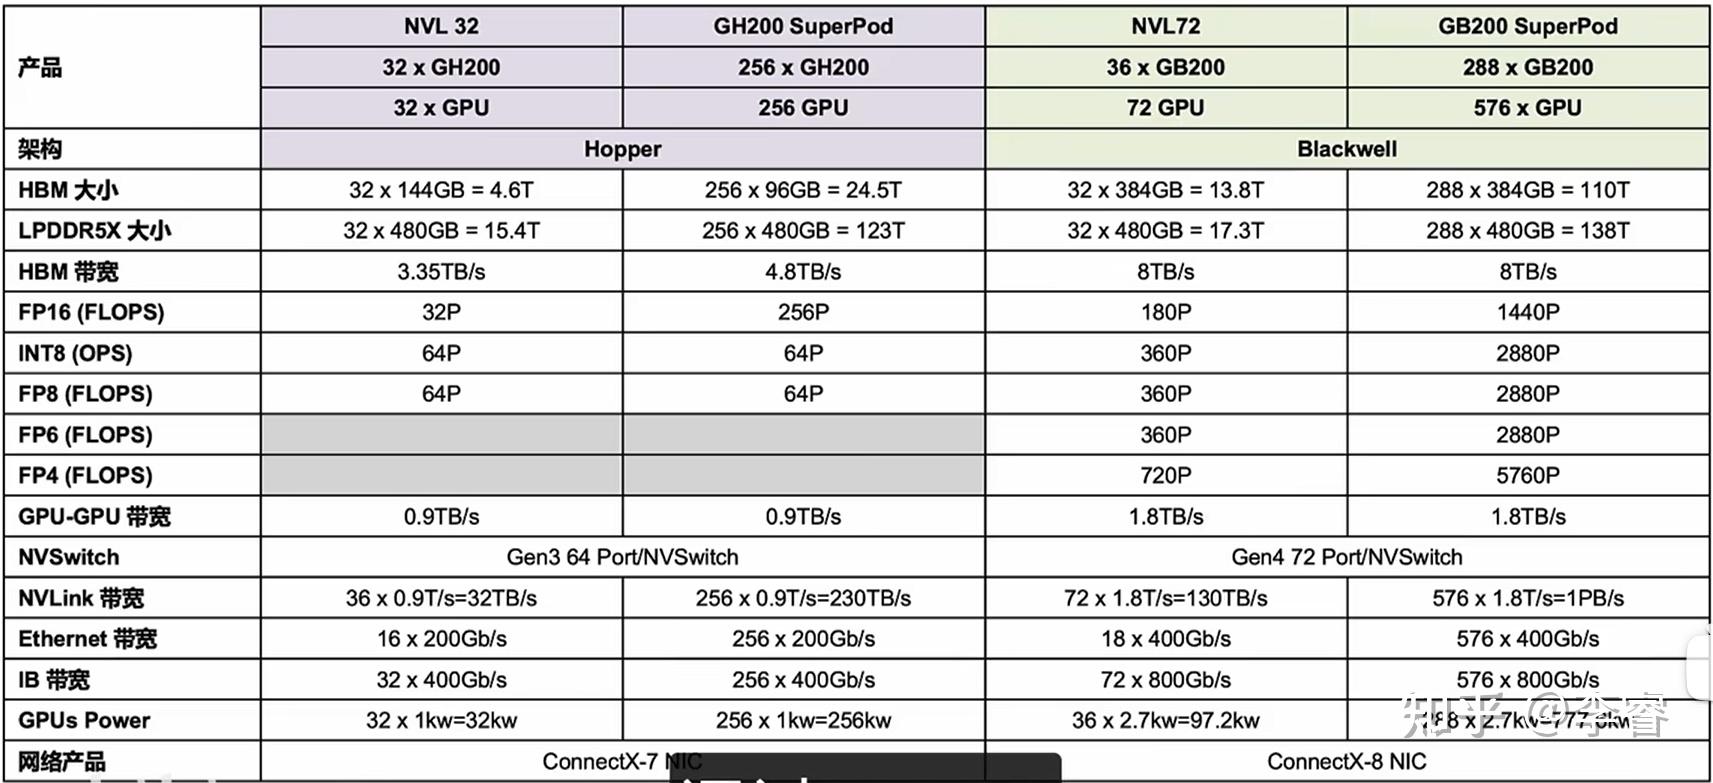
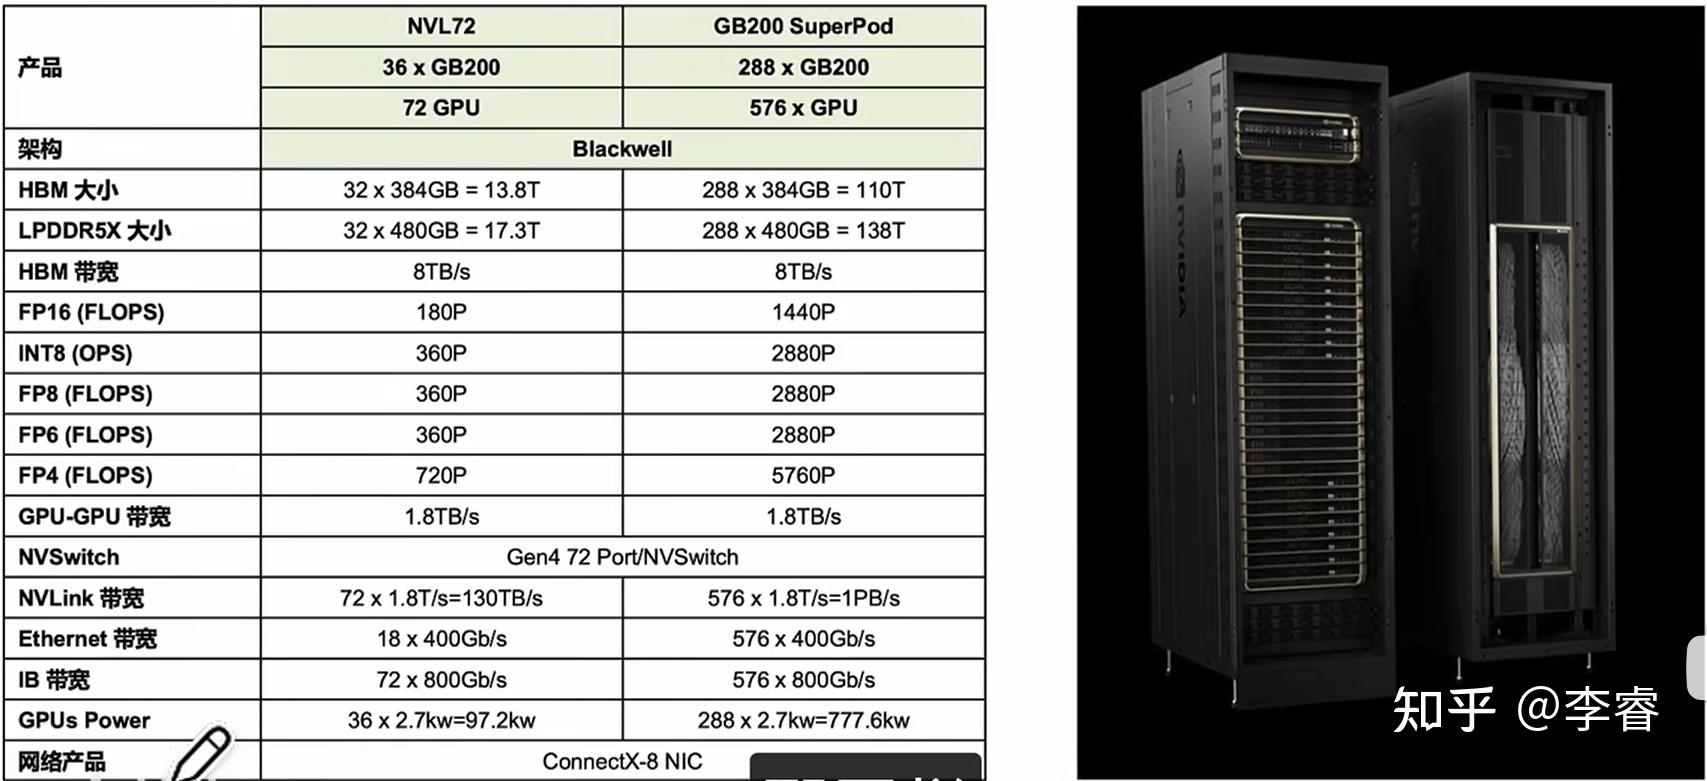
 NVL & SuperPod产品NVL32 -> NVL72,GPU数从32增加到72,FP16从32P到180P(近6倍)GH200 SuperPod -> GB200 SuperPod,GPU数从256到576,FP16从256P到1440P(近6倍)NVL72 & GB200 SuperPod采用ConnectX-8 IB网卡,带宽800Gb/s
 NVIDIA GPU架构发展B200、B100、GB200、NVL72、NVL32、SuperPod、GH200、H200、H100、L20、SuperPod-576ConnectX-800G网卡、网络交换机
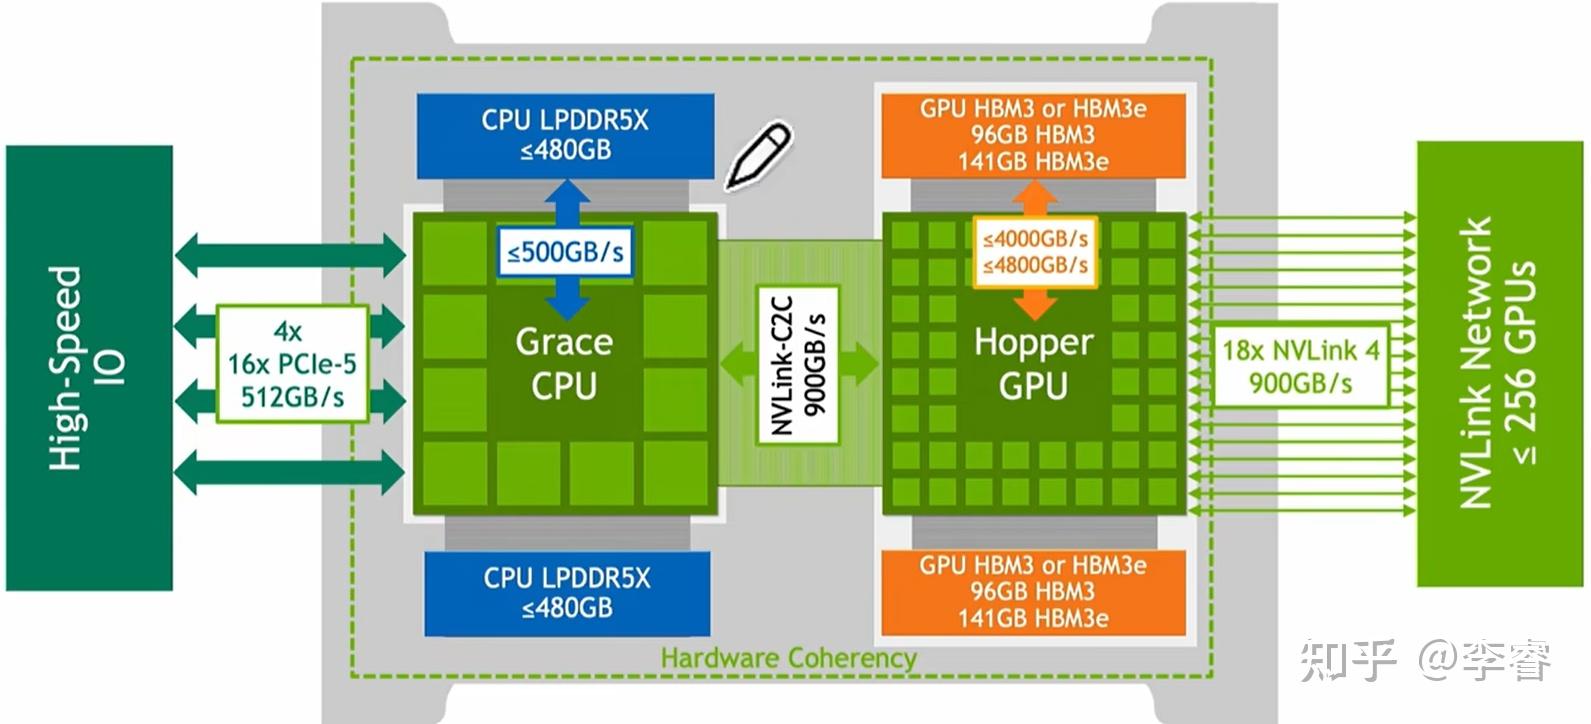
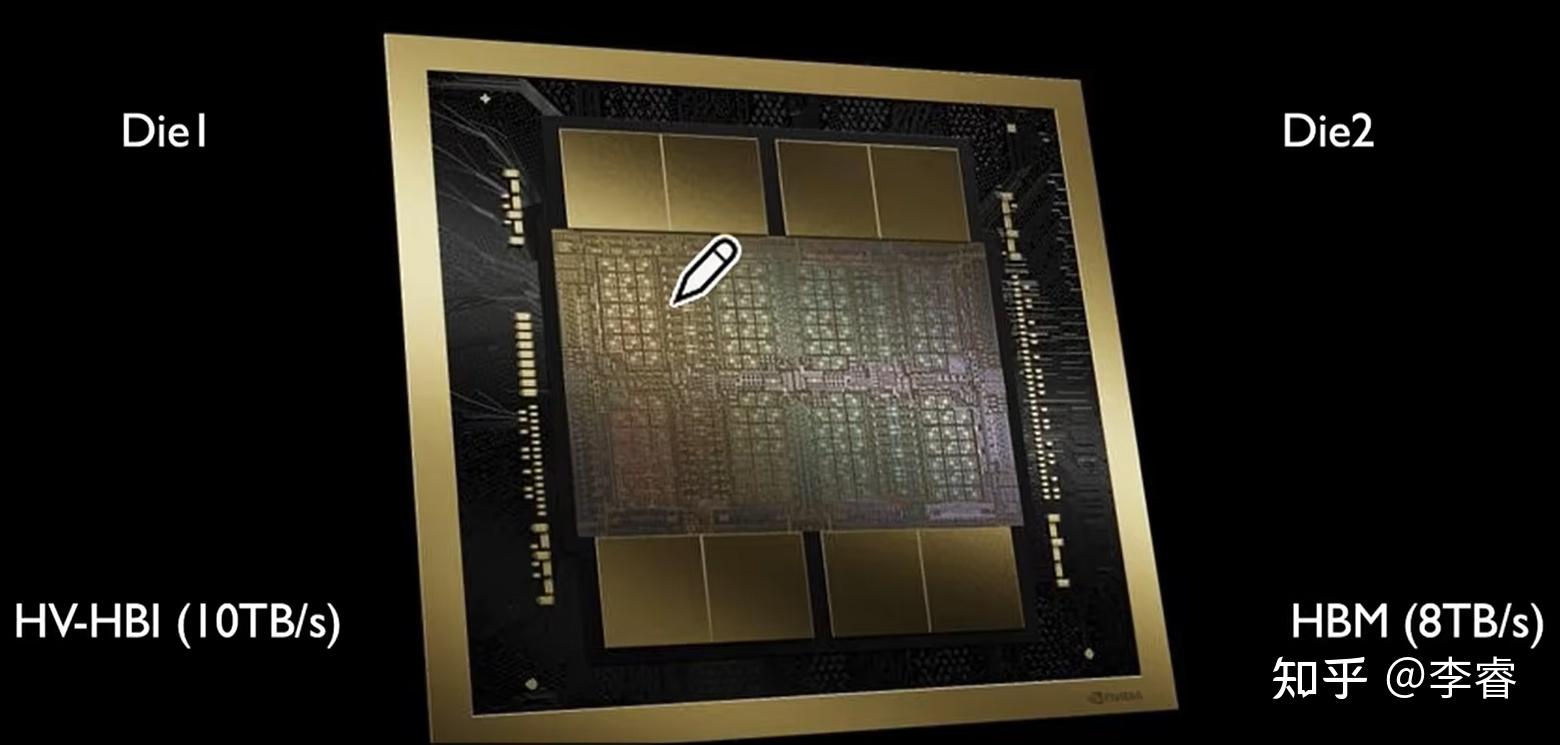 GPU芯片制造工艺Blackwell GPU和H100 GPU都采用台积电4nm工艺晶体管数H100包含800亿晶体管,Blackwell GPU包含2080亿晶体管,B200 GPU晶体管数为H100 2X这意味着B200芯片封装密度比H100进一步提高,对管理散热和功耗也提出了更高要求封装方式H100单Die(单个完整半导体单元)封装,Blackwell GPU封装2个DieB200每个Die算力大概为H100 1.25X,两个Die合封为H100 2.5XNV高带宽接口(Nvidia High Bandwidth Interface)B200 2Die,高速连接通道NV-HBI达10TB/s,并占用部分芯片面积FP4精度引入一种新计算精度格式,位宽比FP8进一步降低,B200峰值算力达18PFP6精度位宽介于FP4和FP8之间内存与带宽采用HBM3e,每片大小~24GB,理论带宽上限为1.2TB/s,实际为1TB/s,Blackwell芯片上共8个每个Die 4个HBM3e stack,一个GPU有192GB内存(8 * 24GB),内存带宽达8TB/s(8 * 24GB)相比H200 6个HBM2,可以减少内存接口芯片面积,使计算面积更大思考:制造工艺的性能提升变缓(B200每个Die算力大概为H100 1.25X,两个Die合封为H100 2.5X)封装能力提升解决工艺制造,封装技术从传统单die主处理芯片,演进到双Die合封NVIDIA's First GPU-CPU Superchip:GH200H200 GPU+Grace CPUH200 GPU显存为96GB or 144GBGrace CPU和Hopper GPU间通过NVLink-C2C互联,带宽为900GB/sHBM3e外Grace CPU外接480GB LPDDR 5X,带宽~500GB/s
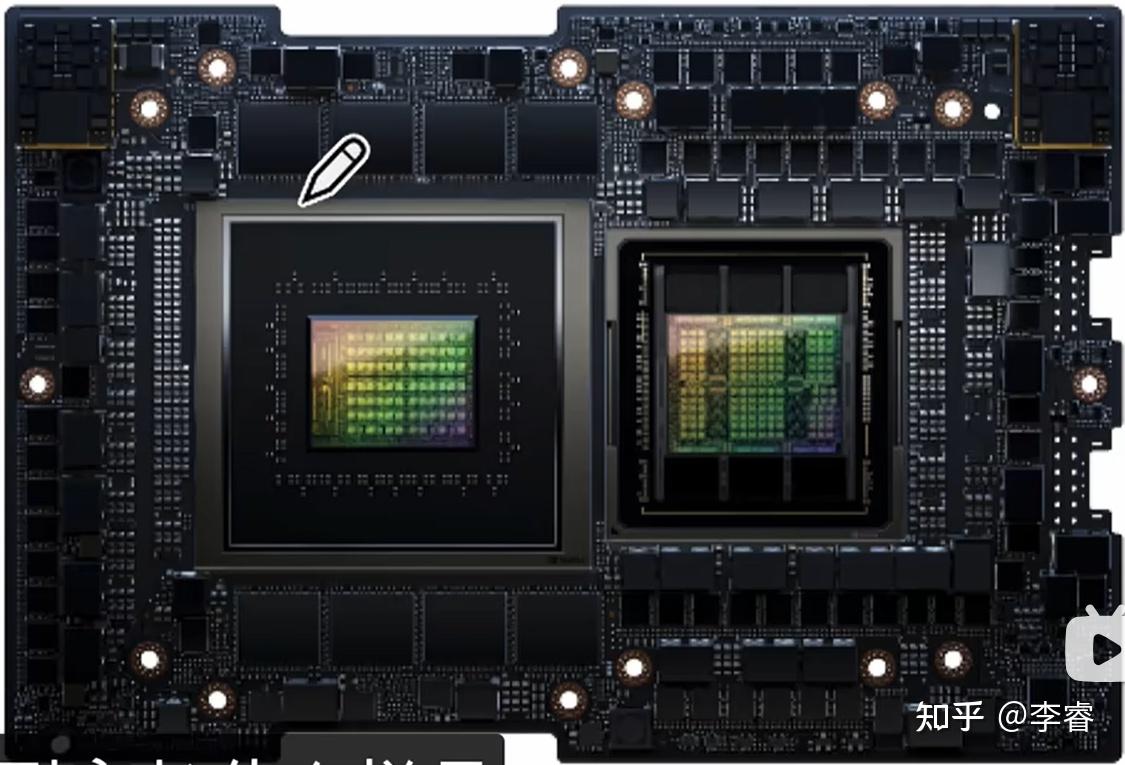 NVIDIA GH200 Grace Hopper SuperChip Logical Overview
 Access-Frequencey-Based Automatic Memory Migration
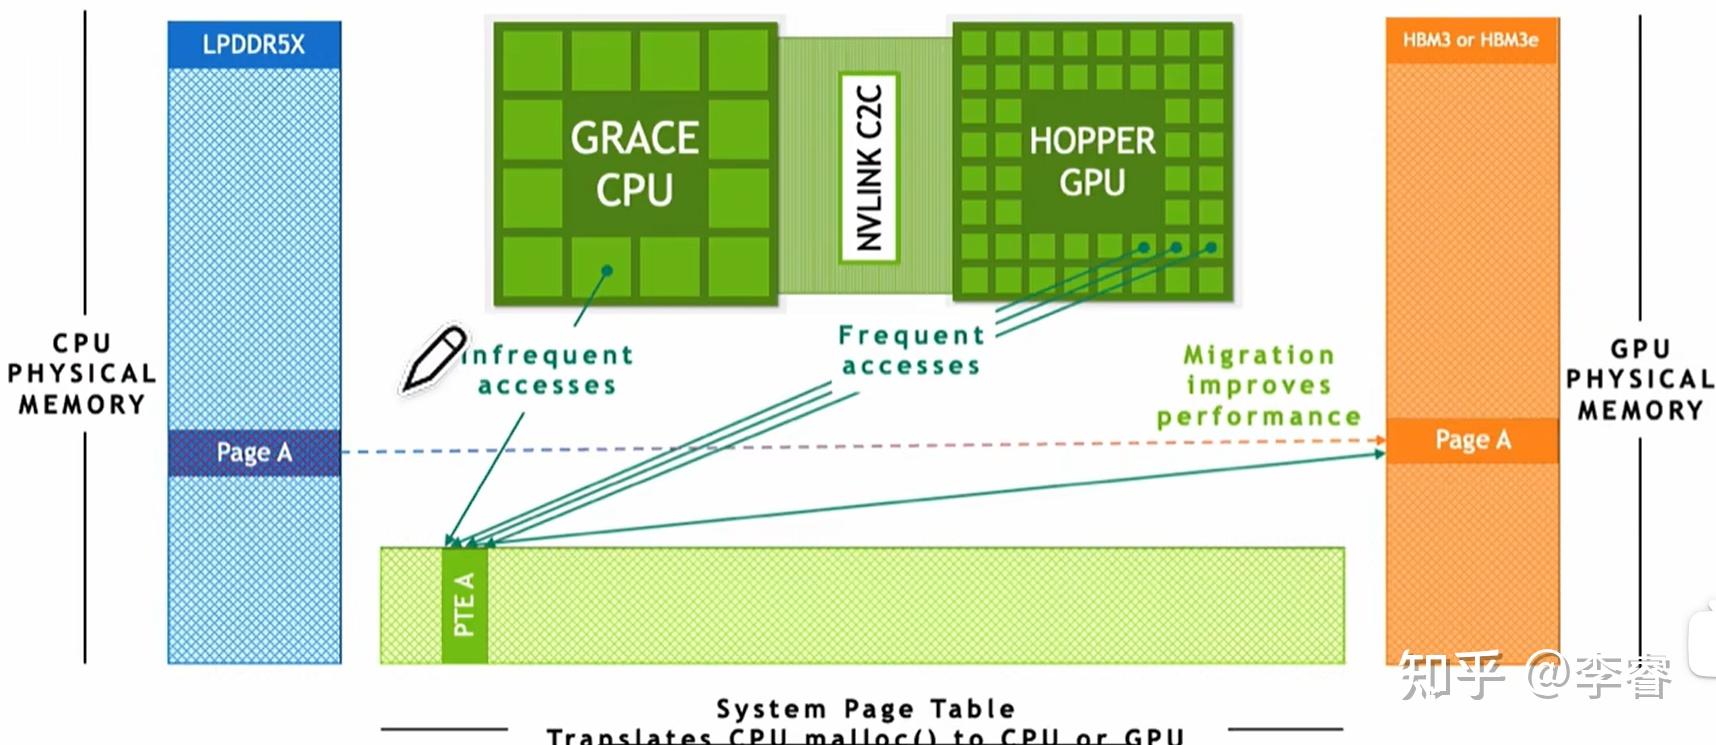
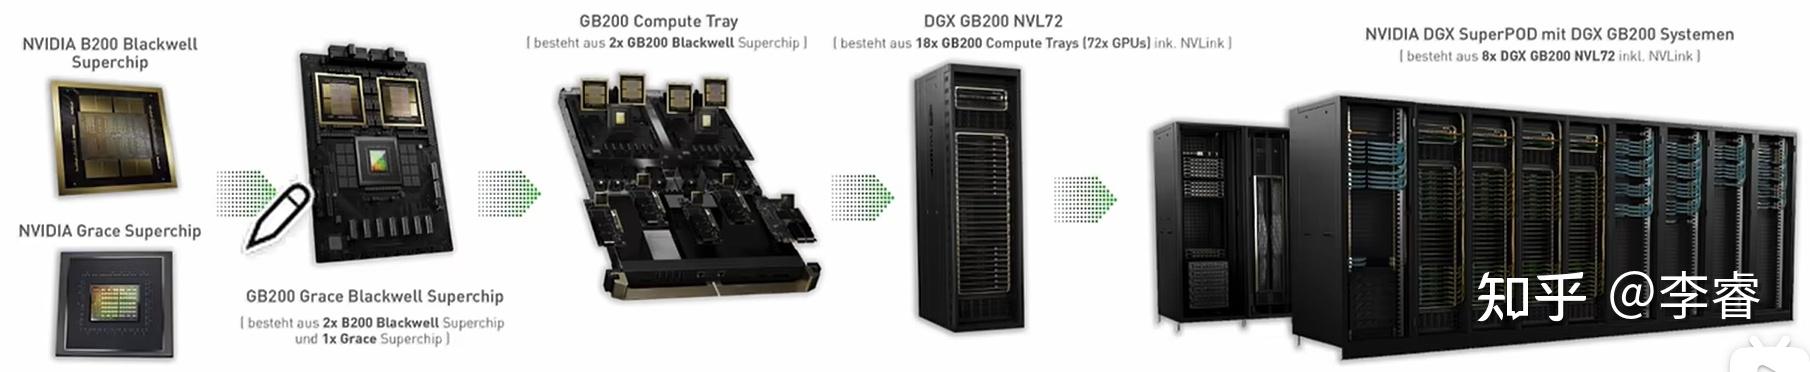
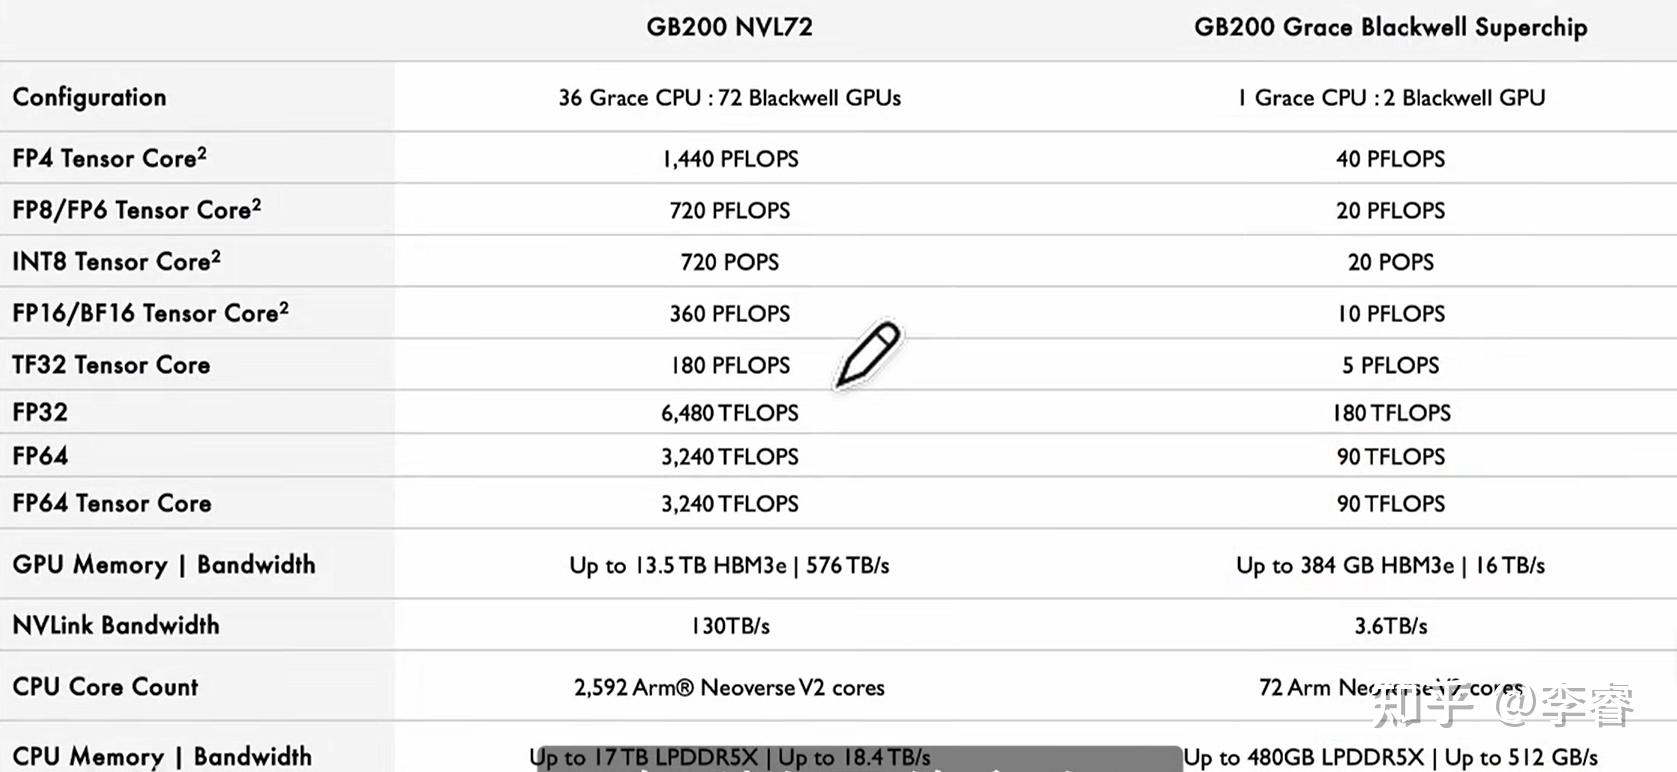
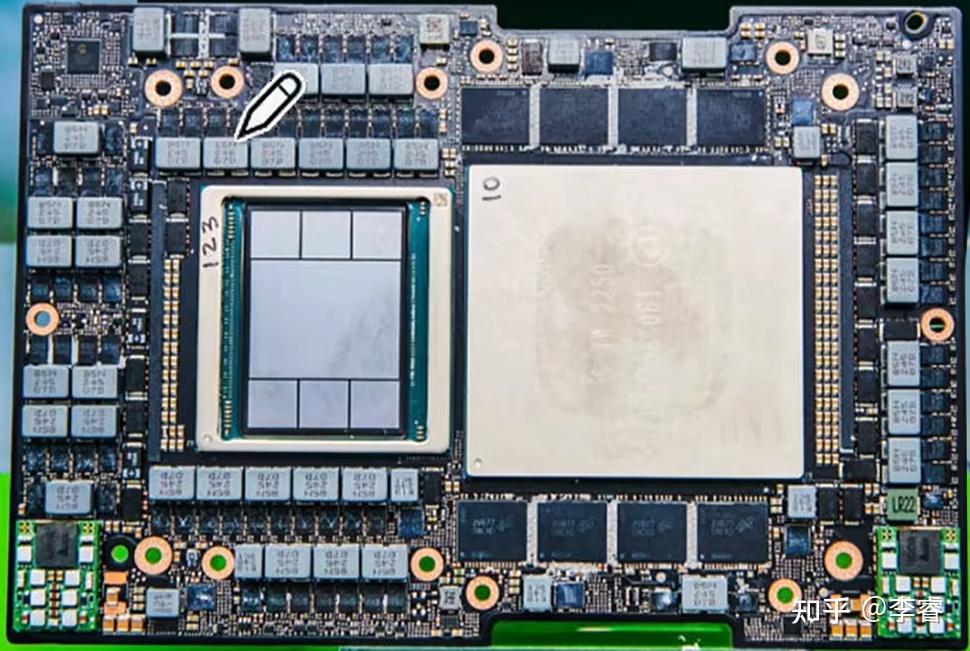 一个GB200由1个Grace CPU+2个Blackwell GPU组成,相应GPU算力和显存加倍CPU和GPU间通过900GB/s NVLink-C2C实现高速互联,功耗为1200w包含384 GB HBM3e显存,以及GH100,同样480GB LPDDR5X,Memory为384GB+480GB=864GB
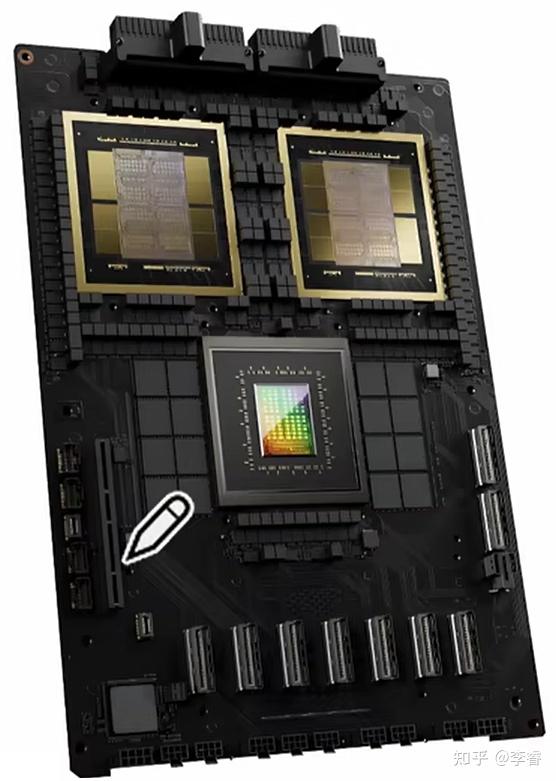
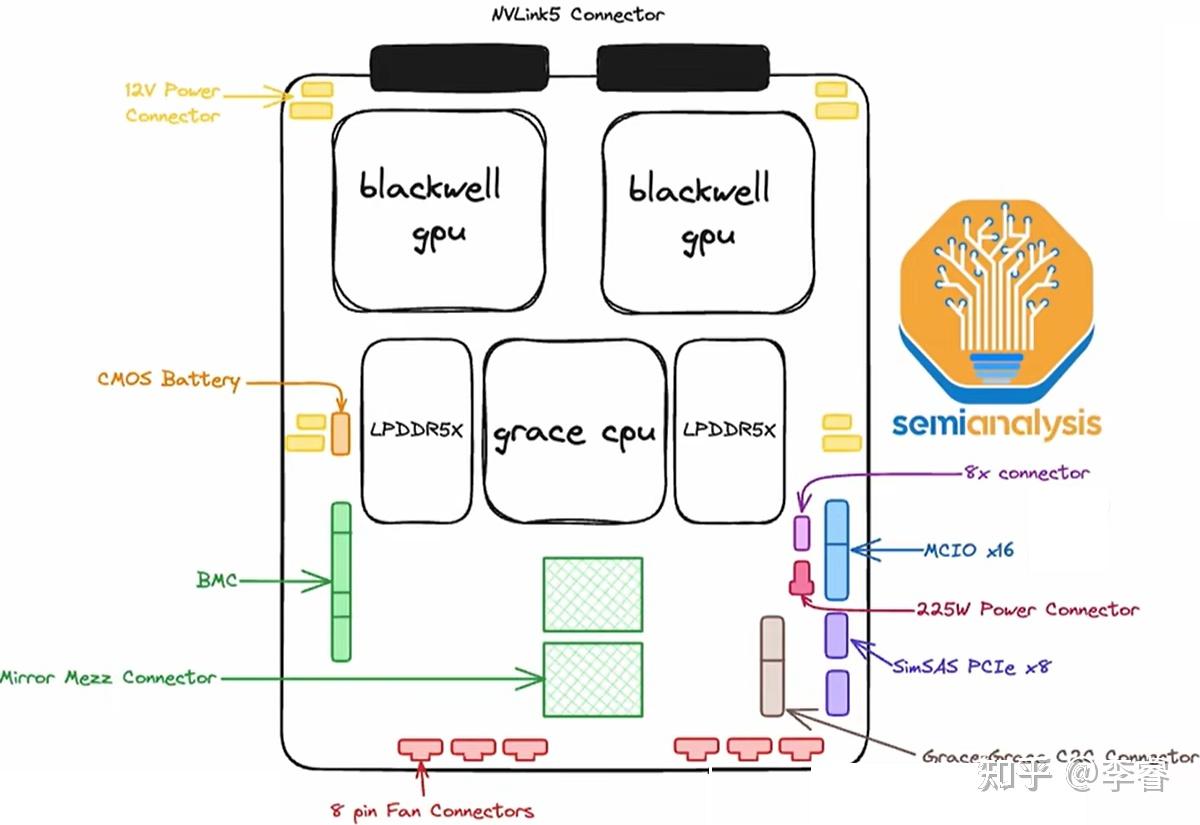 思考:Nvidia不仅使用封装技术来解决部件性能瓶颈,现在使用板卡(Rack)新概念Rack为超节点提供更加高密度的集成解决方案Host-Devices统一编址利于内存管理,特别是在大规模的推荐模型上HGX H/B 100/200
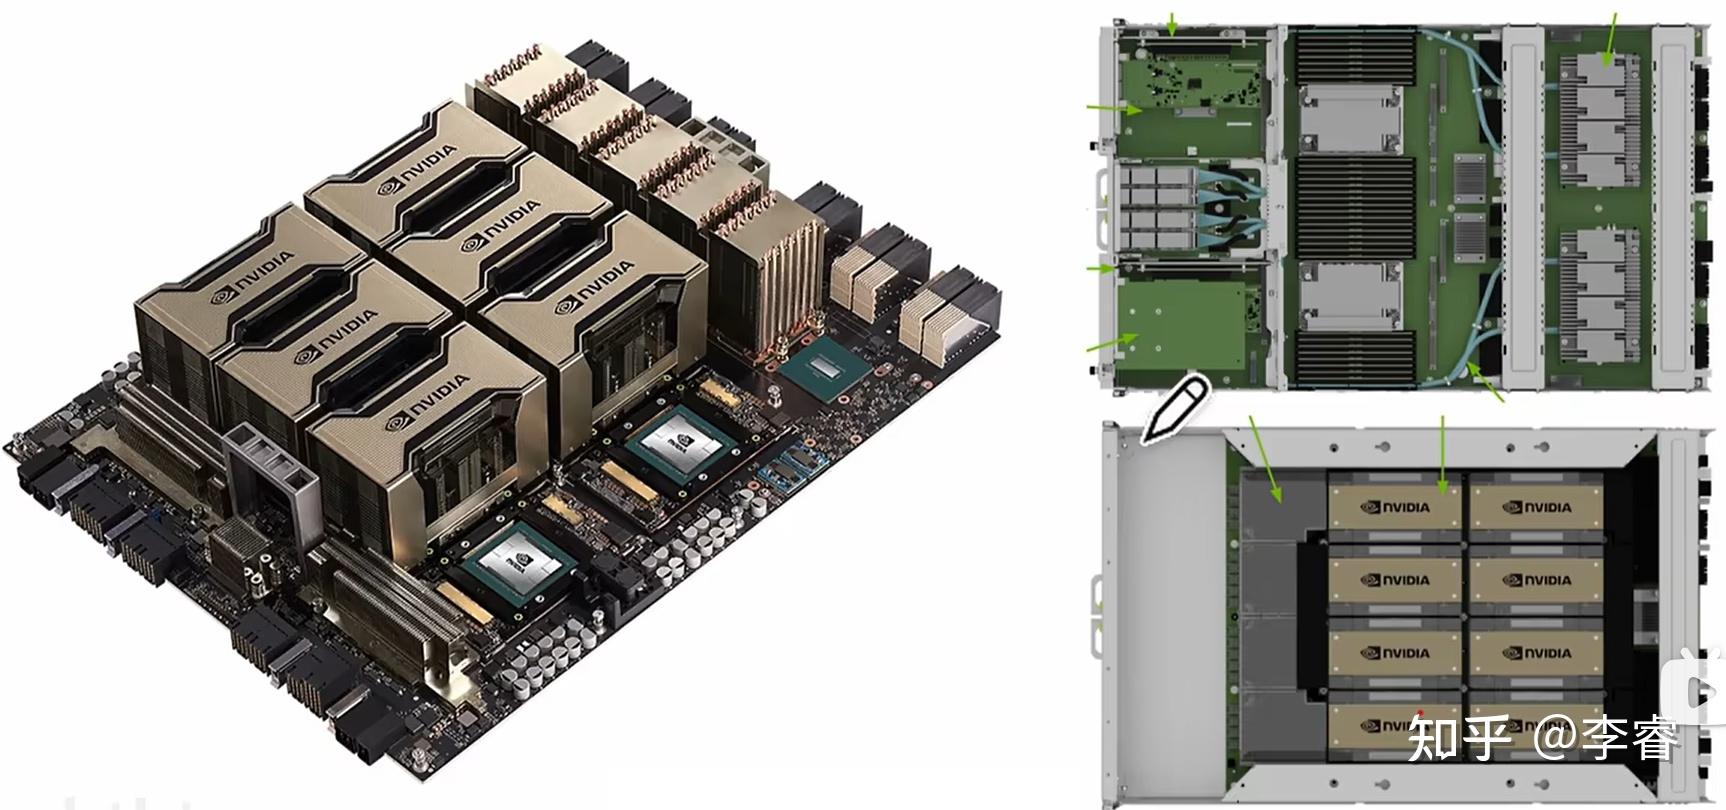
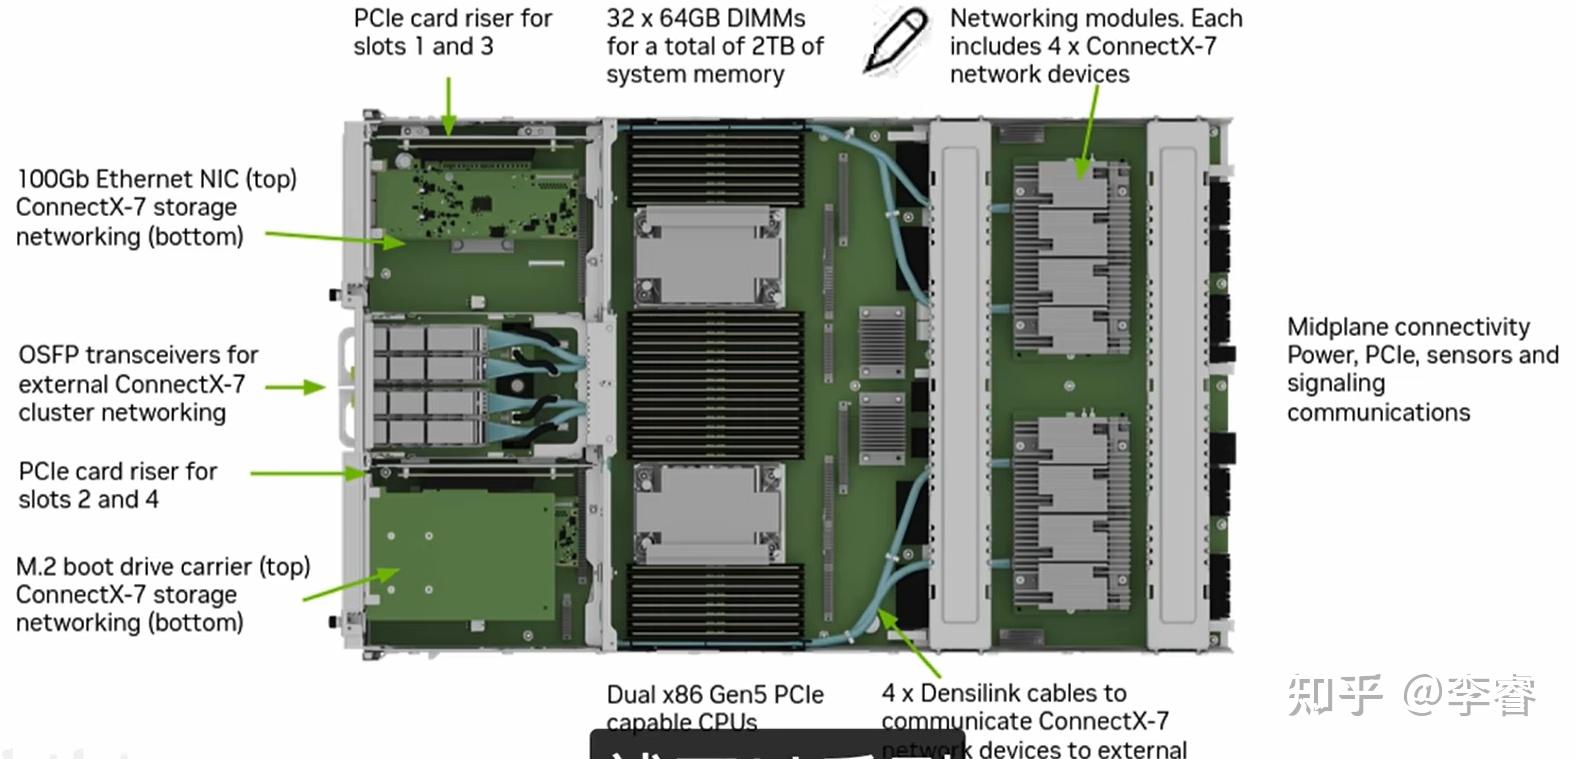 https://www.nvidia.com/en-us/data-center/hgx/B100和B200分别与之前的H100和H200对应,都是不带Grace CPU的版本,可以配合Intel CPU或AMD CPU使用
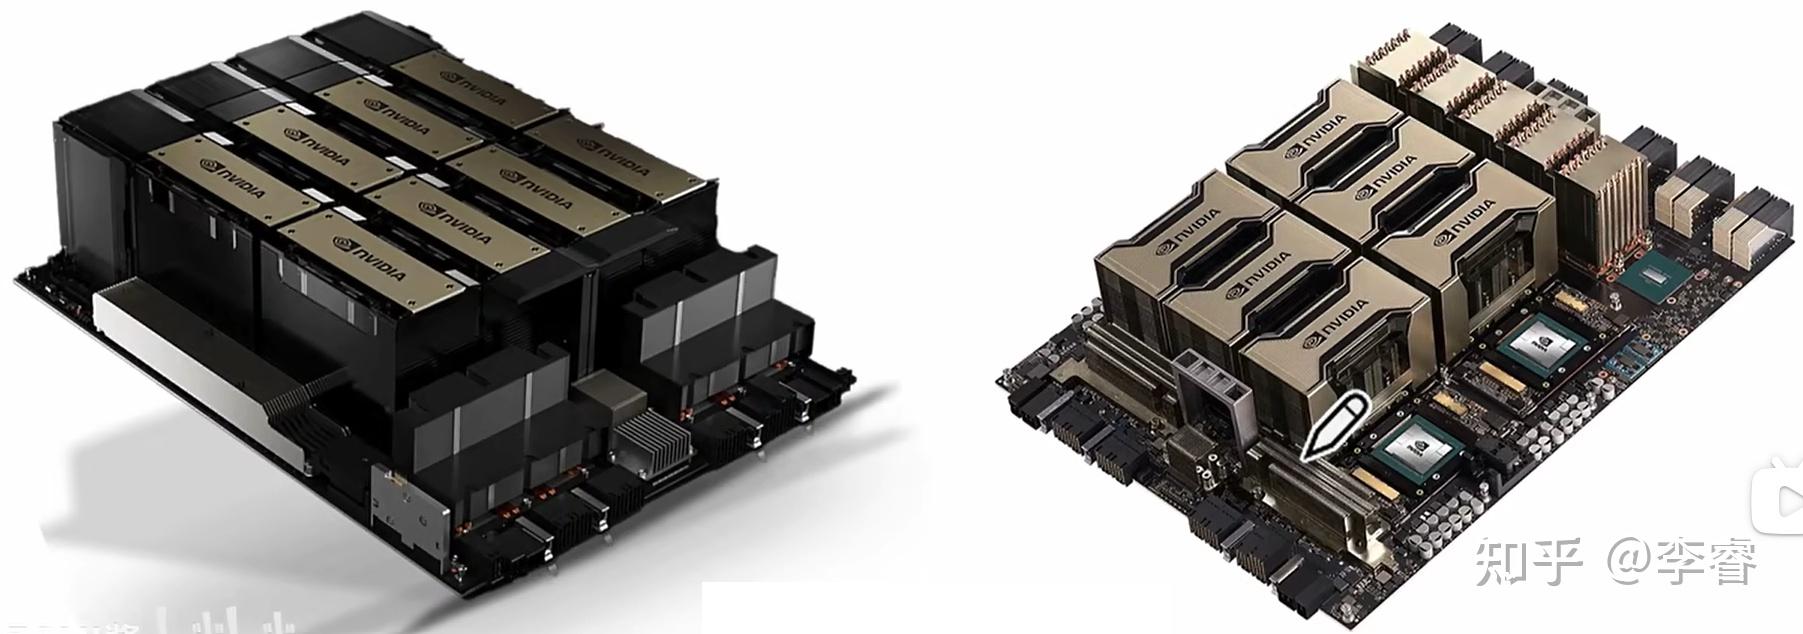

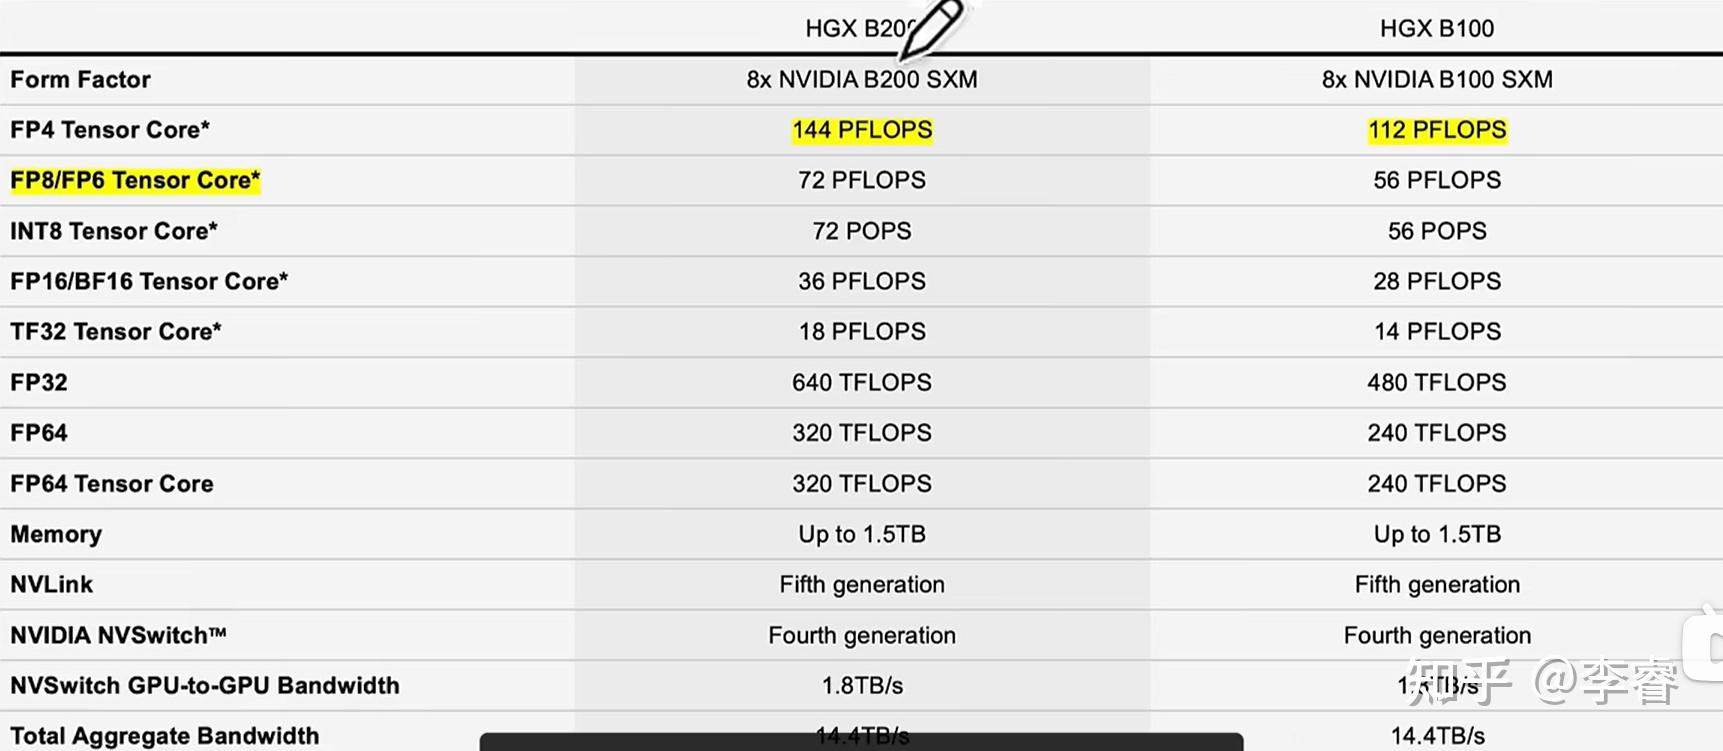 B100算力B200 ~ 3/4,8 x B100稀疏FP16算力为28PF,8xB200的稀疏FP16算力为36PF,可见8xB200的稀疏FP16算力为8xH100/H200的2.25倍,相当于单个B200的稀疏FP16算力为4.5PFBlackwell的Tensor Core相比Hopper添加了对FP6和FP4的支持,其FP4算力为FP8算力的2倍,FP16算力的4倍,而Blackwell的CUDA Core不再支持INT8,此外,从Hopper开始都不再支持INT4NVIDIA带宽基本分析NVLink传输带宽计算B200 NVLink 5th 带宽为1.8TB/s,这是针对计算带宽,按照内存带宽算法以字节每秒(Byte/s)为单位NVLink Switch或者IB/Ethernet交换机和网卡上,以网络带宽来计算,按照传输数据位以比特每秒(bit/s)为单位第一代NVLink P100 DEMO单条NVLink是一种双工双路信道,其通过组合32条配线,从而在每个方向上可以产生8对不同的配对(2bit x 8 pair x 2 wire = 32wire)P100上,集成了4条nvlink,每条link具备双路共40GB/s的带宽,整个芯片具备整整160GB/s的带宽
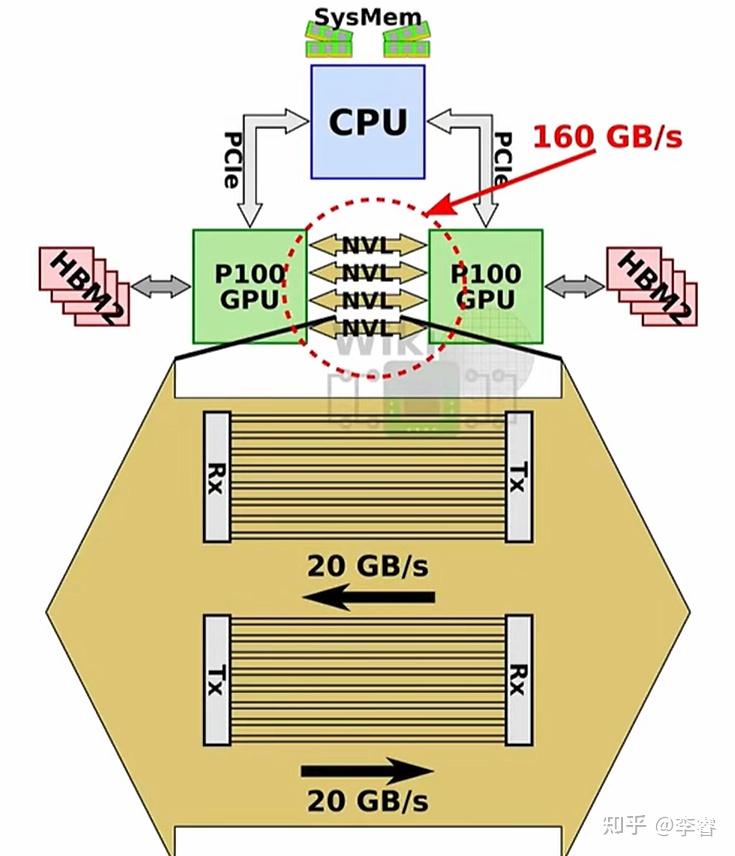 NVLink连接P100 supports 4NVLinksUp to 94% Bandwidth efficiencySupports read/writes/atomics to peer GPUSupports read/write to NVLink-enabled CPULinks can be ganged for higher bandwidth
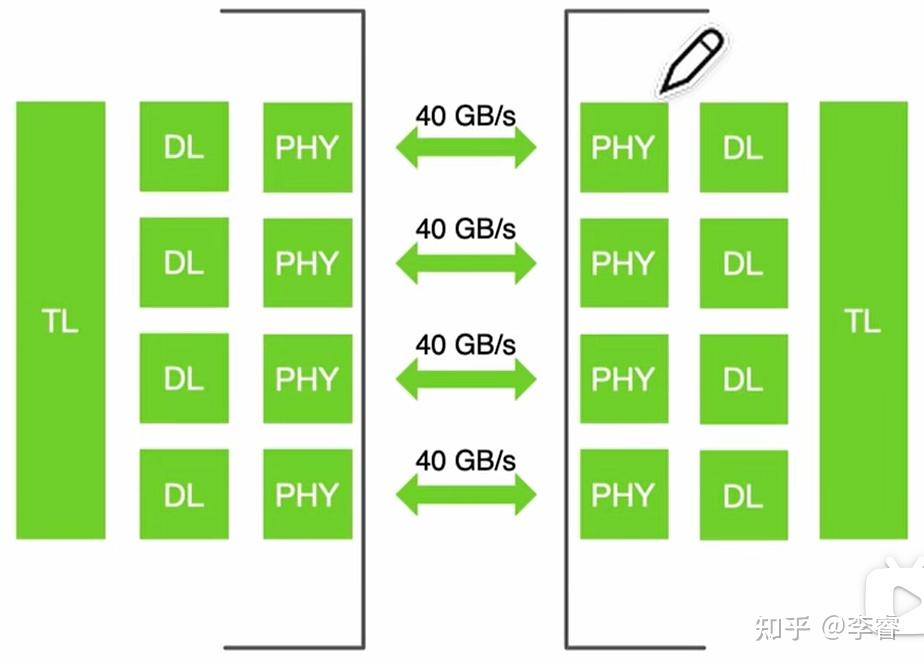 NVLink通道称为Brick。单个NVLink是一个双向接口(Port),每个方向包含8个差分对,总共32条线。电气连接线使用直流耦合DC coupled,带85欧姆差分终端
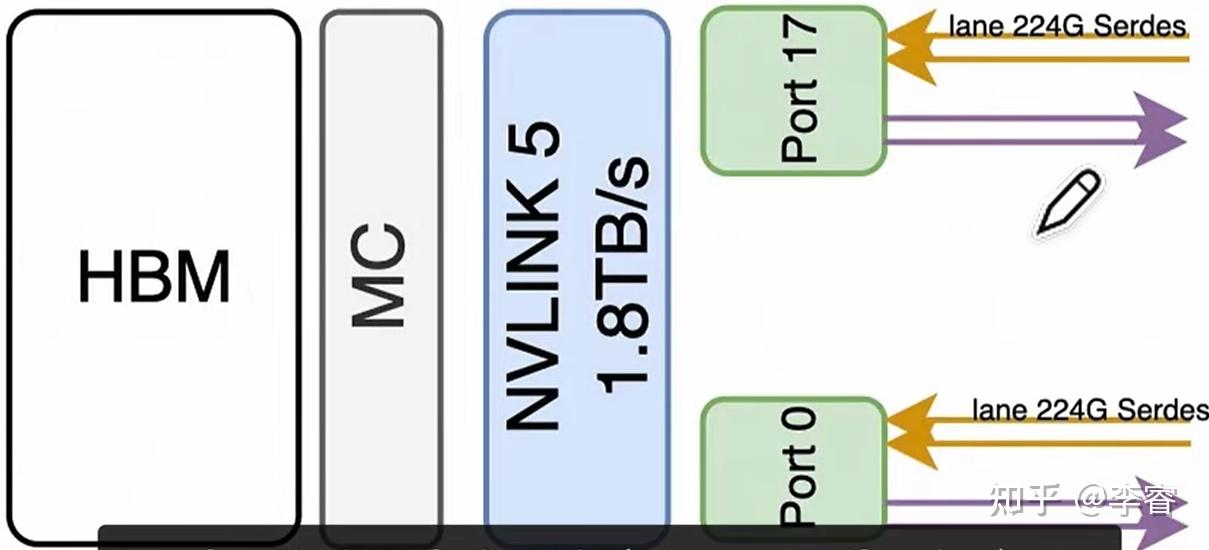
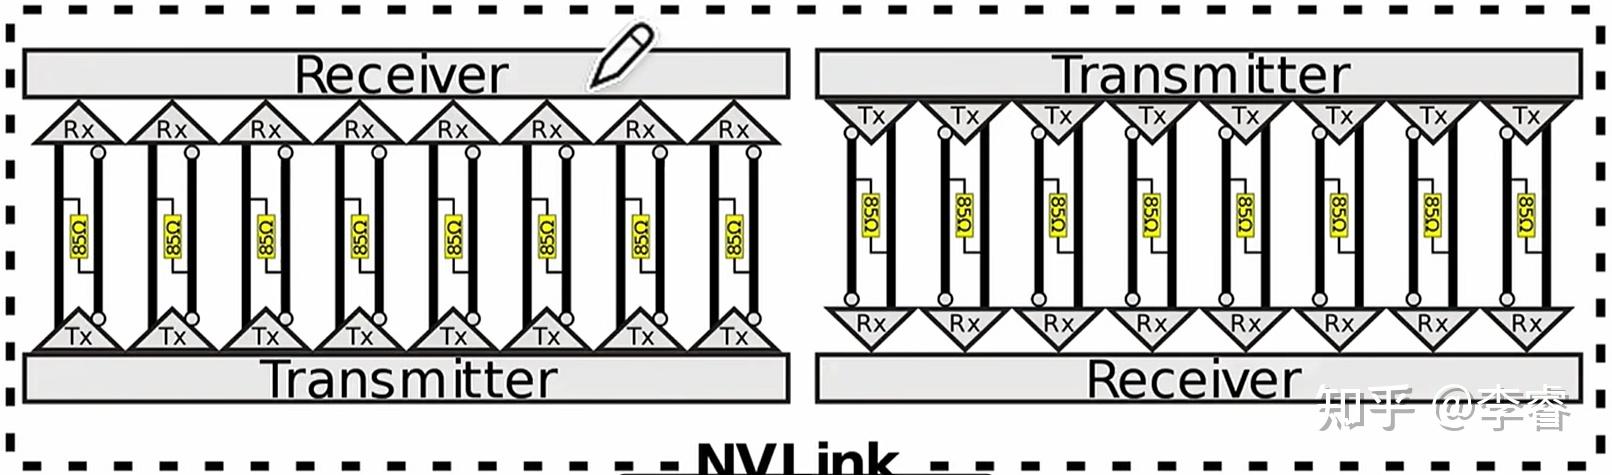 4对差分信号线同时包含接收和发送方向信号线,在计算网络带宽时,400Gbps Ports指同时能够收发400Gbps数据4对差分信号线构成RX/TX各两对,从网络视角来看是一个单向400Gbps链路,而从内存带宽视角是支持100GB/s访存带宽NVSwitch & NVLink介绍第5代NVLink第5代NVLink每个GPU上有18个NVLink,单Link双向带宽从H100 NVLink 4th的50GB/s升级到100GB/s。所以B100 & B200 GPU-to-GPU带宽上限为1.8TB/s(18 x 100GB/s)
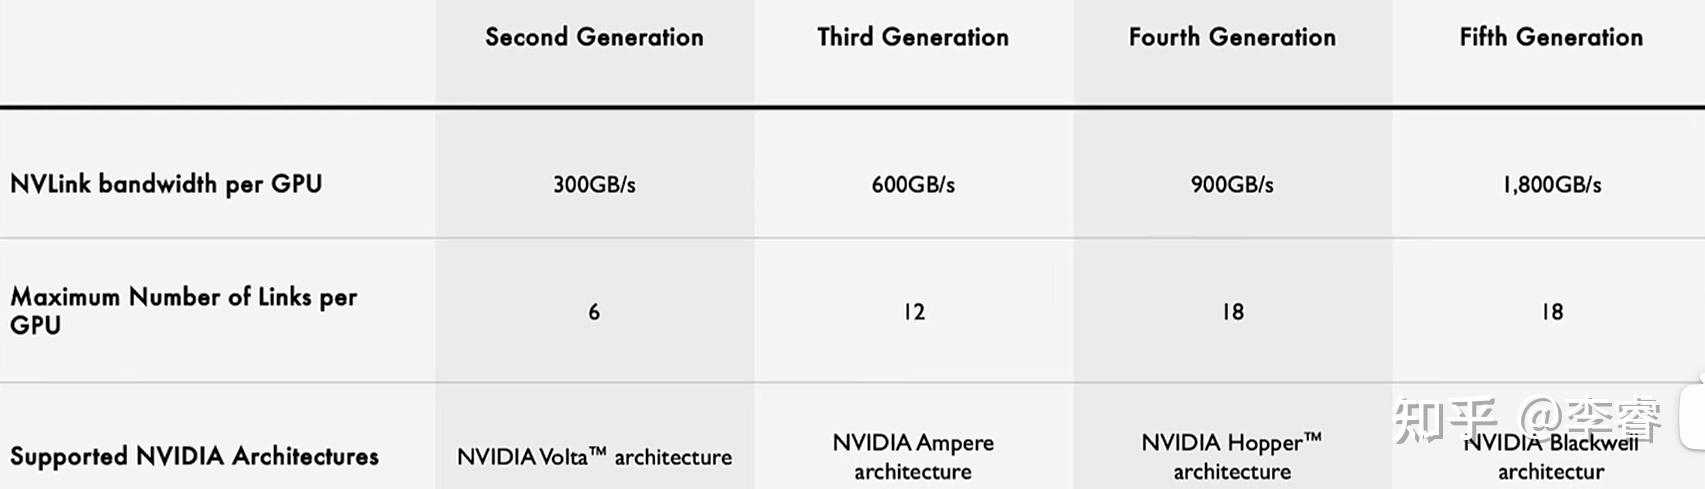 NVLink 5th 带宽计算B200 NVLink带宽为1.8TB/s,由18个Port构成,即每个Port 100GB/s,由四对差分线构成,每个Port包含两组224Gbps的SerDes(2x224G-PAM4按照网络接口算为每端口单向400Gbps带宽)
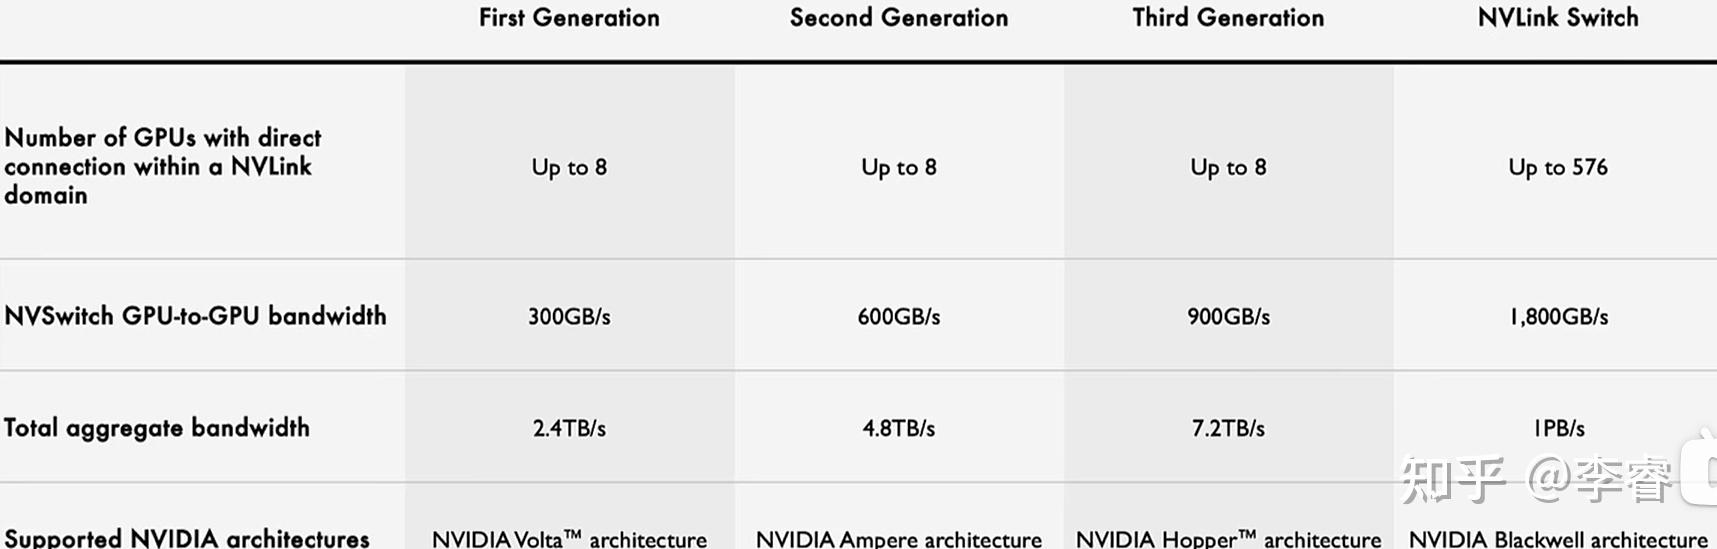
 第4代NVSwitch第4代NVSwitch GPU-to-GPU带宽扩大一倍,变为1.8TB/s,最多可以支持576个GPU,总带宽上限为576 x 1.8TB/s = 1PB/sNVLink是具体通讯的协议,NVSwitch网络协议或网络通讯的电缆所组成的一个具体的芯片和对应的产品第五代NVLink对应的是第4代NVSwitch
 NVLink Switch ChipNVSwitch Chip上有72个NVLink Port,每个Port 2个Lane,双向带宽为2 x 2 x 200 Gb/s = 100GB/s72个Port对应7.2TB/s,1.8TB/s NVLink对应18个Port传输20GB仅需22毫秒,对于大模型一层Transformers的反向聚合完全够用
 NVSwitch Tray
 NVSwitch作用
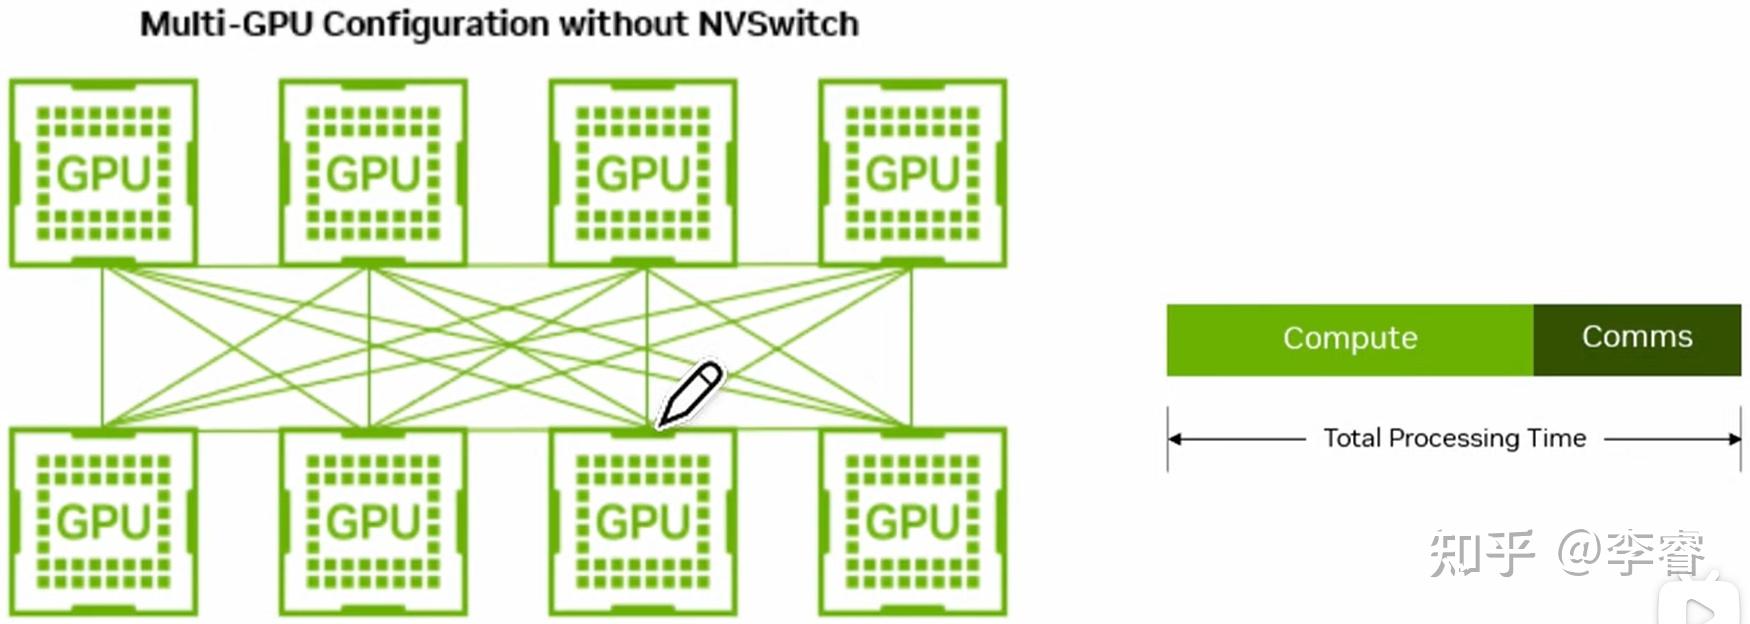
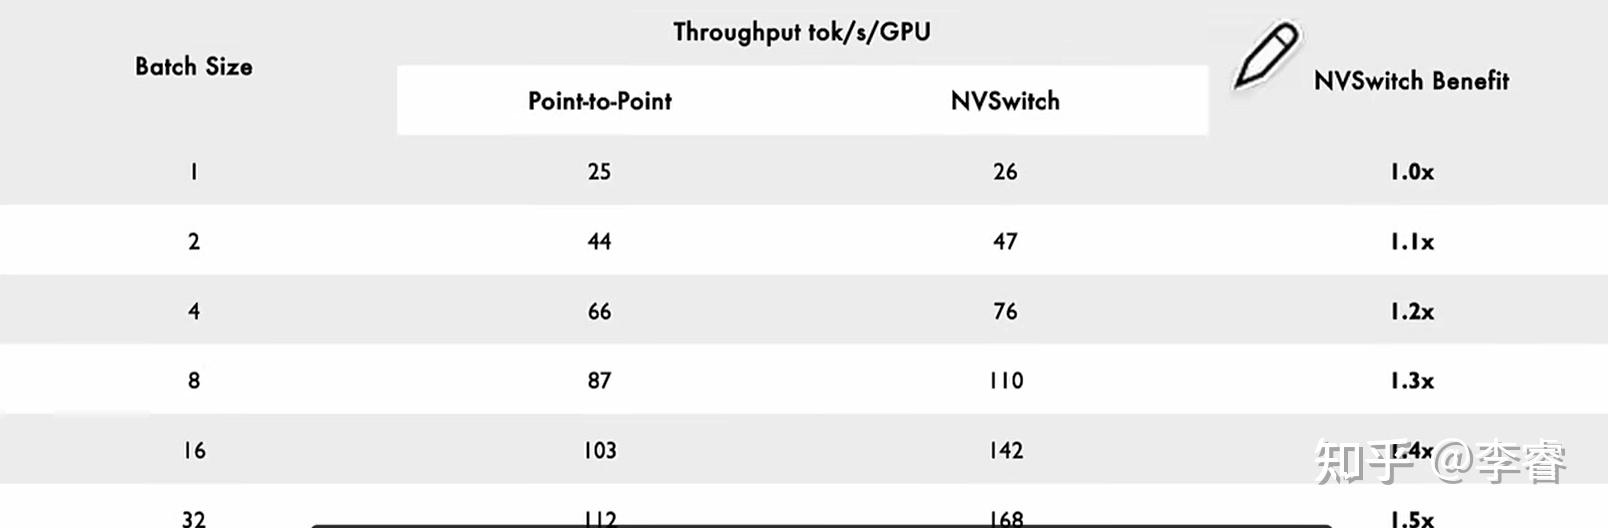
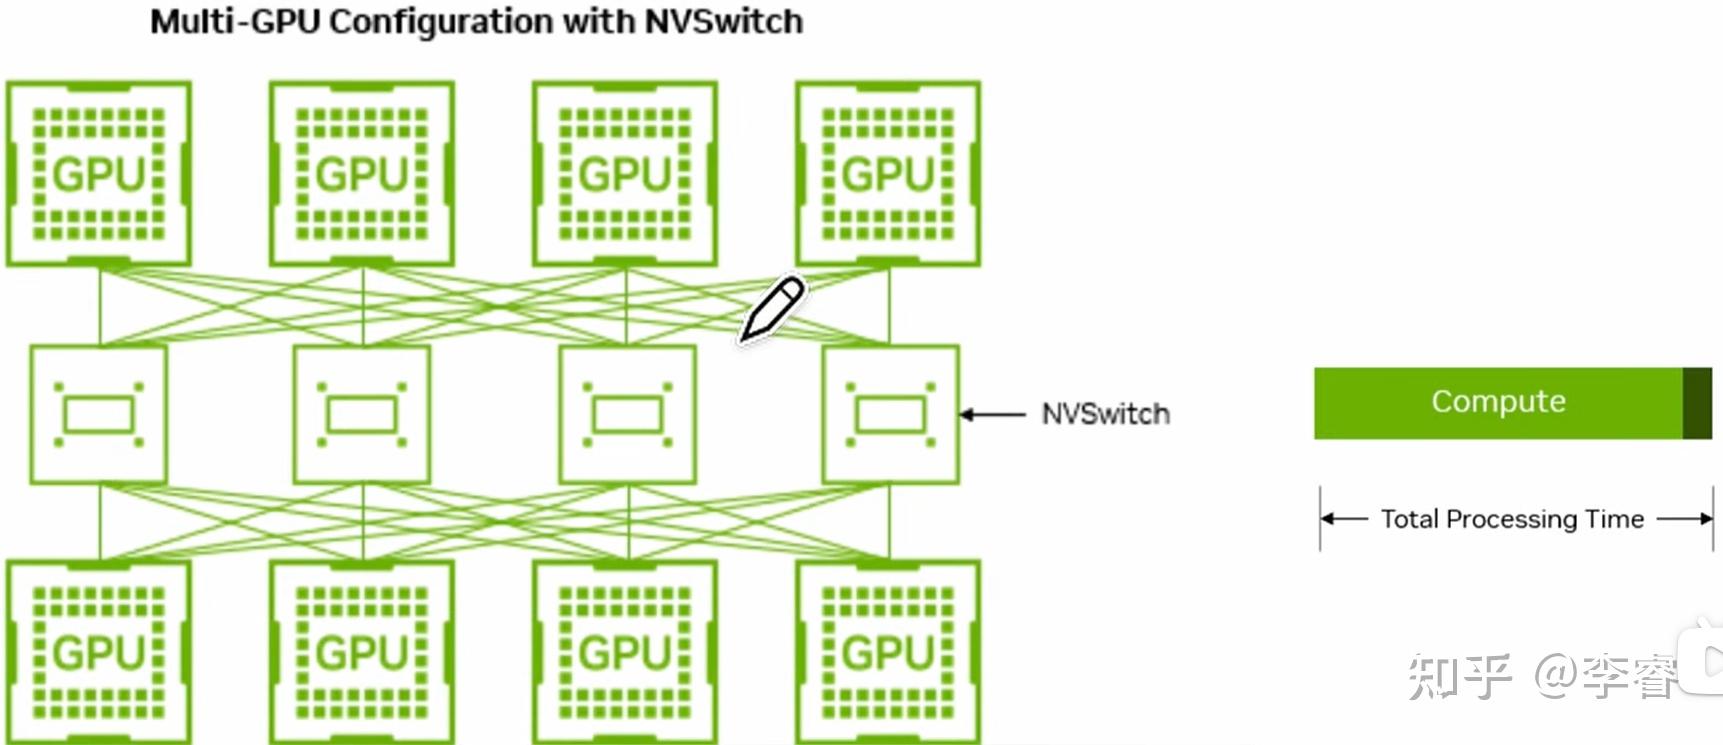 使用Llama3.1 70B来测试在30~50 tokens/s/user的网络吞吐带宽,其中ISL/OSL = 8k/256
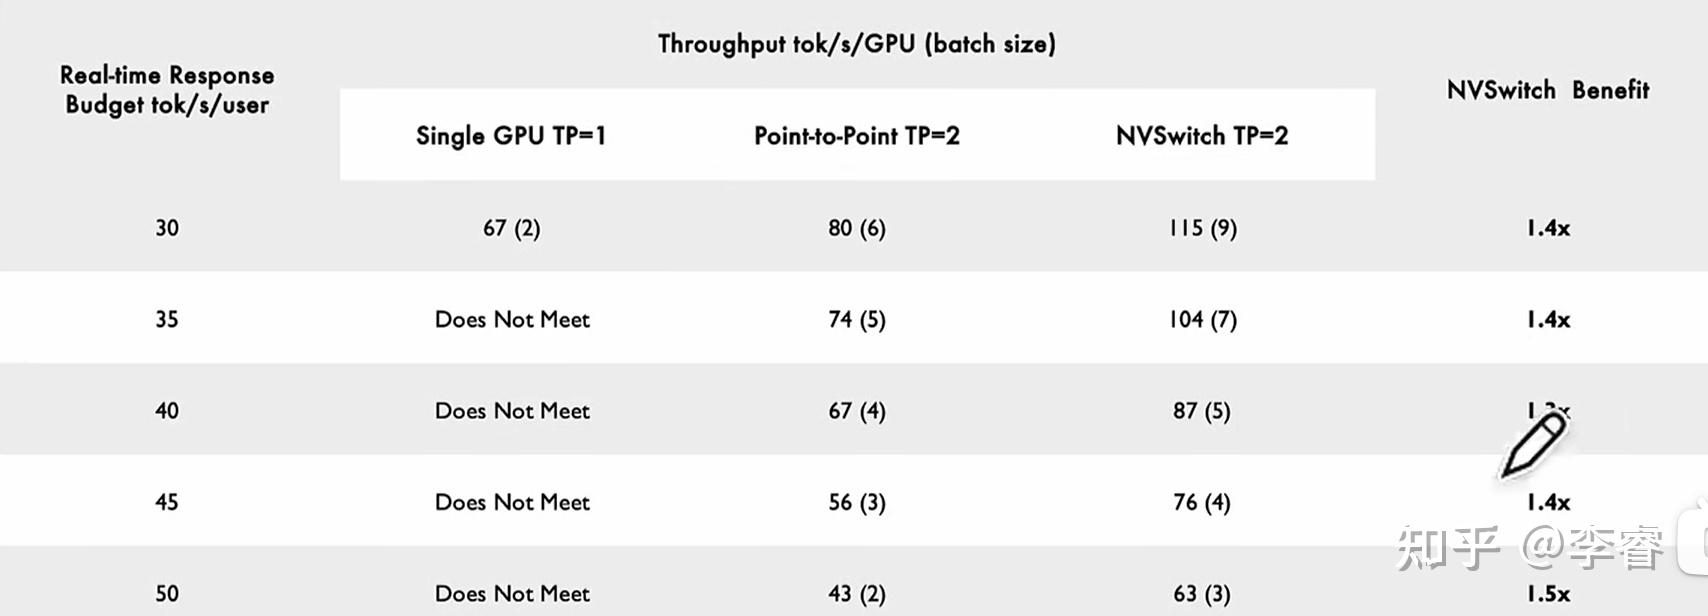 固定批处理大小下的整体服务器吞吐量,更大的批处理大小意味着可以一次处理越来越多用户的请求,从而提高整体服务器利用率并降低每次推理的成本
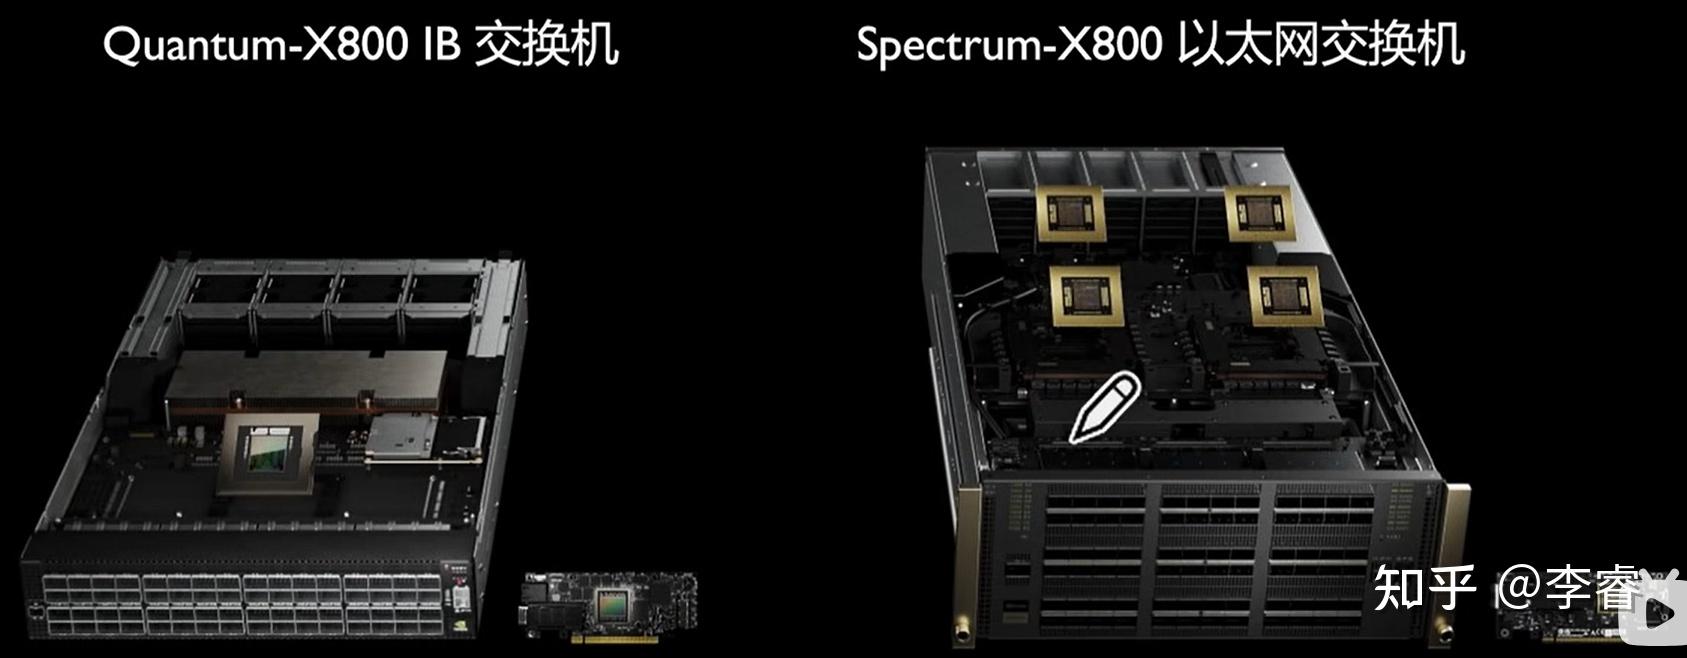
 网卡 & 交换机ConnectX-8网卡DGX B100/B200发布新一代IB网卡ConnectX-8,相应通信带宽为800Gb/sH100/H200采用的为ConnectX-7网卡,对应的通信带宽为400Gb/sA100采用的ConnectX-6网卡的通信带宽为200Gb/sHGX B100/B200依旧使用的上一代ConnectX-7
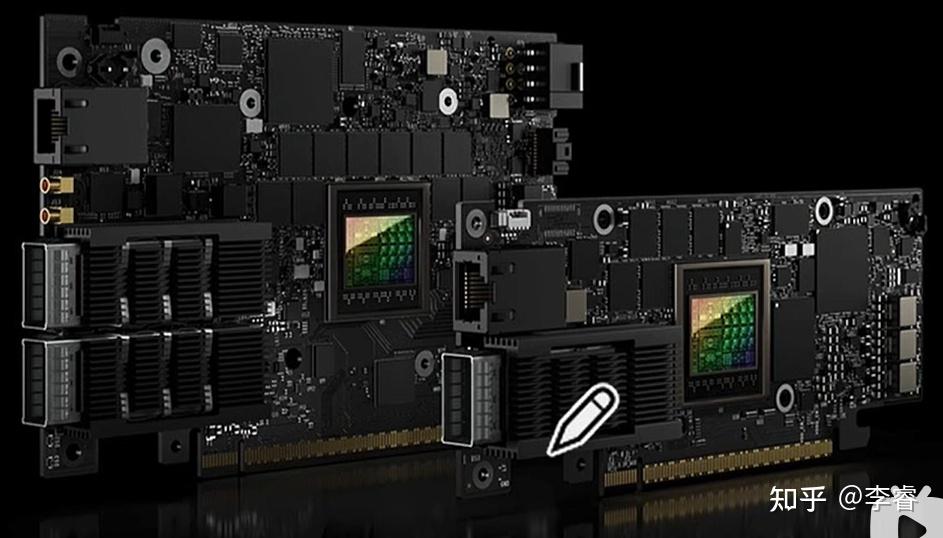
 BlueField-3 DPU/SuperNICBlueField-3支持以太网和IB,速度高达400Gb/s,与网络、存储等结合BlueField-3 SuperNIC可以在GPU节点间通过以太网直连支持单Port 400Gb/s,或双Port各200Gb/s
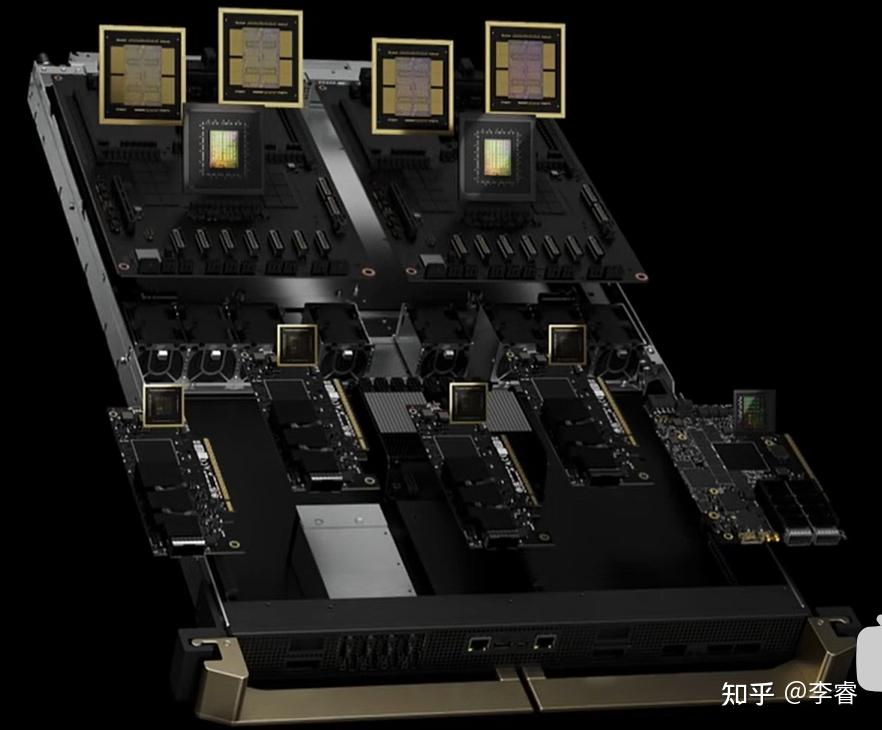
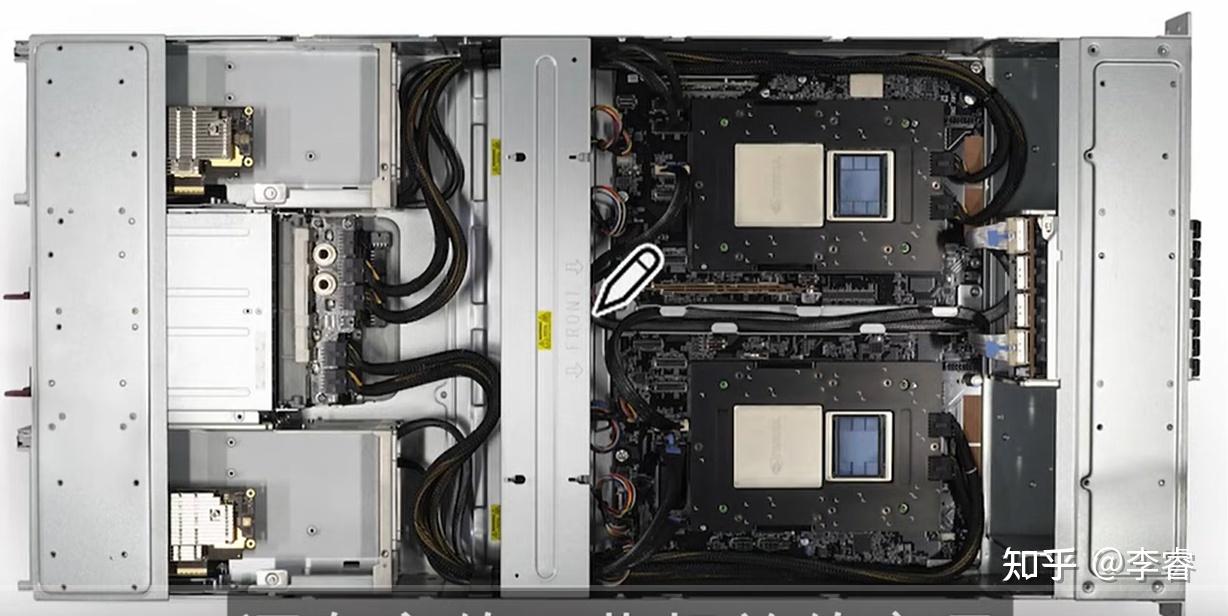
 GH200 to NVL32 & SuperPodGH200 Compute TrayGH200 Compute Tray基于NVIDIA MGX设计(IU),每个Compute Tray上有2个GH200,也就是2个Grace CPU和2个H200 GPU
 NVSwitch Tray第一代NVSwitch Tray包含2个第3代NVSwitch芯片,共128个NVLink Port,通信带宽上限为6.4TB/s
 GH200 NVL32一个机柜有16 x GH200 Compute Tray和9 x NVSwitch Tray,共32 x GH200 GPU + 18 x NVSwitch实际32 x GH200 有32x18=576个NVLink,只需576/64=9个NVSwitch可以实现全互联
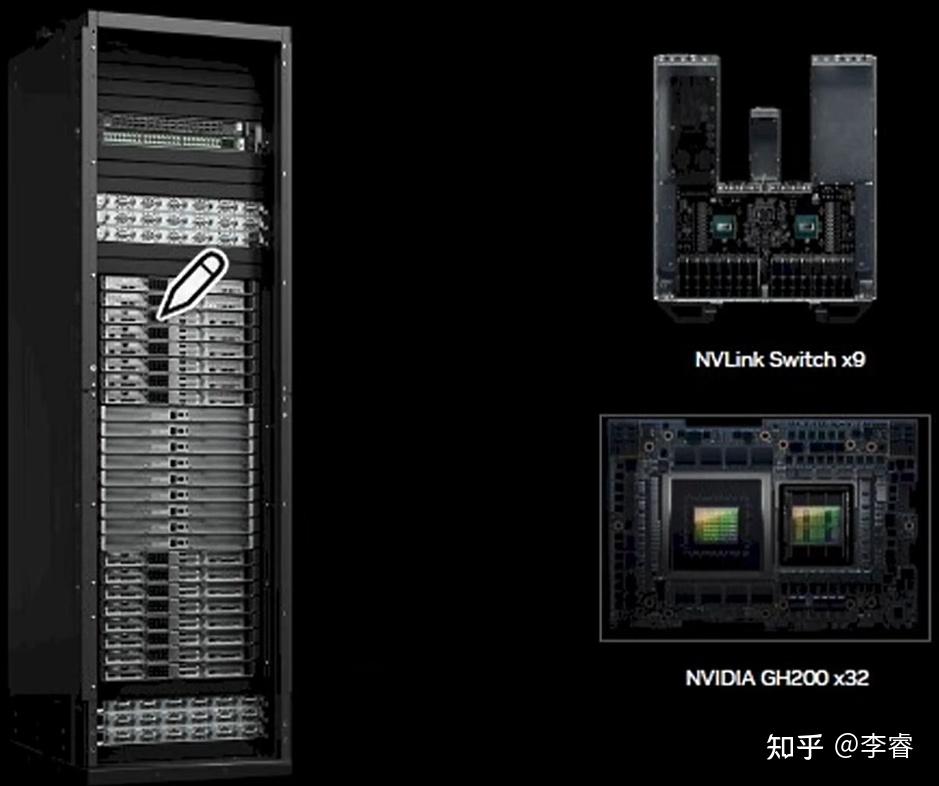
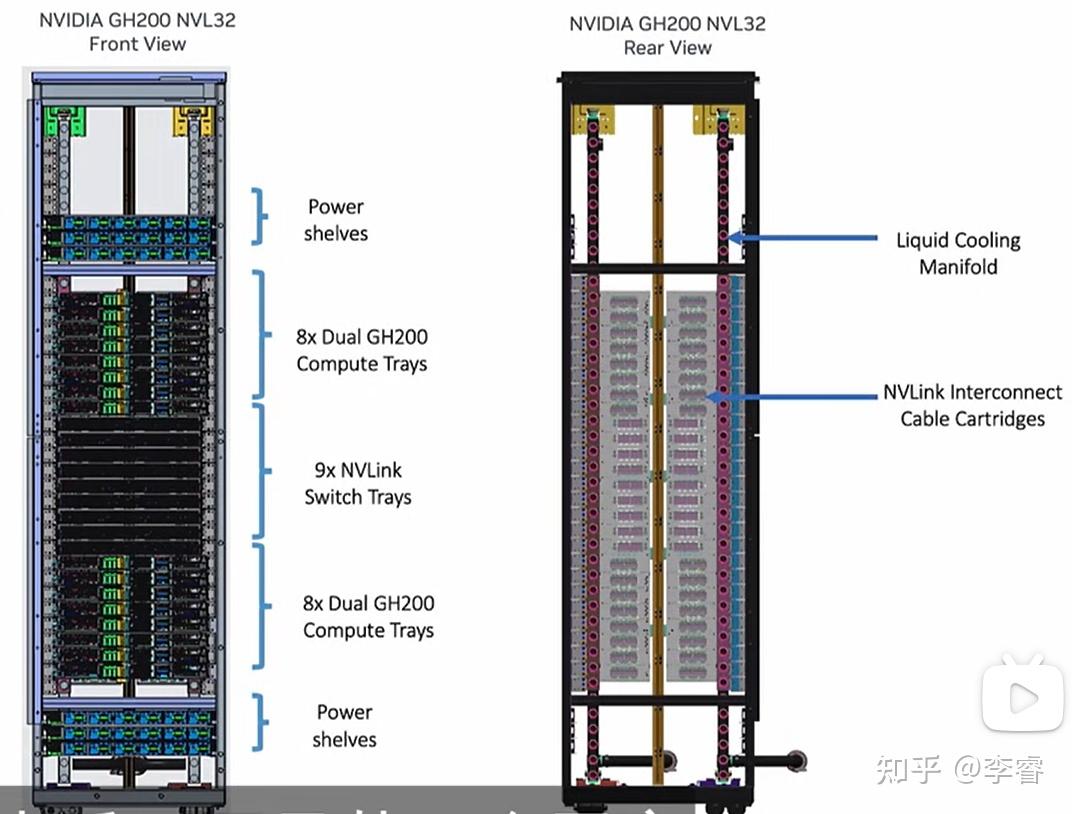 GH200 SuperPodGH200 SuperPod由256个GH200 GPU实现全互联,但并不是由8个NVL32组成的,而是由32个8-Grace Hopper Superchip组成
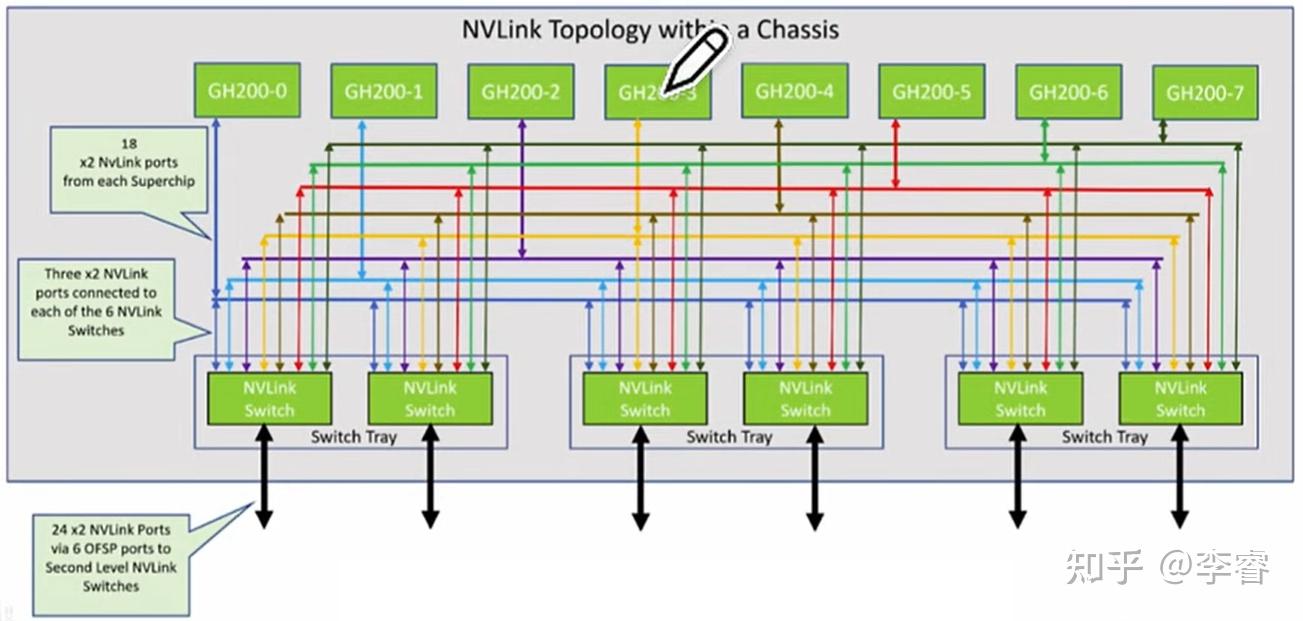
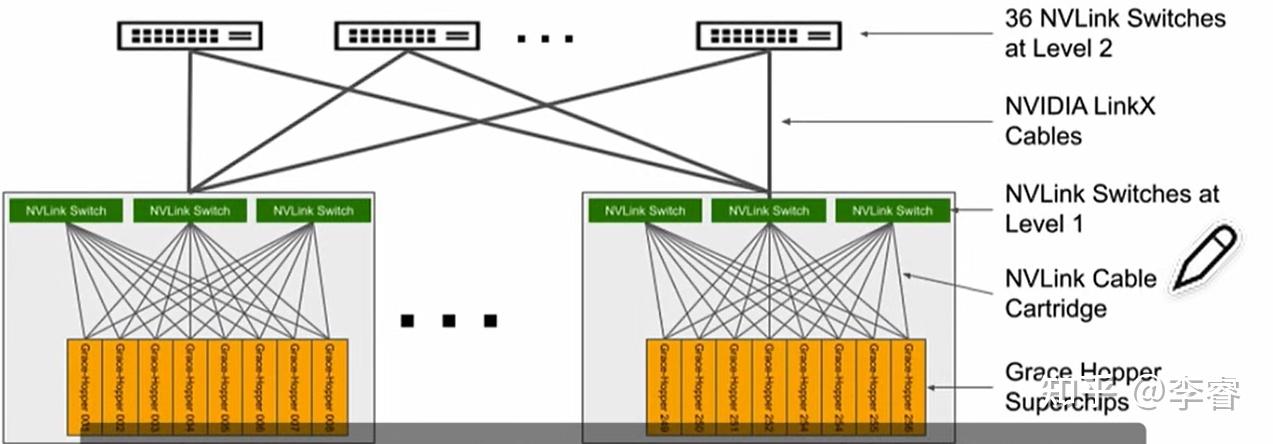
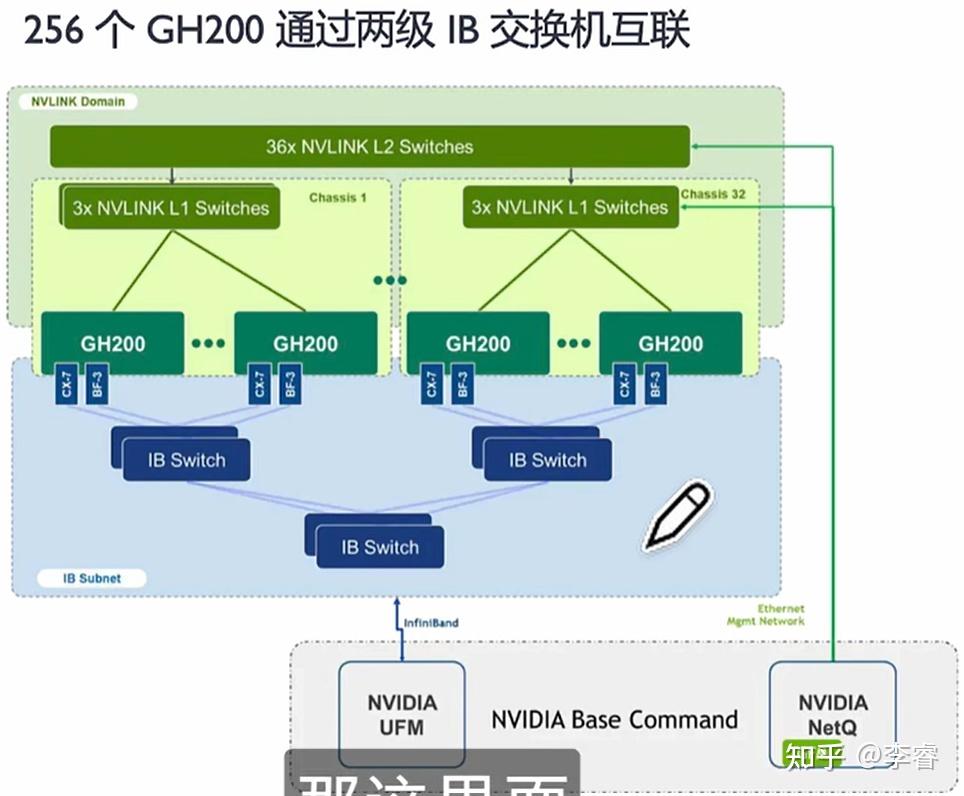
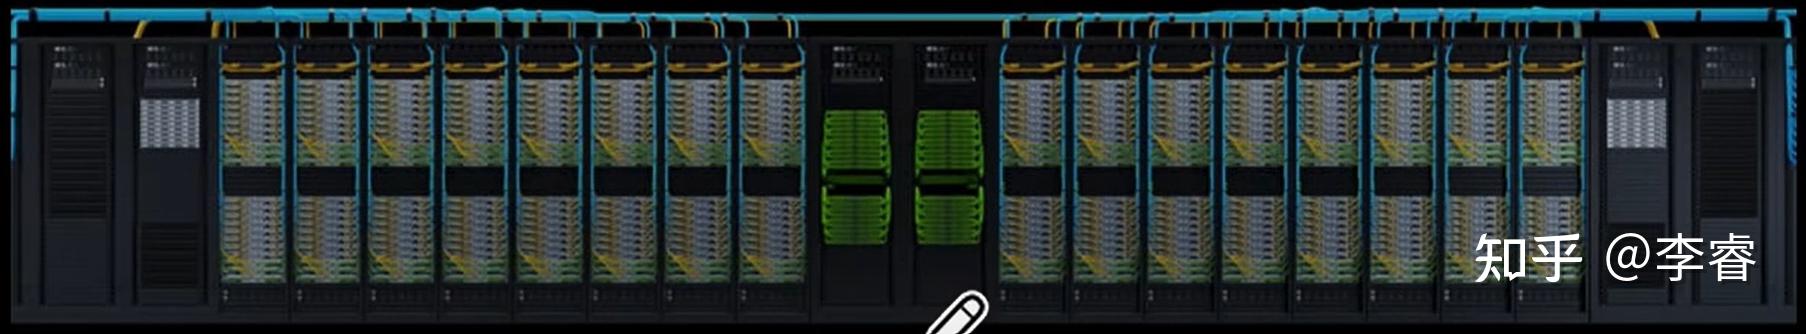 GH200 SuperPod:32 x 8-Grace Hopper SuperChip8个Hopper Compute Tray(8U),每个包含1个GH200 GPU1个ConnectX-7 IB网卡,400Gb/s1个200Gb/s以太网卡3个NVSwitch Tray(3U),共6个NVSwitchGH200 SuperPod:NVLink每个GH200和每个NVSwitch上有3个NVLink连接,每个NVSwitch上使用了24个Port每个NVSwitch有24个Port与L2 NVSwitch相连,相当于每个NVSwitch使用48个PortGH200 SuperPod由32x8-Grace Hopper Superchip组成,L1包含32x3=96 NVSwitch Tray(192个NVSwitch),L2包含36个NVSwitch Tray(64个NVSwitch)每个L1 NVSwitch Tray有24 x 2=48个Port与L2 NVSwitch Tray相连,因此需要96x48/(64x2)=36个L2 NVSwitch Tray
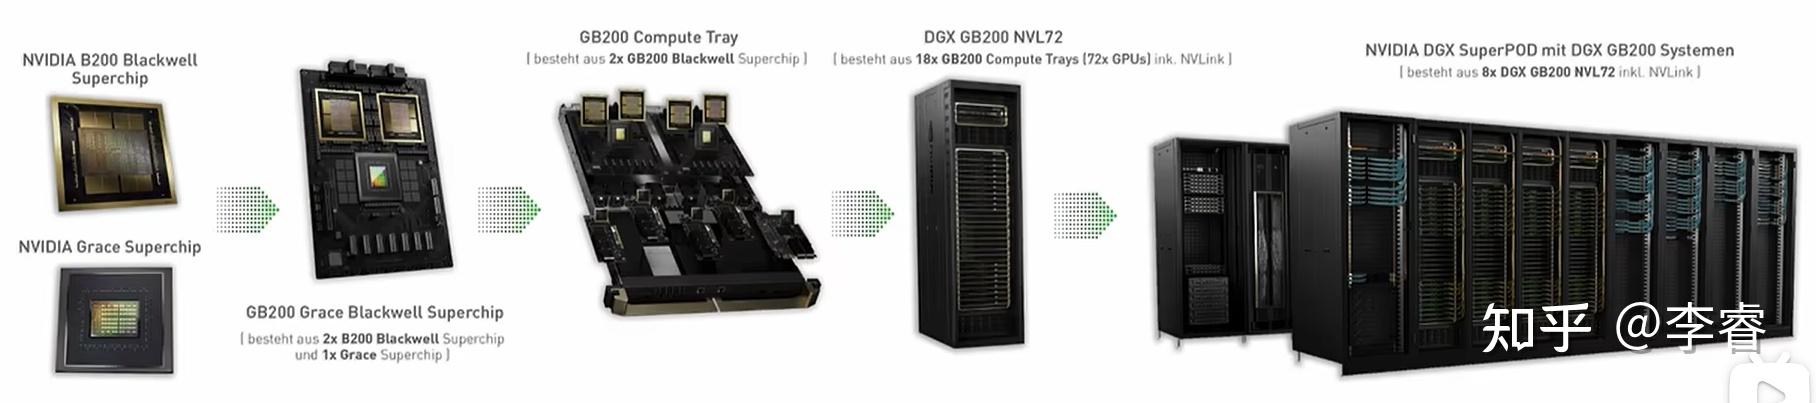
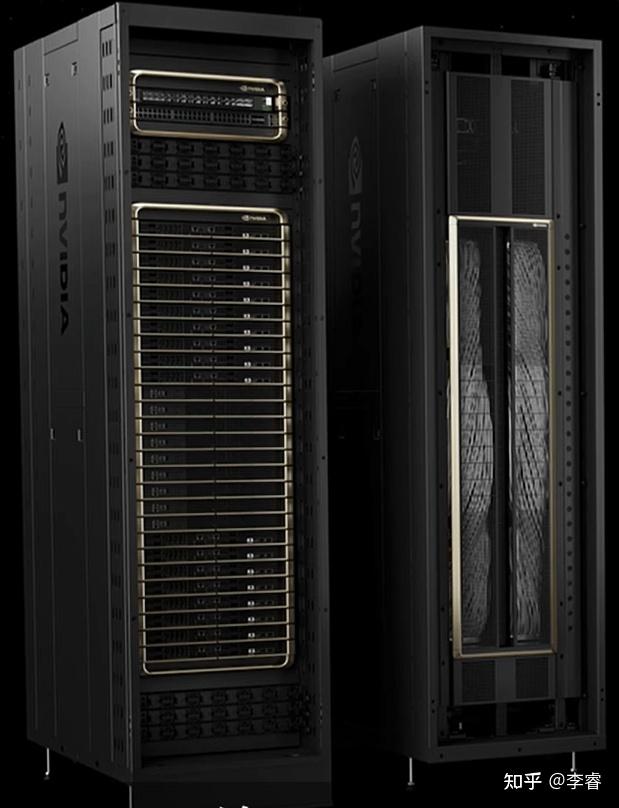
 GB200 to NVL72 & SuperPod一个GB200 NVL72 Rack包含18个GB200 Compute Tray,即36个Grace CPU + 72个GPU,9个NVSwitch Tray显存为72 x 192GB=13.8TB,CPU对应Fast Memory LPDDR5X为480GB x 36=17TB,共Fast Memory为30TB
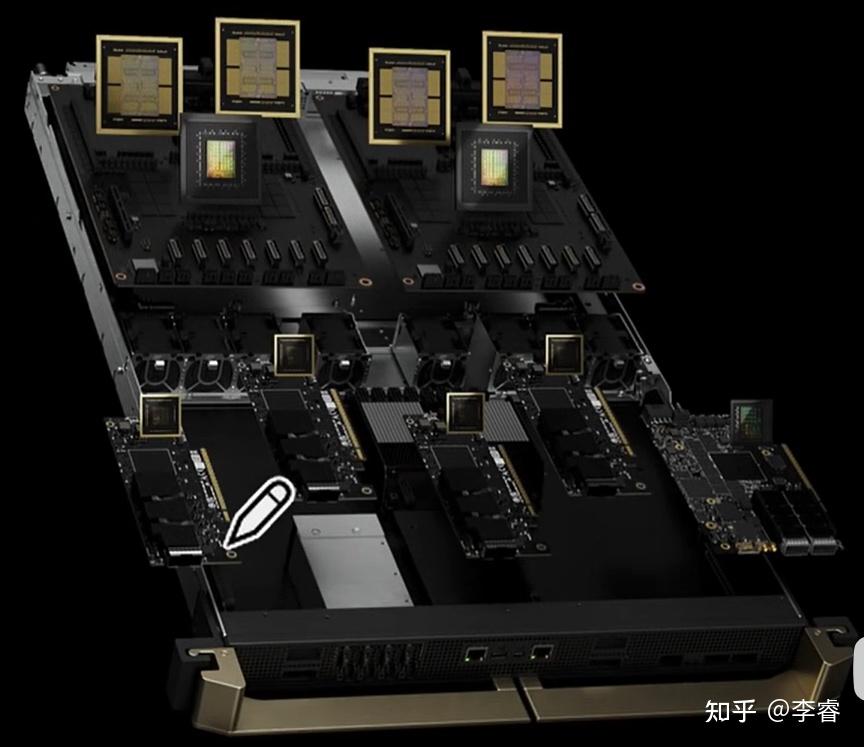
 GB200 Compute Tray基于NVIDIA MGX设计(大小为1U),一个Compute Tray包含2个GB200:2个Grace CPU、4个Blackwell GPU支持1.7TB Fast Memory,每个Blackwell显存为192GB x 4 = 768GB,1.7TB包含每个GB200额外480GB LPDDR5X,一共768GB+480GBx2 = 1728GB
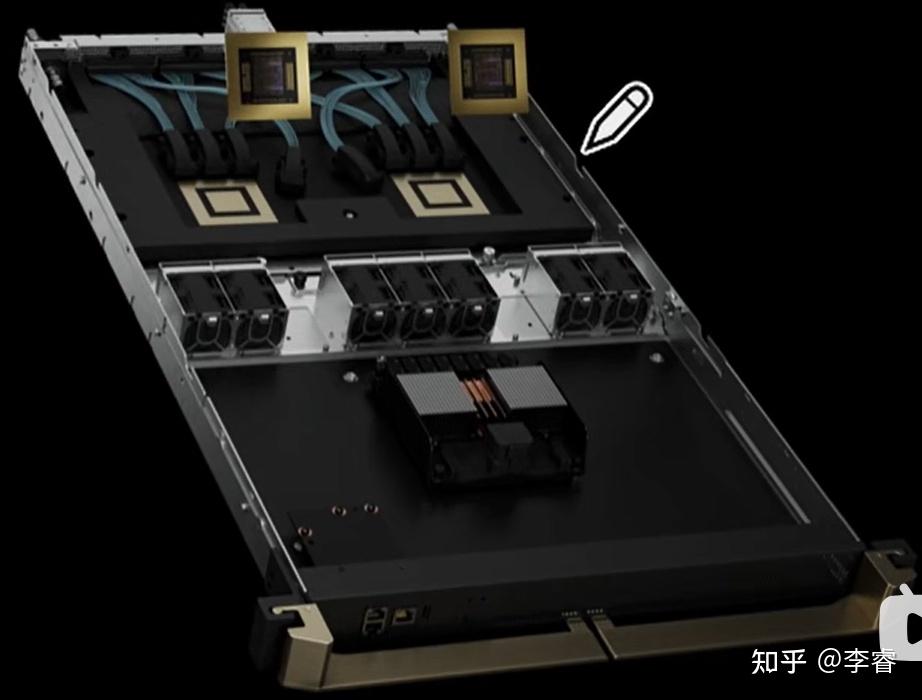
 GB200 NVSwitch Tray一个Switch Tray包含两颗NVLink Switch芯片,累积提供72 x 2 = 144个NVLink Port单颗NVSwitch芯片,上下各36个Port,带宽为7.2TB/s28.8Tbps交换容量,相对于最领先的51.2Tbps交换芯片小一些
 GB200 NVL72单个GB200子系统则包含2 x 18 = 36个NVLink 5th Port整个系统对外互联上并没有采用OSFP光模块接口,而是直接通过后置的铜线背板连接
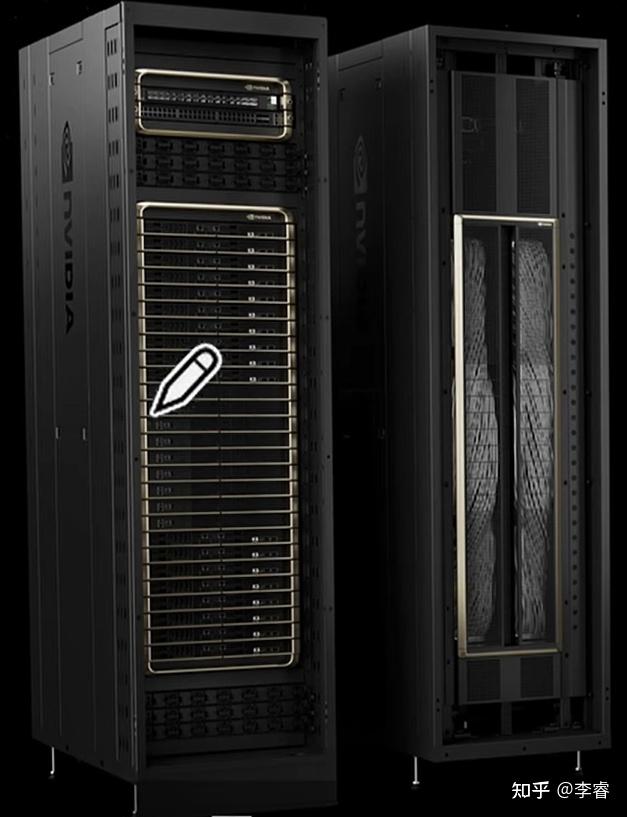 GB200 NVL72外形尺寸,需要大约120kW/机架。每机架超过40kW,因此GB200需要液冷通用CPU机架支持高达12kW/机架,而更高密度的H100风冷机架通常仅支持大约40kW/机架18个1U Compute Tray和9个NVSwitch Tray组成。每个Compute Tray高1U,包含2个Bianca板。每个Bianca板包含1个Grace CPU和2个Blackwell GPU。NVSwitch Tray有两个28.8Tb/s NVSwitch5
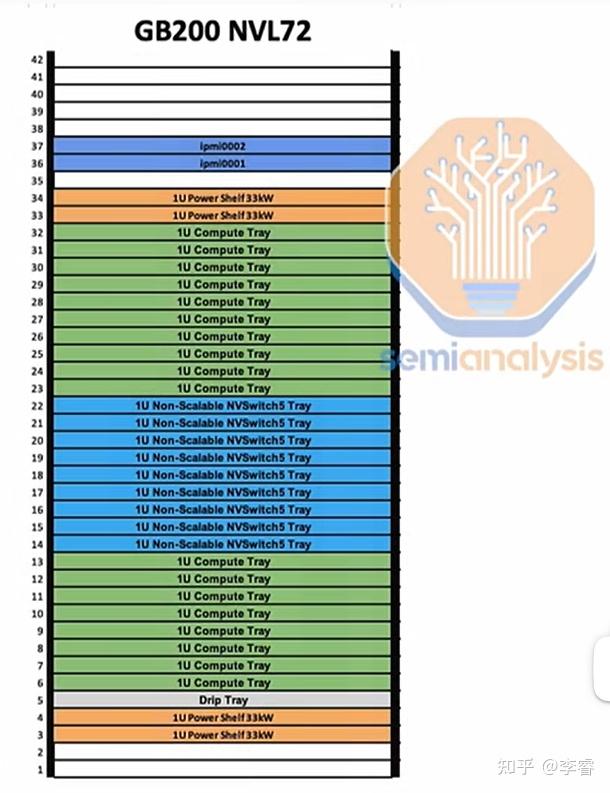 GB200 NVL36GB200 NVL36 x 2,两个并排互联在一起的机架。每个机架包含18个Grace CPU和36个Blackwell GPU在2个机架之间,仍然保持NVL72中所有72个GPU之间的无阻塞全对全每个计算托盘的高度为2U,包含2个Bianca板。每个NVSwitch托盘都有两个28.8Tb/s NVSwitch5芯片2025年第二季度将推出B200 NVL72和NVL36x2规格,将使用x86 CPU而不是NVIDIA内部的GRACE CPU这种规格称为Miranda,或可能每个计算托盘的CPU到GPU的比例将保持不变,即每个计算托盘2个CPU和4个GPU
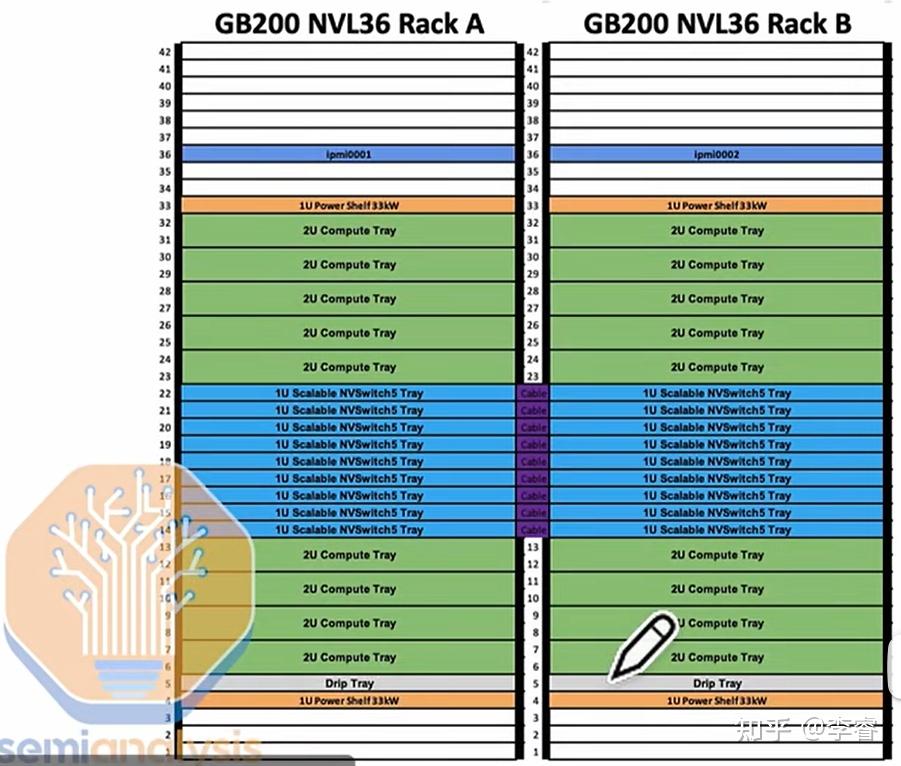 思考:H100时代大家预测光模块的需求会激增,不过很快B200时代大家改变方向了,预测后面光模块需求急剧下降,因为类似于大型机的交互时代后面选用铜互联看每一代架构演进:Hopper使用松耦合连接方式,机柜的散热和部署会相对灵活,而且同时提供HGX方式部署;B200采用大型机交付方式,铜互联能有效降低整体功耗和增加超节点内的稳定性GB200 NVL72
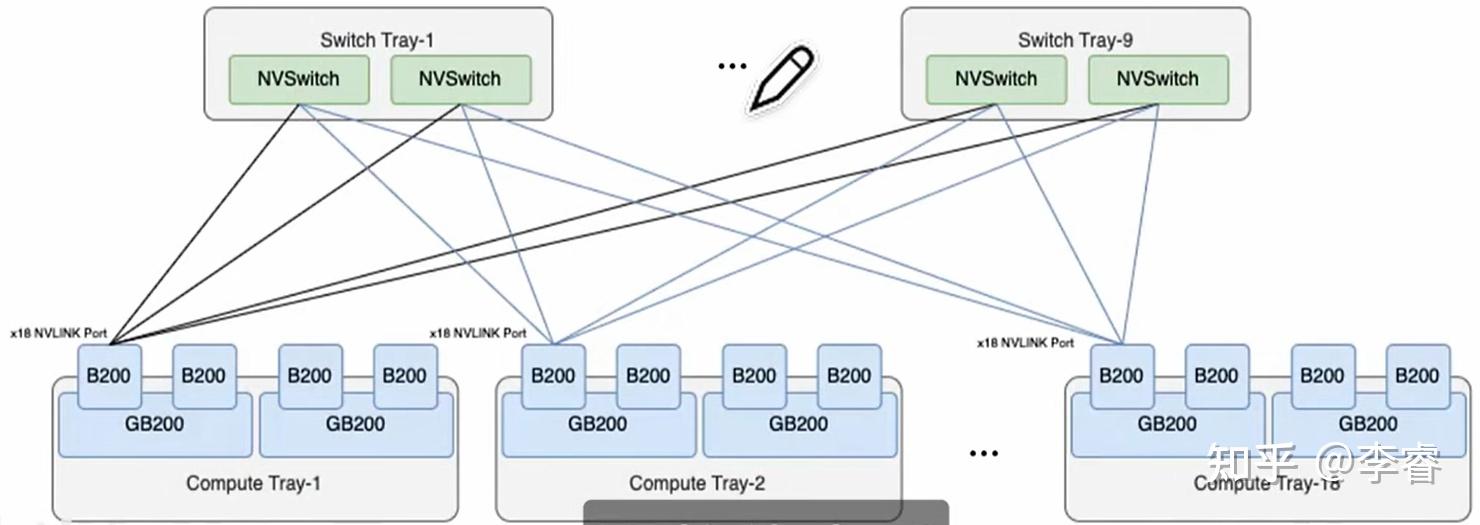
 GB200 NVL72互联拓扑每个B200有18个NVLink Port,9 x Switch Tray共计18颗NVLink Switch芯片,每个B200的Port连接一个NVSwitch芯片,Switch Tray上单NVSwitch有72个Port,刚好构成NVL72,把72 x B200芯片全部连接起来
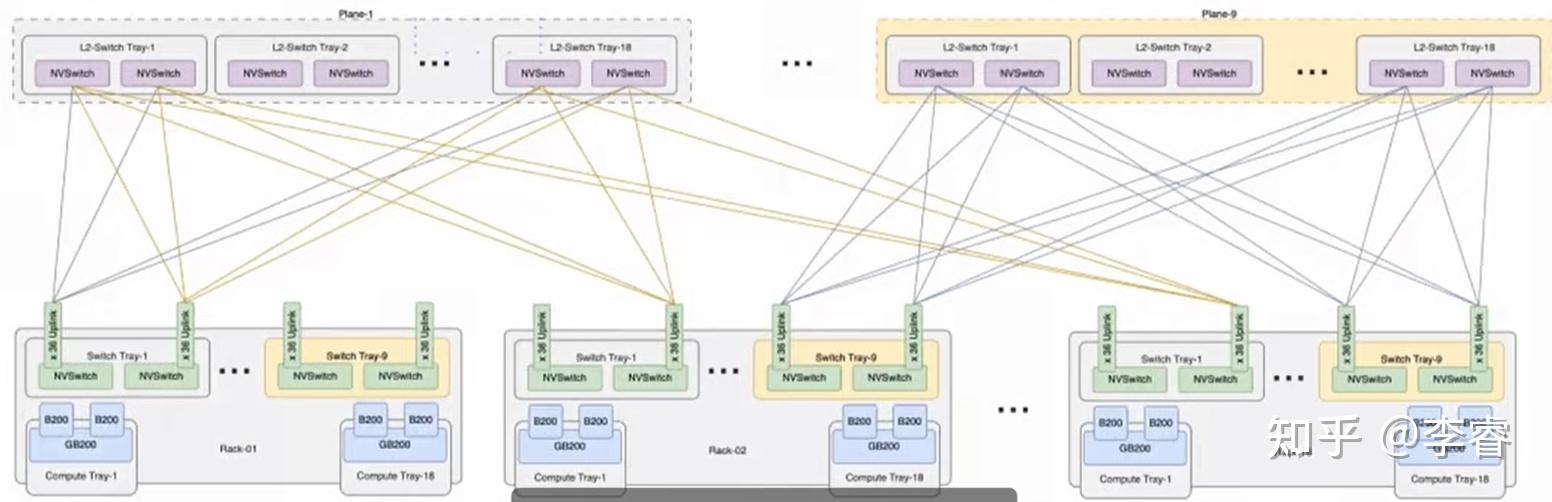
 思考:在NVL72机柜中,所有NVSwitch交换机已经没有额外接口互联构成更大规模的两层交换集群。那么NVL576(72x8)是怎么把8个NVL72链接起来的呢?通过Scale-Out RDMA网络互联,而并不是通过Scale-Up NVLink网络互联由8个NVL72组成,共576个Blackwell GPU,要实现其全互联,和上一代256个GH200全互联类似两级NVSwitch Tray:L1 NVSwitch Tray一半Port连接576个Blackwell GPU,需要576x18/(144/2)=144个NVSwitch Tray(剩余144 x 72个port)L2 NVSwitch Tray Port全部与L1 NVSwitch剩余Port连接,需要144x72/144=72个NVSwitch Tray。L2每一个NVSwitch Tray都与L1所有NVSwitch Tray连接
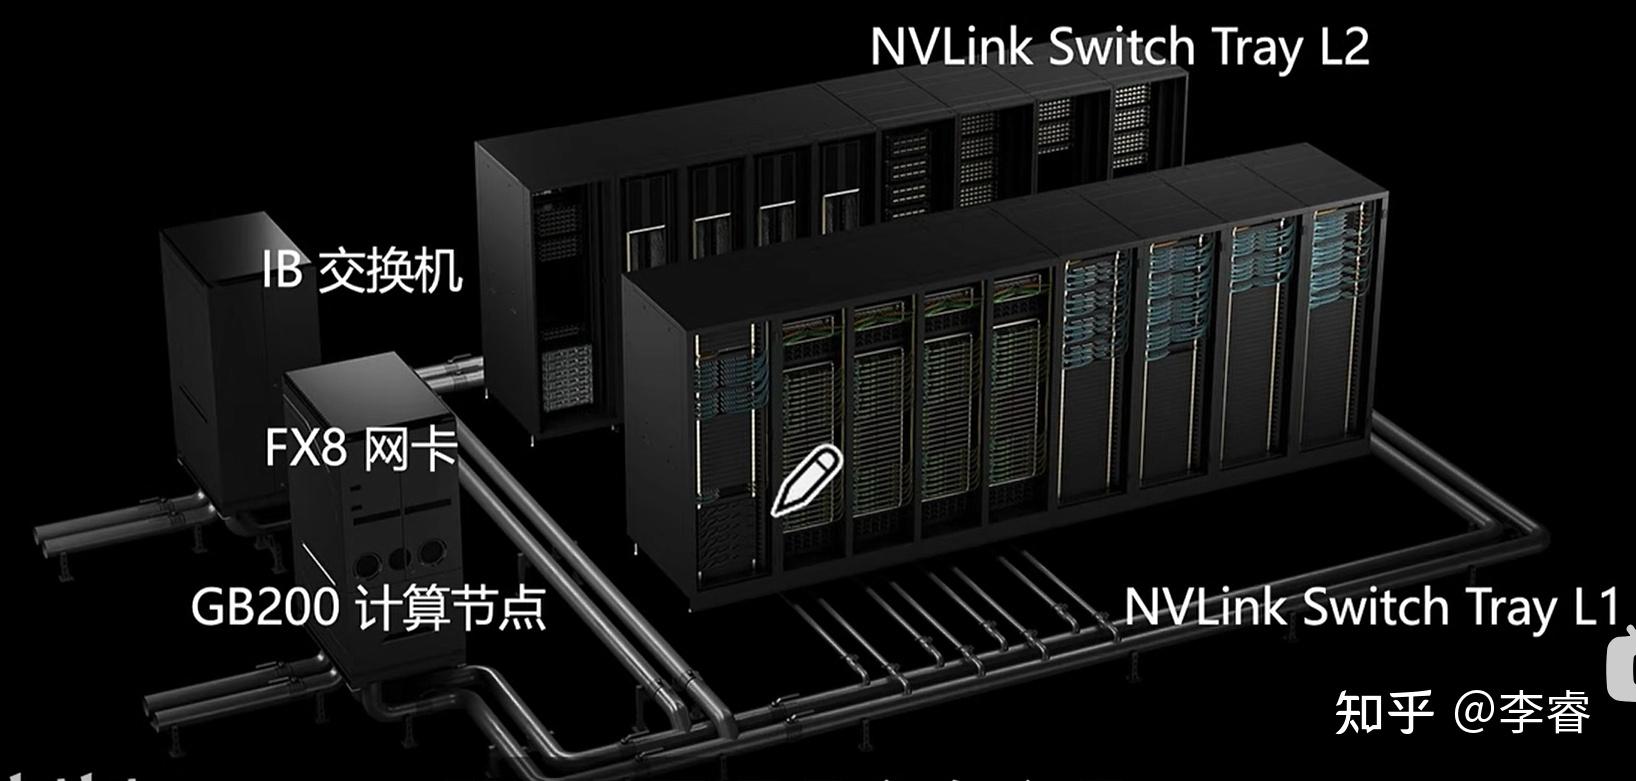 GB200 SuperPod互联拓扑为以后扩展到576卡集群,每个交换机都提供36个对外互联的Uplink,累计单个机柜有36 x 2 x 9 = 648个上行端口,构成NVL576需要有16个机柜,则累计上行端口数为648 x 16=10368个,实际上可以由9个第二层交换平面构成,每个平面内又有36个子平面,由18个Switch Tray构成
 从下一代大模型本身的算力需求来看,超节点已经成为High Bandwidth Domain,当Scale-Up的NVLink网络规模增大时,实际HBD之间互联RDMA带宽带来的性能收益在减小,所以SuperPod的需求量到底有多大?到底会不会迎来思科时刻?分析1:制造工艺对性能提升有限单Die GPU性能并没有大幅提升,NV代际间受先进工艺限制约束:先进工艺代际升级时间长(2~3年)代际间单芯片面积性能提升~15%,功耗提升35%分析2:封装能力提升解决工艺提升慢拼封装技术的时代,从传统单die主处理芯片,演进到双Die合封HBM实现多Die和多层合封技术,解决内存墙问题多Die合封实质上是在解决工艺发展受限分析3:引入Tray板卡概念Nvidia不仅使用封装来解决部件性能瓶颈,也运用板卡(Tray)概念Hopper板卡支持1CPU+1GPUBlackwell板卡支持1CPU+2GPU,同制造工艺下算力增加4倍+,单GPU包括两Die主芯粒分析4:网络带宽提升NVLink交换机端口数和单端口带宽都增加了1倍,为更大规模NVLink组网提供支撑单柜支持72GPU组网(NVL72),SuperPod支持576GPU组网(NVL576)中等规模微调大模型,NVL72+1B可实现千卡互联更有性价比优势大规模训练大模型,NVL576+1B+Internet可以组成万卡超级集群分析5:网络带宽提升弥补计算性能Serdes当前224Gbps继续提升到336或448单芯片NVLink数量再提升1倍,如从现在18提升到36单柜集群实现72 to 144 GPU超级互联,计算密度继续提升1倍,带宽提升4倍分析6:交换机端口数更多,以支持更大规模集群,交换机端口数量越多越能减少层级数,这不仅可以减少网络跳数,还可以提升单柜的计算密度NV未来还会享受先进工艺的红利,可以持续发展多年。并且,光通信这一块的能力,还有待进一步释放,包括芯片内光互联,芯片直接出光等GPU H100液冷机架GPUColossus目前部署10万NVIDIA Hopper GPU,包括5万个H100和5万个H200Colossus基本构建模块是超微液冷机架,每个机架配备8台4U服务器机架配置每台服务器搭载八块NVIDIA H100 GPU,这样每个机架总共有64块GPU每个机架可容纳64个GPU,8个机架组成一个阵列,共计512个GPUColossus共有超过1500个机架,接近200个阵列每个服务器配备了4个电源,这些电源支持热插拔,并通过三相PDU进行供电超微液冷GPU服务器CPU Tray配备2个x86 CPU液冷块 + 一个用于冷却4个Broadcom PCIe交换机的定制液冷块可维护性超微系统采用可维护托盘设计,每个服务器配备了4个热插拔电源1U机架歧管设计有助于引入冷却液和排出热液部件被移除后,托盘便可以轻松拉出进行维护网络在机架背面,有用于GPU & CPU连接的400GbE光纤,以及用于管理网络的铜缆每个节点配备9个400GbE(Gigabit Ethernet)网络连接,总带宽达到3.6Tbps8个NVIDIA BlueField-3 SuperNIC用于AI网络1个Mellanox ConnectX-7网卡提供CPU端其他网络功能NVMe存储系统规模EB级存储介质NVMe SSD服务器超微1U服务器特点满足AI大模型训练对存储容量需求通过网络交付,供所有GPU和CPU服务器访问CPU计算集群服务器超微1U服务器,每机架42台CPU采用高速x86 CPU,具体型号未知网络每个服务器配备一个400GbE网卡散热CPU服务器采用风冷设计,通过机架后部的热交换器将热量传递到液冷回路中以太网互联参数面网络互联(GPU/NPU中训练的一个权重的参数)技术400GbE以太网,NVIDIA Spectrum-X网络解决方案,支持RDMA交换机NVIDIA Spectrum-X SN5600以太网交换机,每个交换机有64个端口支持800Gb/s速度,并可分割成128个400GbE链路网卡NVIDIA BlueField-3 SuperNIC,为每个GPU提供专用RDMA网络连接业务面网络互联(控制面和对外的一个接口)技术采用400GbE以太网,64端口800GbE以太网交换机特点以太网而非InfiniBand等技术,以太网具有更好可扩展性,满足万卡规模scale out需求GPU网络和CPU网络分离,以确保高性能计算集群最佳性能风水火电GPU Rack冷却系统散热方式液冷CDU冷却液分配单元机架底部有CDU(冷却剂分配单元)和冗余泵系统冷却液循环冷却液通过机架分配管道进入每个服务器CDU分配器CDU类似于大型热交换器,每个机架内都设有一个流体循环系统,为所有计算节点提供冷却服务其他仍保留风扇系统,用于冷却内存、电源单元、主板管理控制器、网卡等低功耗组件其他冷却系统CPU服务器、网络设备和存储系统风冷散热,通过机架后部的热交换器将热量传递到液冷回路中热交换器类似于汽车散热器,通过风扇将热空气抽过散热片,并将热量传递给循环水机房采用冷水循环系统,CDU将热量传递到循环水中,热水在设施外部冷却后循环利用供水管道将冷水引入设施,并循环流经每机架CDU,吸收热量后,热水被引导至设施外部冷却装置十万卡AI集群的思考构建十万卡集群是一项复杂的系统工程不仅意味着算力指数级增长,还涉及复杂的技术和运营挑战需要解决高效能计算、高能耗管理、高密度机房设计、高稳定性训练等一系列问题最终能否将算力有效释放,还取决于算法、软件架构的优化与调度能力十万集群目标谁在建多个大型AI实验室(OpenAI/微软、xAI、Meta)竞相建立>10万卡AI集群有什么用AI下一步利用海量多模态数据,训练超大规模参数大模型算力对比通过对标GPT-4训练来了解10万卡AI集群能提供多少算力OpenAI~2万块A100上对GPT-4持续训练90~100天(FP16 2.15x1025 FLOPs),集群峰值吞吐为6.28 BF16 ExaFLOP/s如果使用10万卡H100集群,峰值吞吐可以飙升至198/FP8 or 99/FP16 ExaFLOP/s,与2万卡A100集群相比,AI集群训练算力可提升31.5倍思考:GPT4在2023年6月发布,OpenAI GPT-4完成一次训练约3个月时间,使用25k NVIDIA A100GPU。如今已经十万卡H100集群,为什么到现在为止还没有出现超越GPT4的模型大模型训练不是堆算力就能解决,但是不堆算力绝对解决不了单芯片算力能力研发单GPU更多并行处理核心,努力提高运行频率通过优化高速缓存,减少GPU访存延迟,于是越来越多近存计算的新架构出现优化浮点数表示格式,探索从FP16到FP8/HiF8浮点数表示格式,芯片引入新计算精度超节点计算能力提高万卡集群NPU卡间互联的网络利用率和模型利用率(MFU),实现通信时延减少,带宽能力跃升,支持更高频次、更大带宽和更低延迟通信特性:NPU节点内集成类scale up能力Switch芯片,优化卡间南向互联效率和规模,增强TP/PP/SP等数据传输能力引入节点内Switch芯片,增强卡间P2P带宽,有效提升节点内网络传输效率,满足大模型互联和带宽的增长需求对NPU卡间互联协议进行系统性优化和重构,以提升All2All下通信效率,如华为的灵渠总线架构协议、AMD、Google组成的UALink重新设计NPU卡间数据报文格式,引入CPO/NPO,提高和优化SerDes传输速率、优化网络拥塞控制/重传机制网络计算能力DPU上实现存储后端接口,基于RDMA网络功能连接块存储集群、对象存储集群、以及文件存储集群降低多机多卡间端到端通信时延,提升多机间端到端通信带宽,构建节点间数据交换的高速通道AI计算场景流量特征是流数少、单流带宽大,端口级负载均衡技术或算网协同负载均衡技术能提供更好的吞吐智能管控统一对计算、存储、网络、光模块等进行资源、性能、告警、日志、拓扑等信息采集提供资源管理、服务编排、监控、作业运维等功能,实现AI集群智能运维环境健康检查、作业故障诊断、集群环境/资源环境、服务器管理以及监控分析等云化能力功耗挑战耗电十万卡AI集群资本支出>40亿刀,AI集群通过集中部署来利用芯片与芯片间高速网络能力,因此受到IDC功耗和电力不足严重限制一个10万卡AI集群需要>150MW功耗容量,并且每年耗费1.59TWh电量,按0.078$/kw标准费率来计算,每年电费高达1.239亿刀
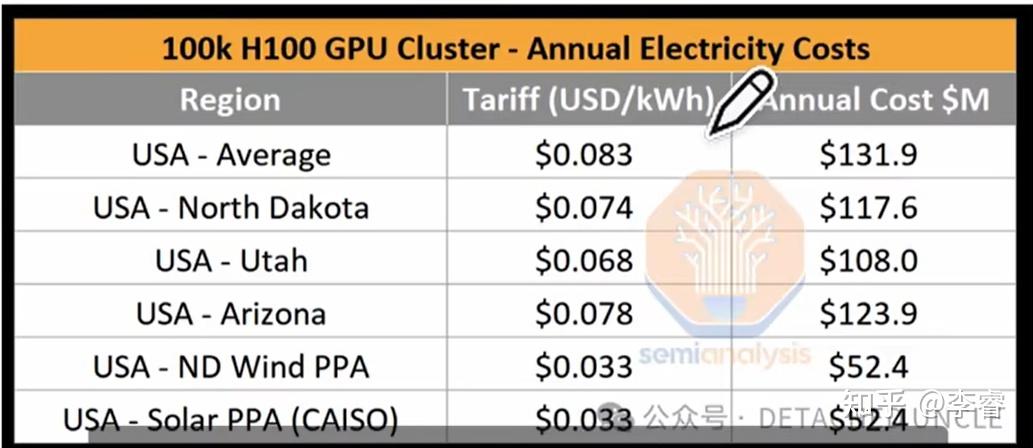 单卡GPU能耗为700W,每个H100节点,CPU、网络接口卡(NIC)和电源装置(PSU)额外增加每GPU 400~500W节点外,AI集群还需要存储服务器、网络交换机、CPU节点、光模块和其他设备,总能耗约占IT能耗10%建设10万卡AI集群时,通常指一片园区内部署,而不是单栋建筑内部部署xAI将田纳西州孟菲斯旧工厂改造成智算中心网络互联挑战光模块传输距离AI集群通过光模块互联,而光模块成本与覆盖范围成正比多模SR和AOC光模块支持~50m传输距离,长距离单模DR和FR光模块支持500m~2km信号DR是SR多模光模块~2.5倍成本,园区级相干光模块传输距离能>2千米,但价格>10倍以上
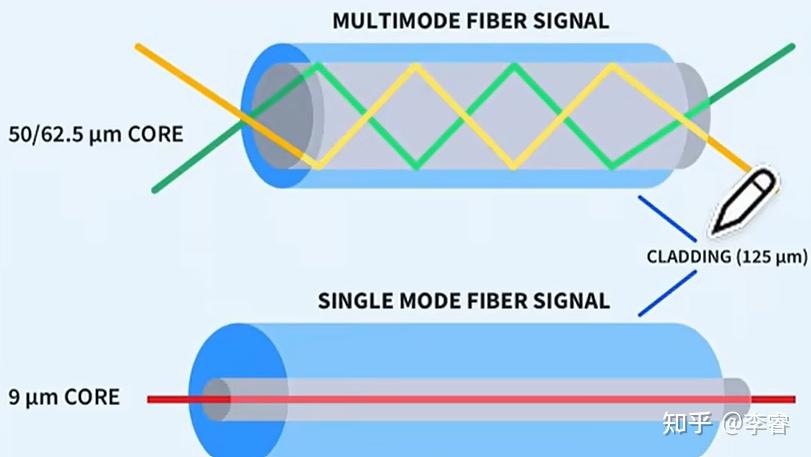 岛内和岛外互联的选择H100小集群通常只使用多模光模块,通过一到两层交换机网络实现400G带宽卡间互联一般每栋楼包含一个或多个计算节点,它们之间用铜缆和多模光模块进行连接较长距离光模块来实现岛(island)际互联,计算岛内具备高速带宽,计算岛外带宽较低
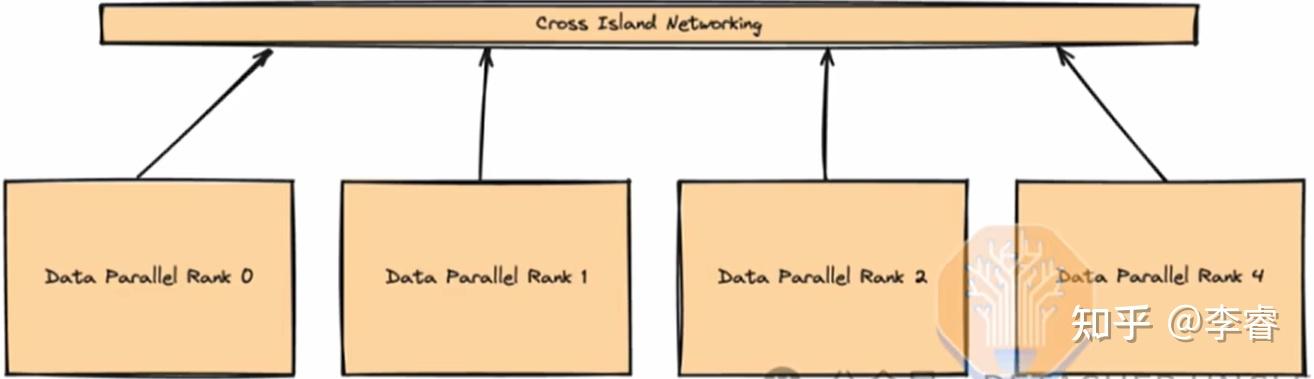 Meta 3.2万卡GPU集群中,设计8个全速带宽计算岛,计算岛之上一层交换机网络带宽过载比为7:1,岛际互联网络速度比岛内网速慢7倍
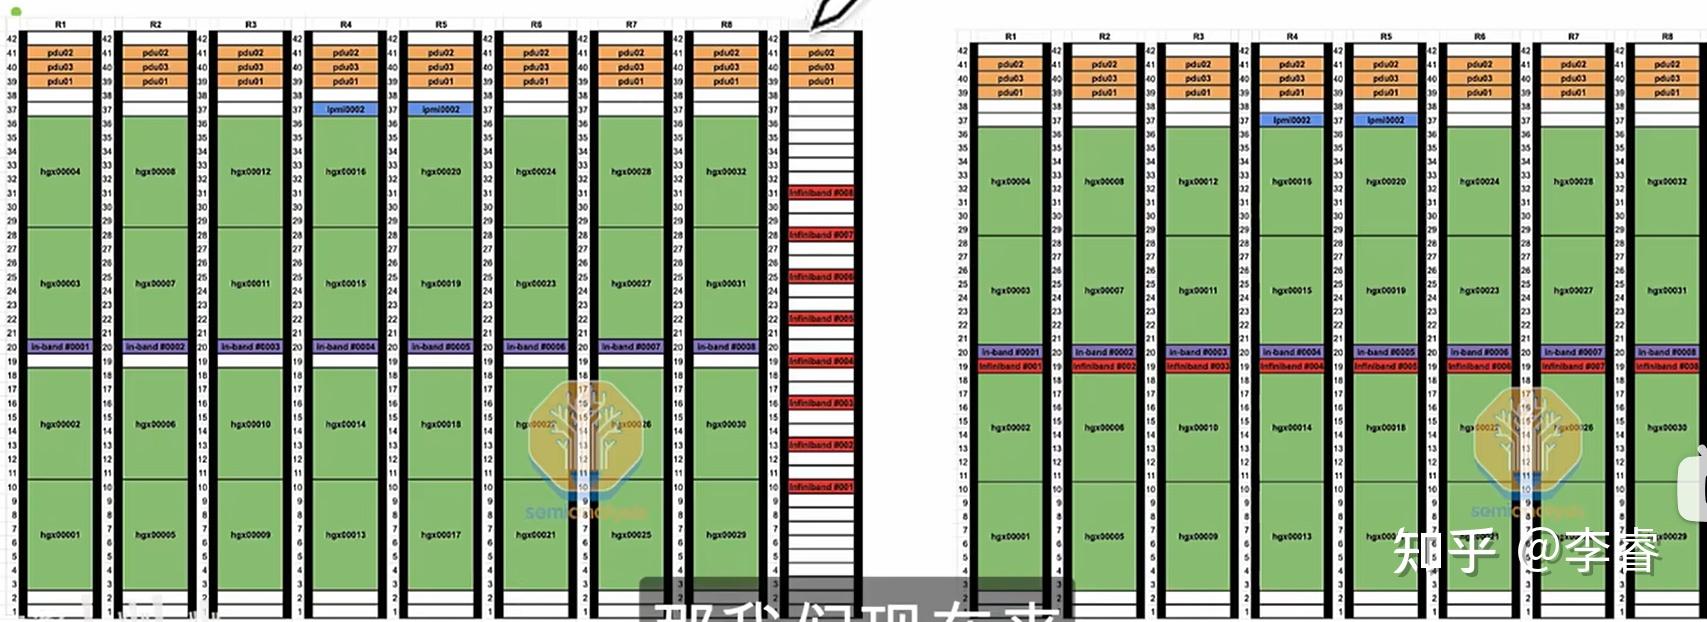
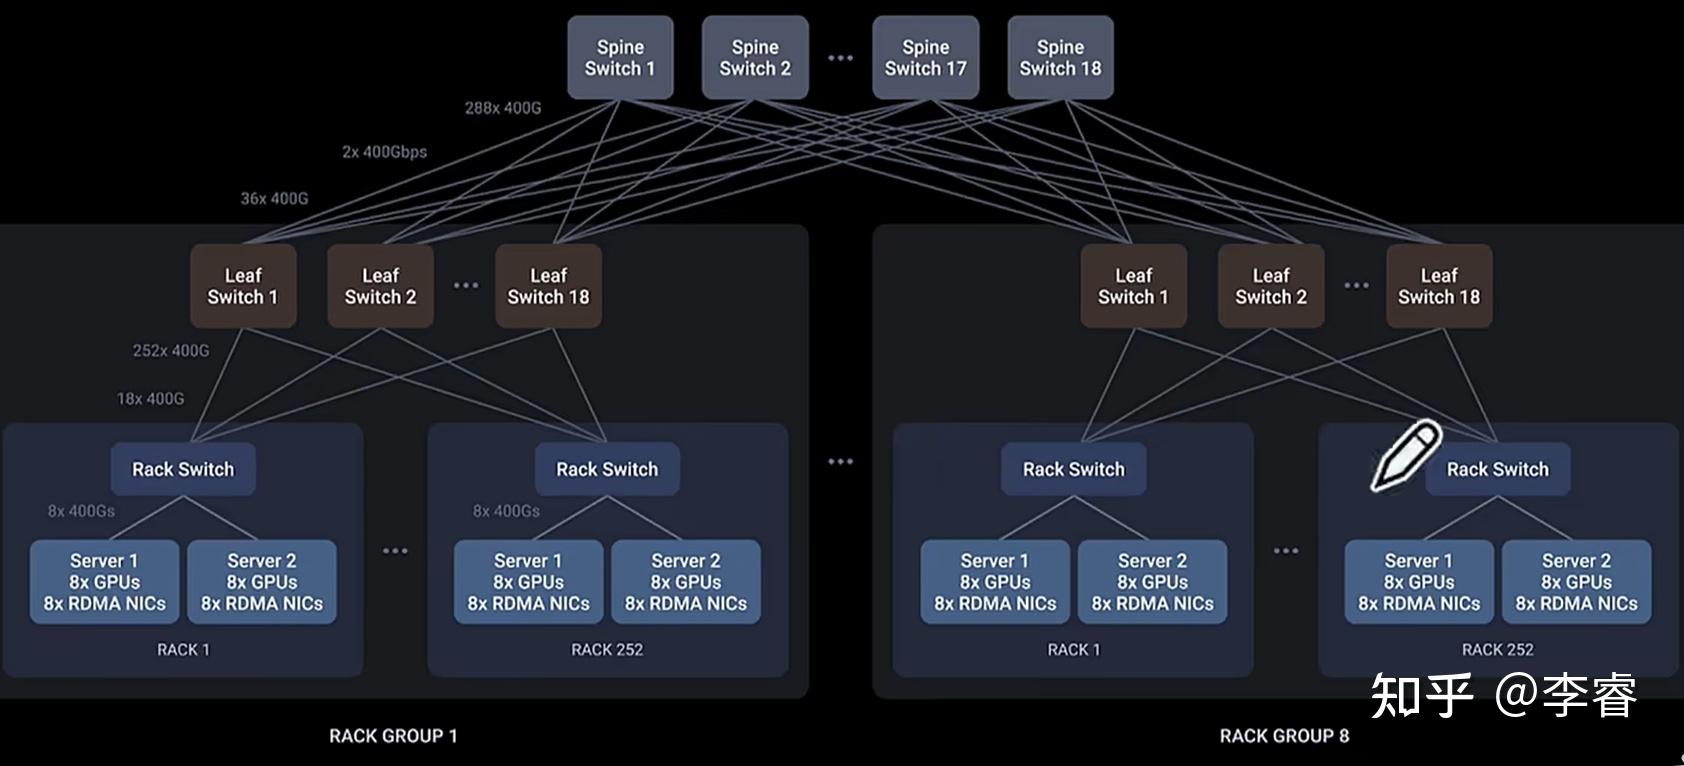 轨道优化(Rail Optimized)& 中间机架(Middle of Rack)为提高可维护性并增加铜缆网络(连接距离<3m)和多模网络(连接距离<50m),部分不采用轨道优化设计,转而采用中间机架设计
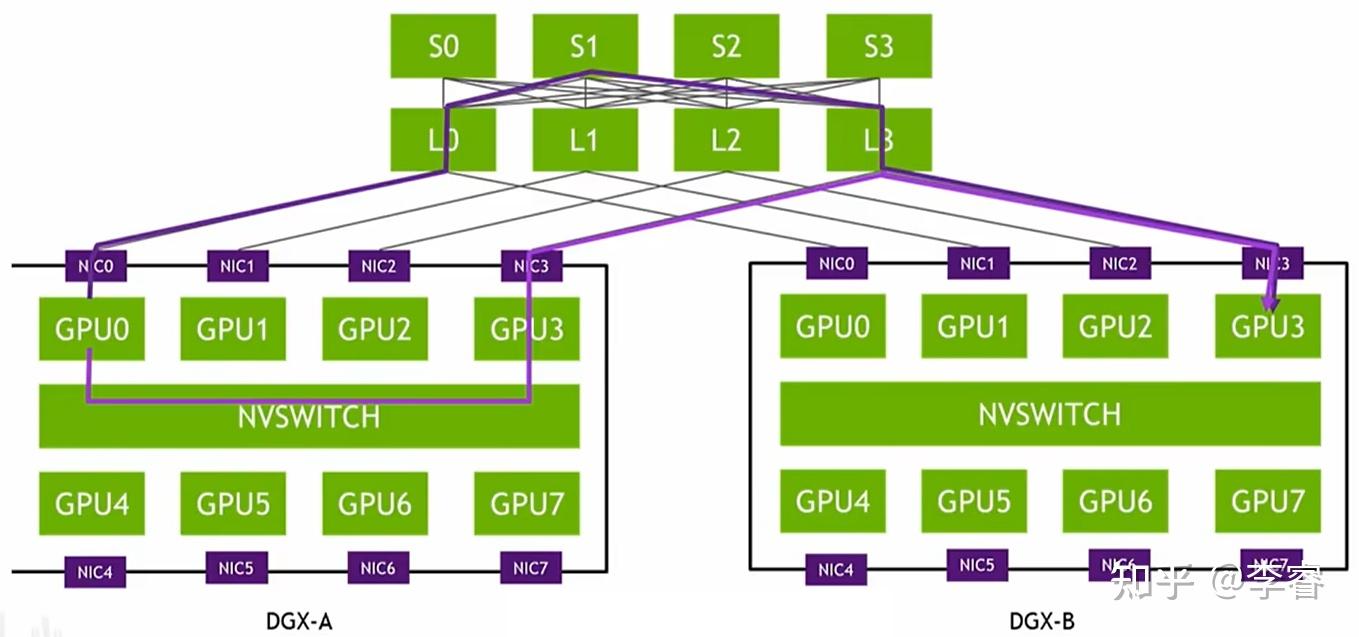 Middle of Rack交换机在IDC机柜上部署位置,分为机柜顶部(Top of Rack)、机柜中部(Middle of Rack)、机柜底部(Bottom of Rack)多轨优化让每台H100节点连接到8个不同叶交换机,每个GPU只需1个交换跃点(switch hop)就能与另外GPU通信
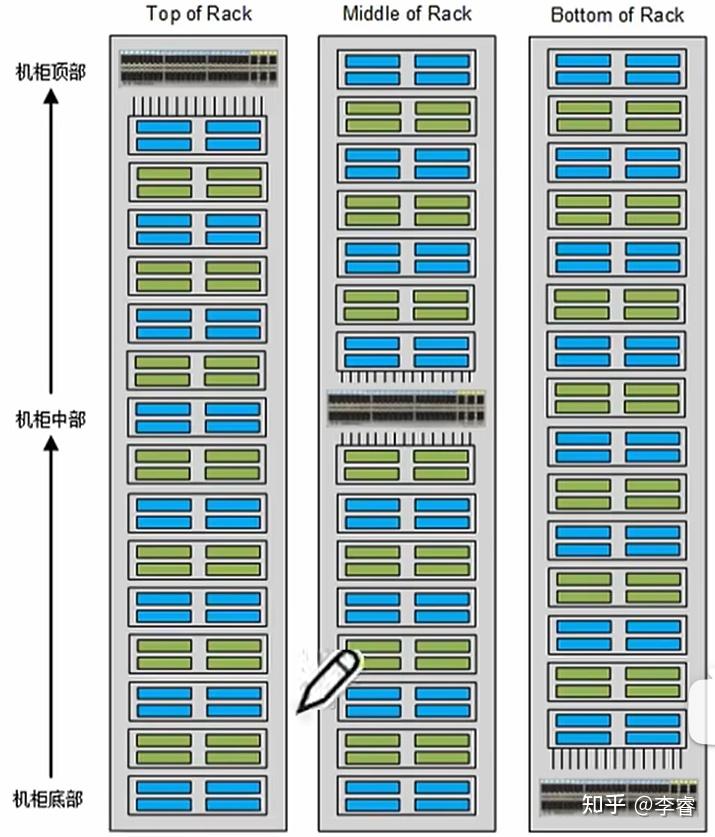 缺点是节点中8块GPU必须连接到不同距离叶交换机,而不是更靠近服务中间机架上单轨方案:当交换机位于同一机架时,可以使用无源直连电缆(DAC)和有源电缆(AEC)多轨方案:交换机不一定位于同一机架,必须使用光模块,此外,叶交换机到脊交换机的距离可能>50m,必须使用单模光模块使用无轨优化的中间机架设计,可以用更廉价的铜缆取代连接GPU和叶交换机的光模块,在GPU网络中实现25%~33%铜缆覆盖每个GPU与叶交换机连接不再是先连接到电缆托架,再从侧面穿过9个机架连接到专用的导轨优化叶交换机上将叶交换机放在机架中间,从而让每个GPU都能使用DAC铜缆DAC电缆运行温度更低、能耗更低、可靠性更高,实现更少flapping(网络链路间歇性瘫痪)和故障
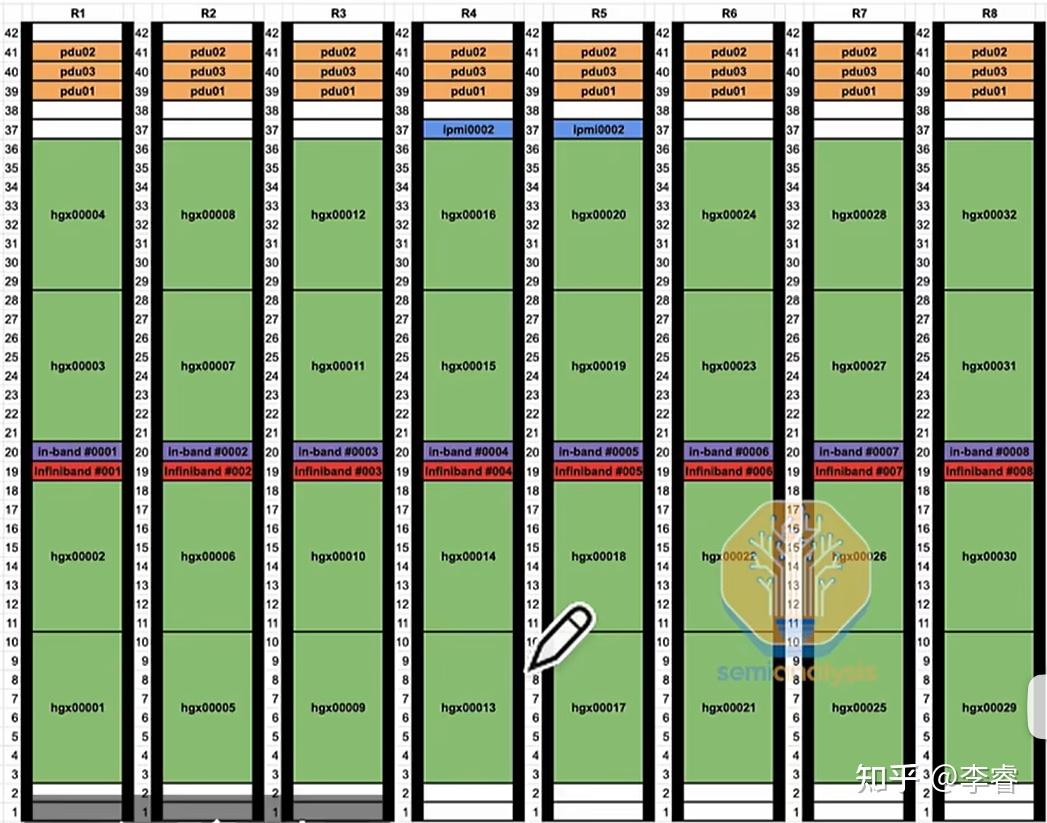 对比一个Quantum-2 IB Spine交换机,使用DAC铜缆耗电~747W,使用多模光模块时,能耗会增加到1500W
 故障恢复与运维可靠性问题GPU HBM ECC错误、GPU驱动器卡死、光模块故障、网卡过热以及计算节点宕机或出错等训练时为防止HBM ECC等错误,需要对CPU内存或NAND SSD进行Checkpoint检查